몽고 DB 컨퍼런스
- 추가적으로 궁금한 내용이 있다면 아래 QR을 통해 MongoDB University의 무료 교육을 지원받을 수 있다고 한다.
MongoDB 8.0: 코드는 그대로, 속도는 UP
처음 부분은 신기능에 대한 세일즈 부분이지만 개발팀으로 알고 있으면 좋을 점이 있어 공유한다.
MongoDB 8.0의 핵심은 “성능 향상”이다. 개발자가 코드를 바꾸지 않아도, 데이터베이스 자체가 업그레이드되어 더 빨라졌다는 것을 의미한다. 가장 큰 변화는 두 가지다.
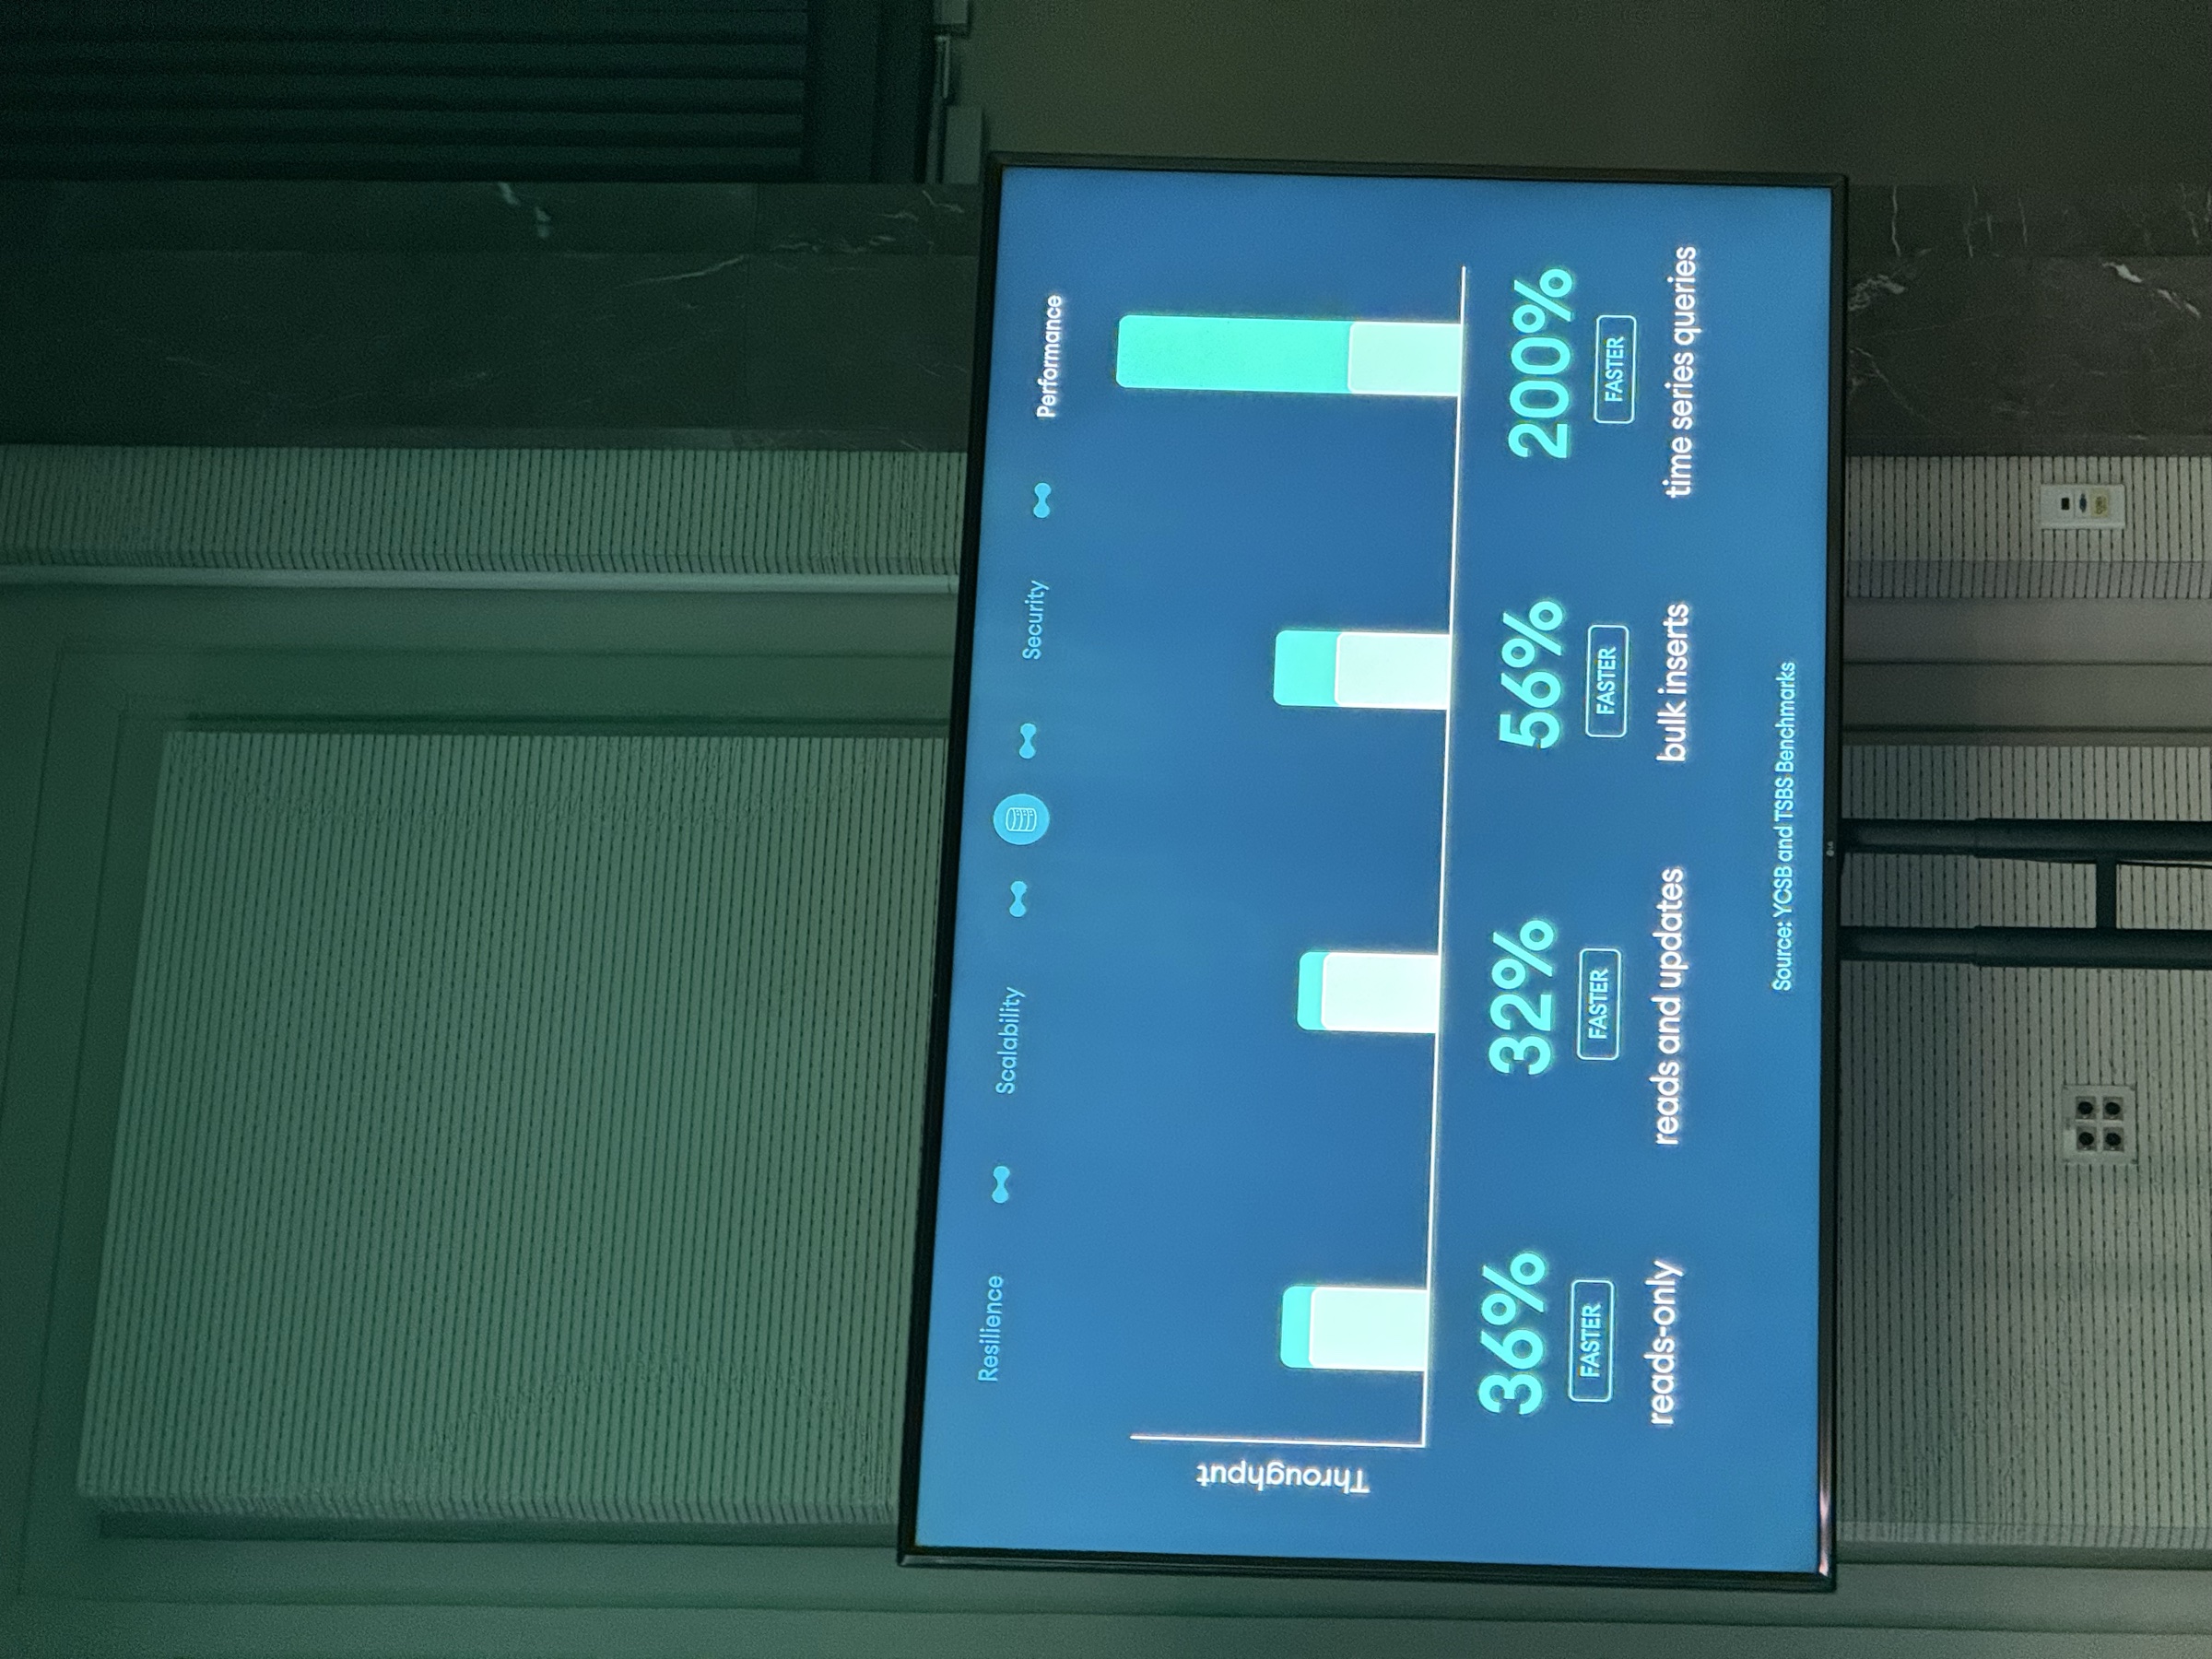
1. 내부 처리 과정 37% 단축
데이터를 읽어오는 내부 명령 실행 경로에서 불필요한 단계를 제거해 처리 속도를 크게 높였다. 마치 목적지까지 가는 길에 있던 신호등과 비보호 좌회전을 없애고 직선 도로를 뚫어준 것과 같다.
2. 자주 쓰는 쿼리 성능 대폭 향상 (Express Path 최적화)
가장 체감이 큰 부분은 단일 문서를 찾는 쿼리가 매우 빨라졌다는 점이다.
**findById**가 17% 더 빨라졌어요!
_id를 사용해 문서를 찾는 것은 MongoDB에서 가장 흔한 작업 중 하나다. 공유해준 코드처럼 우리 프로젝트에서도 많이 사용한다.
TypeScript
MongoDB 8.0으로 업데이트하는 것만으로 이 코드들의 성능이 자동으로 향상된다.
’모든 필드 매치 지원’이 뭔가요?
이것이 바로 이번 성능 향상의 핵심이다. 아주 쉬운 예시로 설명한다.
도서관 사서를 생각해보자.
- 이전 버전 (전문 사서): 이 사서는
도서 관리 번호(_id에 해당)로 책을 찾는 데는 전문가다. 번호를 주면 즉시 찾아온다. 하지만책 제목이나저자 이름으로 찾아달라고 하면, 색인 카드를 뒤적이는 등 조금 더 복잡하고 느린 방법으로 찾아야 했다. - MongoDB 8.0 (만능 사서): 이제 이 사서는 특수 훈련을 받았다.
도서 관리 번호든,책 제목이든,저자 이름이든 어떤 정보로 물어봐도 똑같이 빠르고 효율적인 방법(Express Path)으로 책을 바로 찾아온다. 즉, ’모든 필드 매치 지원’이란_id로 조회할 때만 적용되던 빠른 길이 이제는 어떤 필드로 조회하든 똑같이 적용된다는 의미다.
TypeScript
결론적으로, 이제는 findById 뿐만 아니라 findOne({ email: ... }) 이나 findOne({ name: ... }) 같은 다양한 쿼리들도 별도의 최적화 없이 자동으로 빨라지는 큰 이점을 얻게 된 것이다.
쓰기 성능 - 복제와 대량 처리의 혁신
쓰기 기능에서 클러스터 복제 과정이 훨씬 효율적으로 바뀌었다. 특히 우리에게 중요한 점은 대량 쓰기(bulk write) 성능이 56% 향상되었다는 것이다.
매일 엑셀 파일로 처리하는 대량 상품 업데이트 작업을 예로 들 수 있다.
TypeScript
이처럼 기존 코드를 전혀 바꾸지 않아도, MongoDB 8.0을 사용하는 것만으로 대량 데이터 처리 속도가 크게 향상된다.
시계열 데이터 - 200% 성능 향상의 비밀
시계열 데이터 처리 성능은 200% 이상 향상되었다. 이전에는 데이터를 하나씩 처리했다면, 이제는 여러 데이터를 한 묶음으로 처리(batch approach)하는 방식으로 바뀌었기 때문이다.
이는 마치 택배 기사가 물건 하나 배송할 때마다 물류센터에 다녀오는 대신, 한 동네 물건을 모두 모아서 한 번에 배송하는 것과 같다. 이 방식으로 실시간 주문 데이터나 사용자 행동 로그 같은 시계열 데이터의 집계 쿼리 속도가 극적으로 빨라졌다.
시계열 데이터(Time-Series Data)란 무엇인가?
- 시계열 데이터란 시간의 흐름에 따라 순서대로 기록된 데이터의 집합을 말한다. 모든 데이터 포인트는*타임스탬프(Timestamp)를 가지며, 이 시간 정보가 데이터의 가장 중요한 축이 된다. 주식 시장의 가격 변동 차트나 환자의 심박수 기록 그래프를 생각하면 쉽게 이해할 수 있다.
TypeScript
이러한 성능 향상 덕분에 IoT, 금융 분석처럼 데이터가 끊임없이 쏟아지는 환경에서도 적은 리소스로 빠른 분석이 가능해진다.
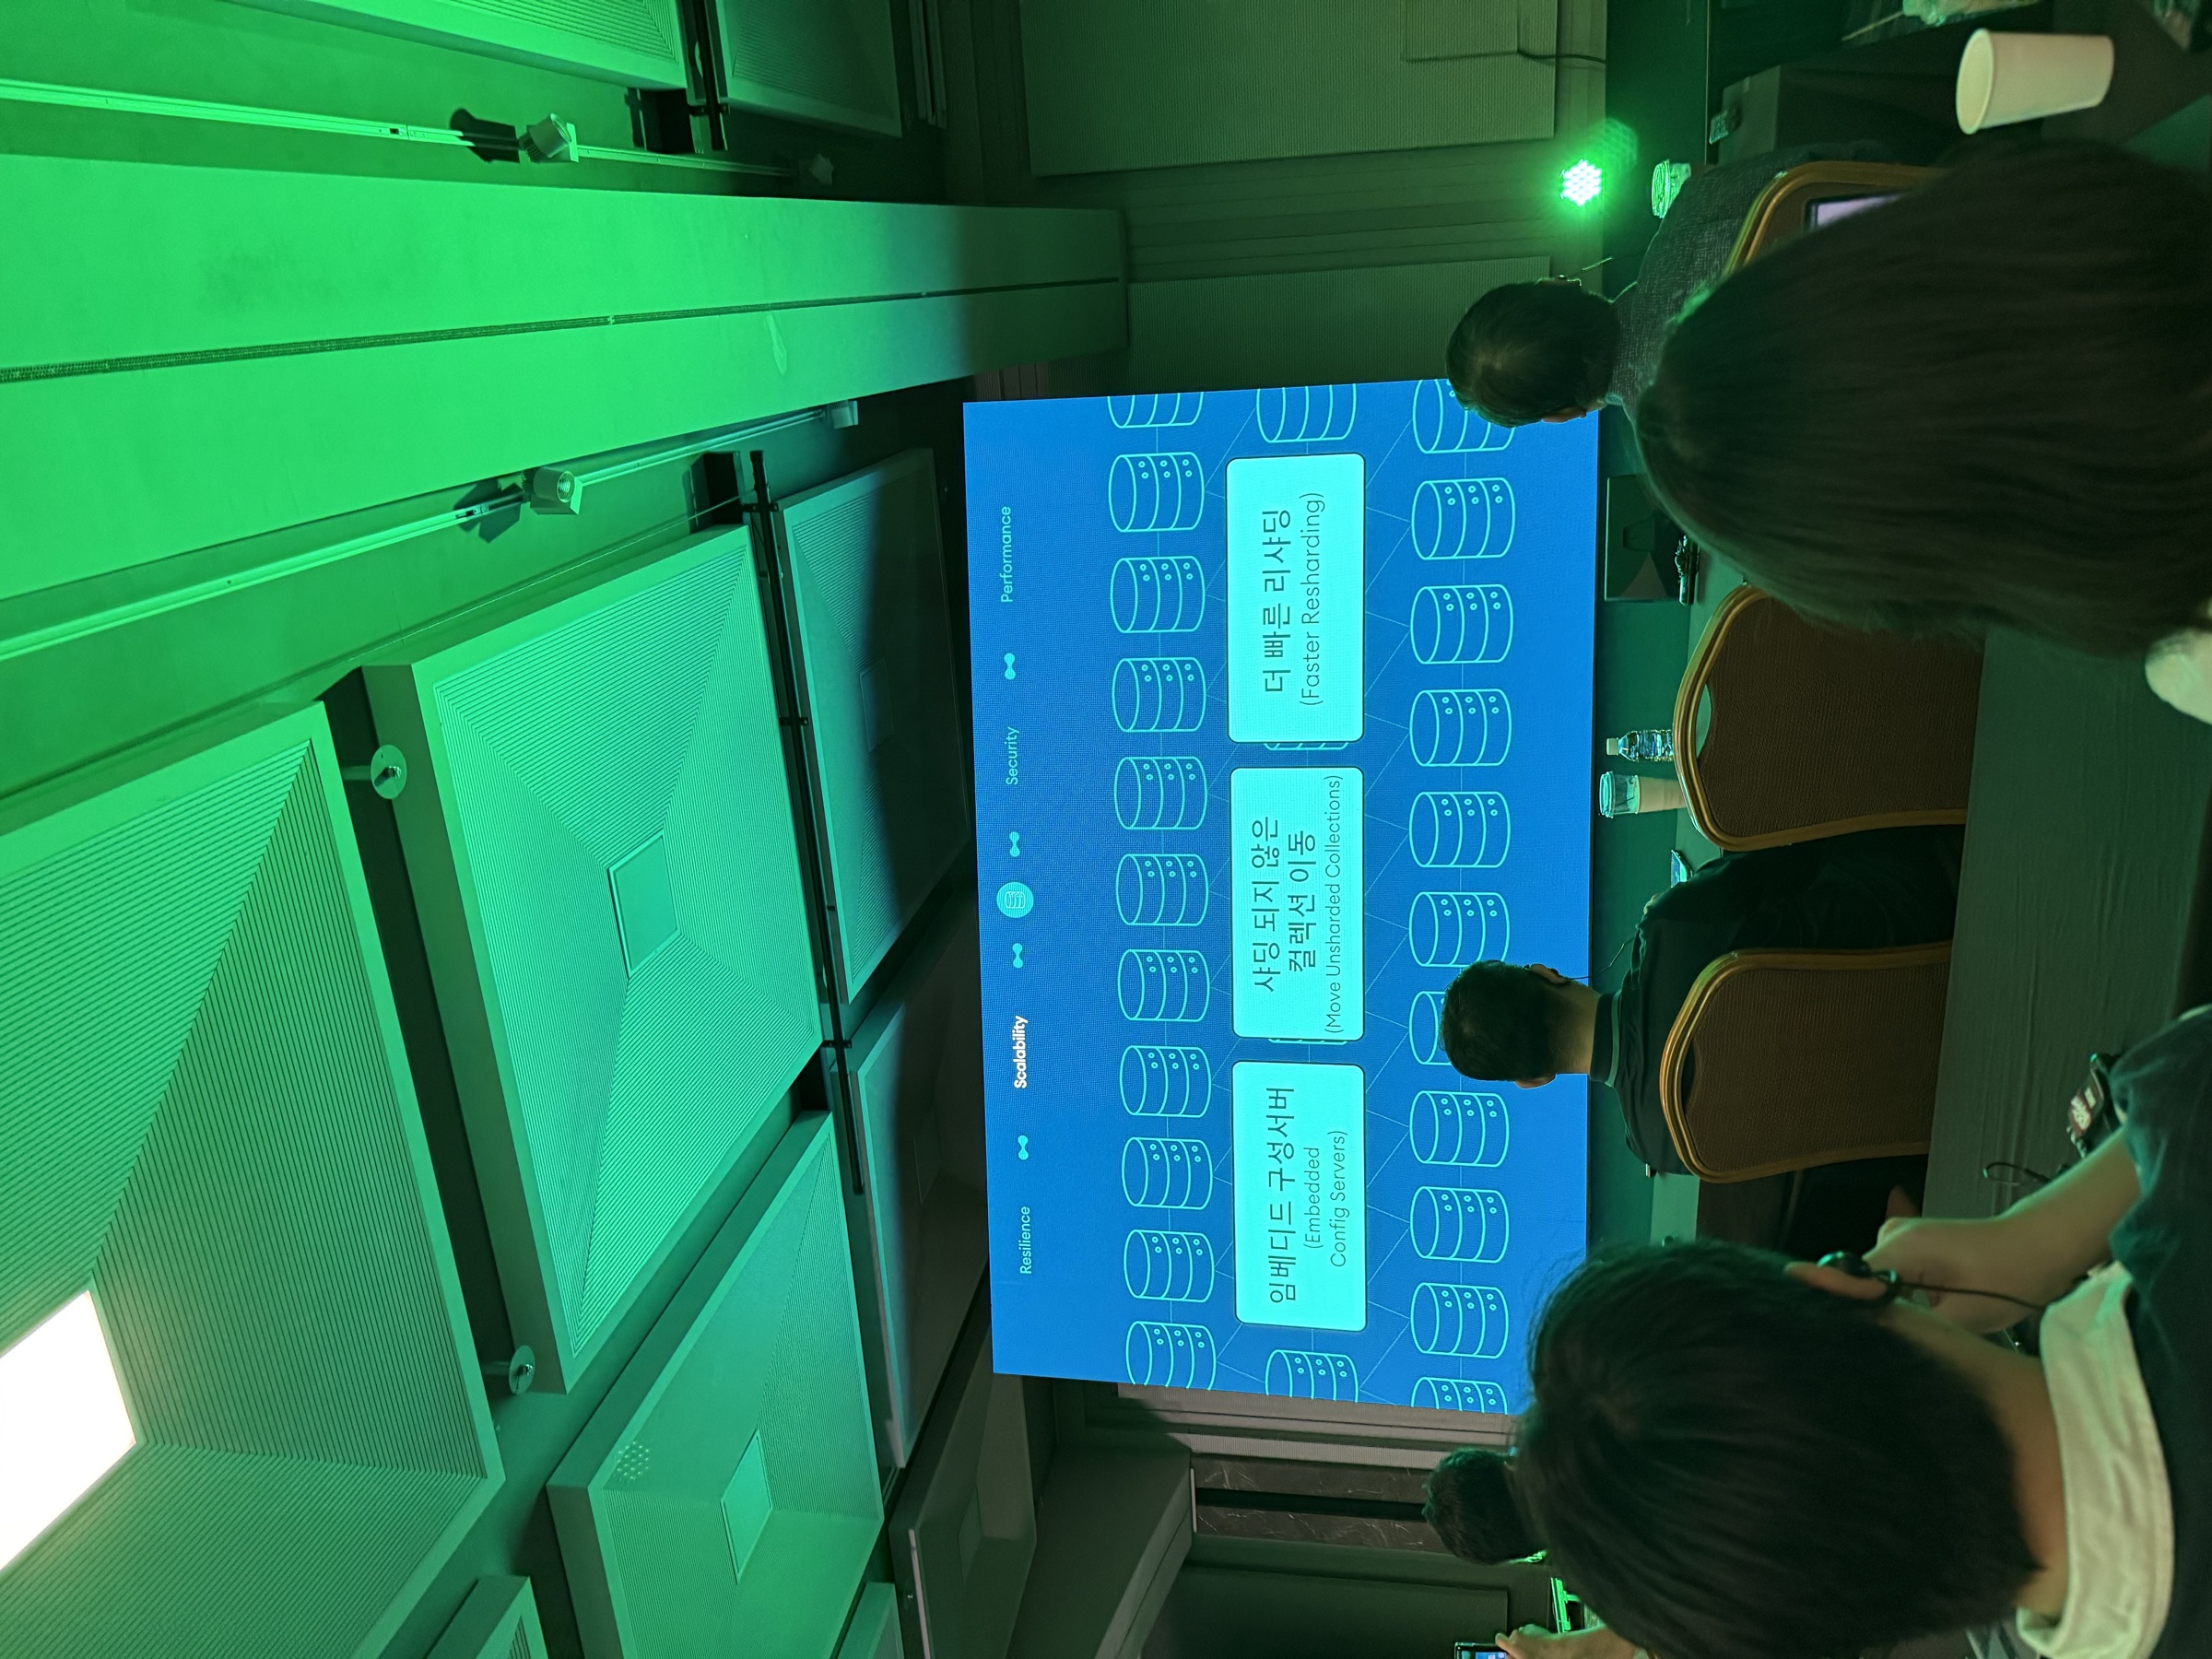
샤딩이 50배 빨라졌다고? - Config Shard의 혁명
데이터 분산 속도가 50배 빨라지고, 시작 비용은 50% 줄었다. 이는 Config Shard라는 새로운 개념 덕분이다.
샤딩(Sharding)이란 무엇인가? (쉬운 예시)
샤딩은 하나의 거대한 데이터를 여러 개의 작은 조각으로 나누어 여러 서버에 분산 저장하는 기술이다.
도서관을 예로 들어보자.
- 샤딩 전: 모든 책(데이터)이 하나의 거대한 중앙 도서관(단일 서버)에 있다. 사람이 몰리면 책을 찾고 대출하는 데 시간이 오래 걸린다.
- 샤딩 후: 책을 주제별로 나눠 ‘과학 도서관’, ‘역사 도서관’, ‘소설 도서관’(각각의 샤드 서버)으로 분산시킨다. 이용자는 필요한 책이 있는 전문 도서관으로 바로 가기 때문에 훨씬 빠르다. MongoDB 8.0에서는 이 ’전문 도서관’을 만드는 과정이 훨씬 저렴하고 빨라진 것이다. 예전에는 최소 5대의 서버가 필요했지만, 이제는 최소 1대로 시작할 수 있다.
더 중요한 것은 moveCollection 명령어로 데이터를 자유롭게 이동시킬 수 있다는 점이다.
TypeScript
이 기능을 활용하면 특정 고객사의 데이터를 물리적으로 분리하여 안정성과 성능을 높일 수 있다.
쿼리 가능 암호화 - 진정한 제로 트러스트 보안
MongoDB 8.0의 쿼리 가능 암호화(Queryable Encryption)는 데이터가 암호화된 상태에서도 범위 검색(>, <)을 지원한다. 데이터베이스 관리자나 해커가 서버에 직접 접근해도 암호화된 쓰레기 값만 보일 뿐, 실제 내용은 절대 알 수 없다.
우리 파트너 시스템의 민감한 급여 정보를 예로 들어보자.
TypeScript
이 쿼리가 실행될 때, MongoDB 서버는 3000000이나 5000000이라는 실제 숫자를 전혀 보지 못한다. 그저 암호화된 값(A#@!, B$*&)끼리 대소를 비교하여 결과를 반환할 뿐이다. 이는 애플리케이션은 정상적으로 동작하면서도, 데이터베이스 단에서는 완벽한 보안을 유지할 수 있음을 의미한다.
Atlas의 대대적 강화 - AI 시대의 통합 데이터 플랫폼
Atlas 클라우드 서비스가 대폭 개선되었다. 수직적 확장 (서버의 사양을 높이는 것) 속도가 50% 빨라졌고, 트래픽에 따라 자동으로 서버 자원을 조절하는 오토스케일링의 반응 속도는 5배 향상되었다.
이는 블랙프라이데이처럼 갑자기 사용자가 몰리는 상황에서, 시스템이 훨씬 더 빠르고 안정적으로 대응할 수 있게 되었음을 의미한다.
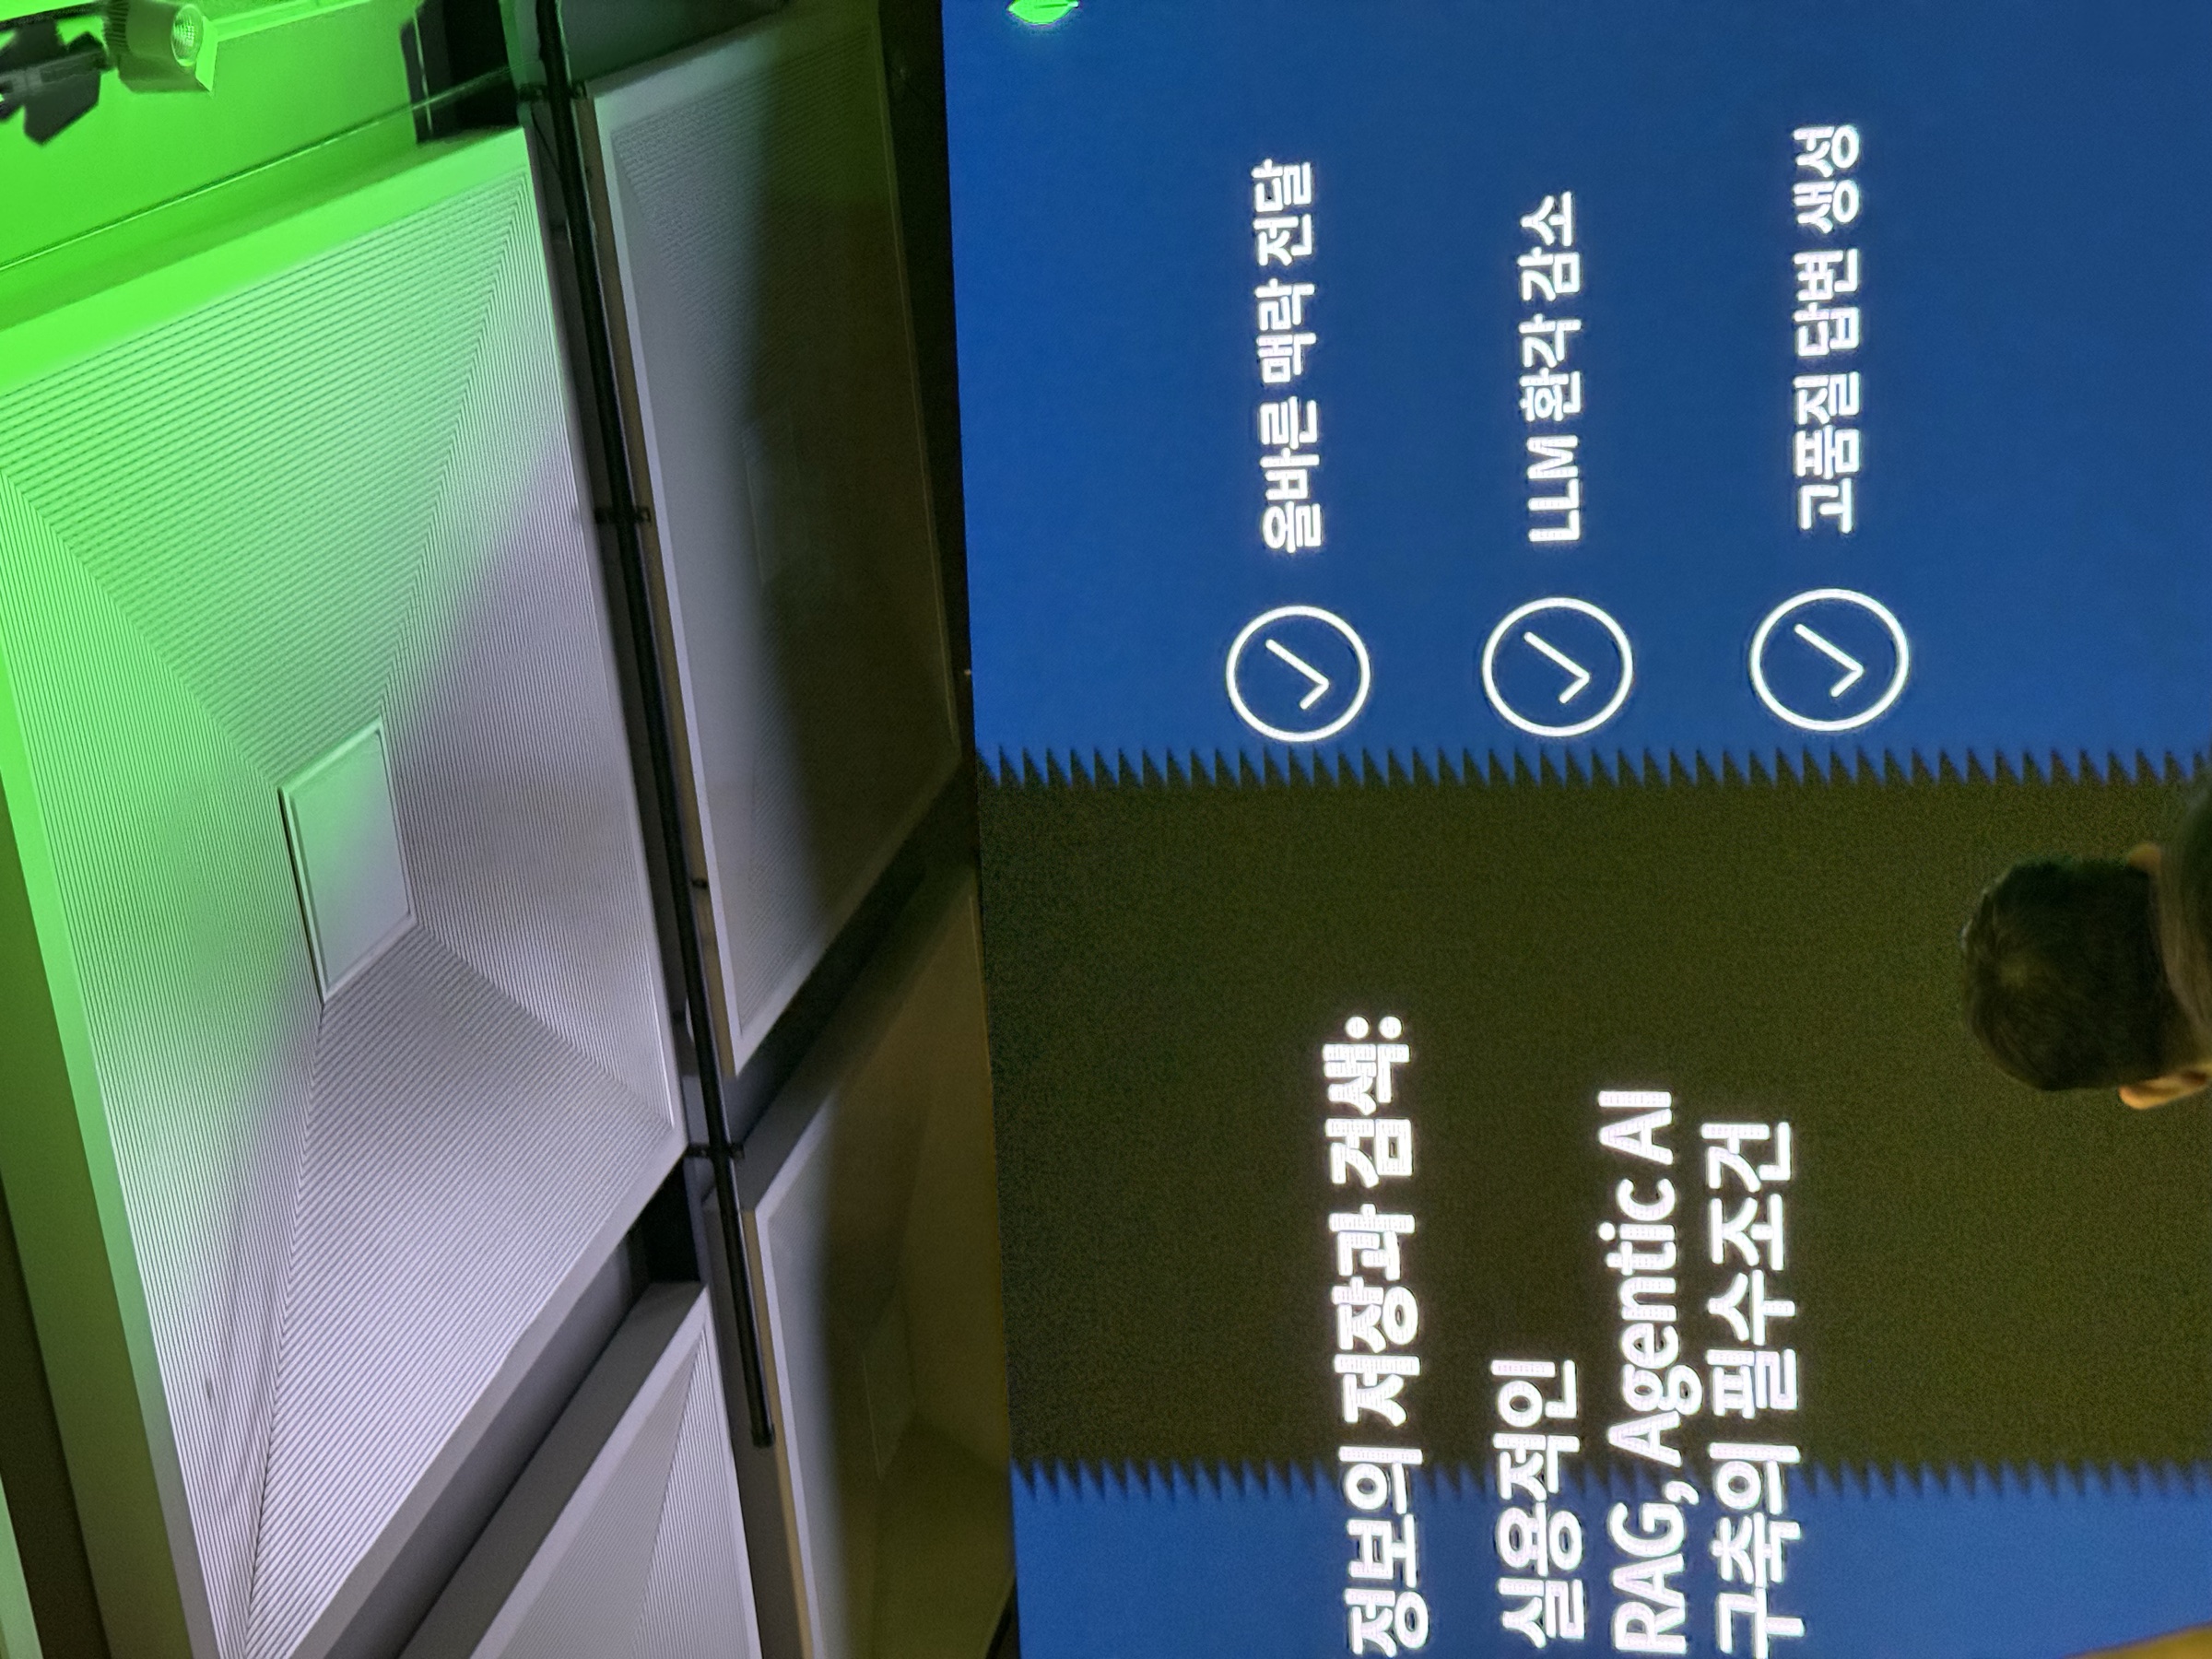
AI 시대의 검색 진화 - Full-text, Vector, 그리고 하이브리드
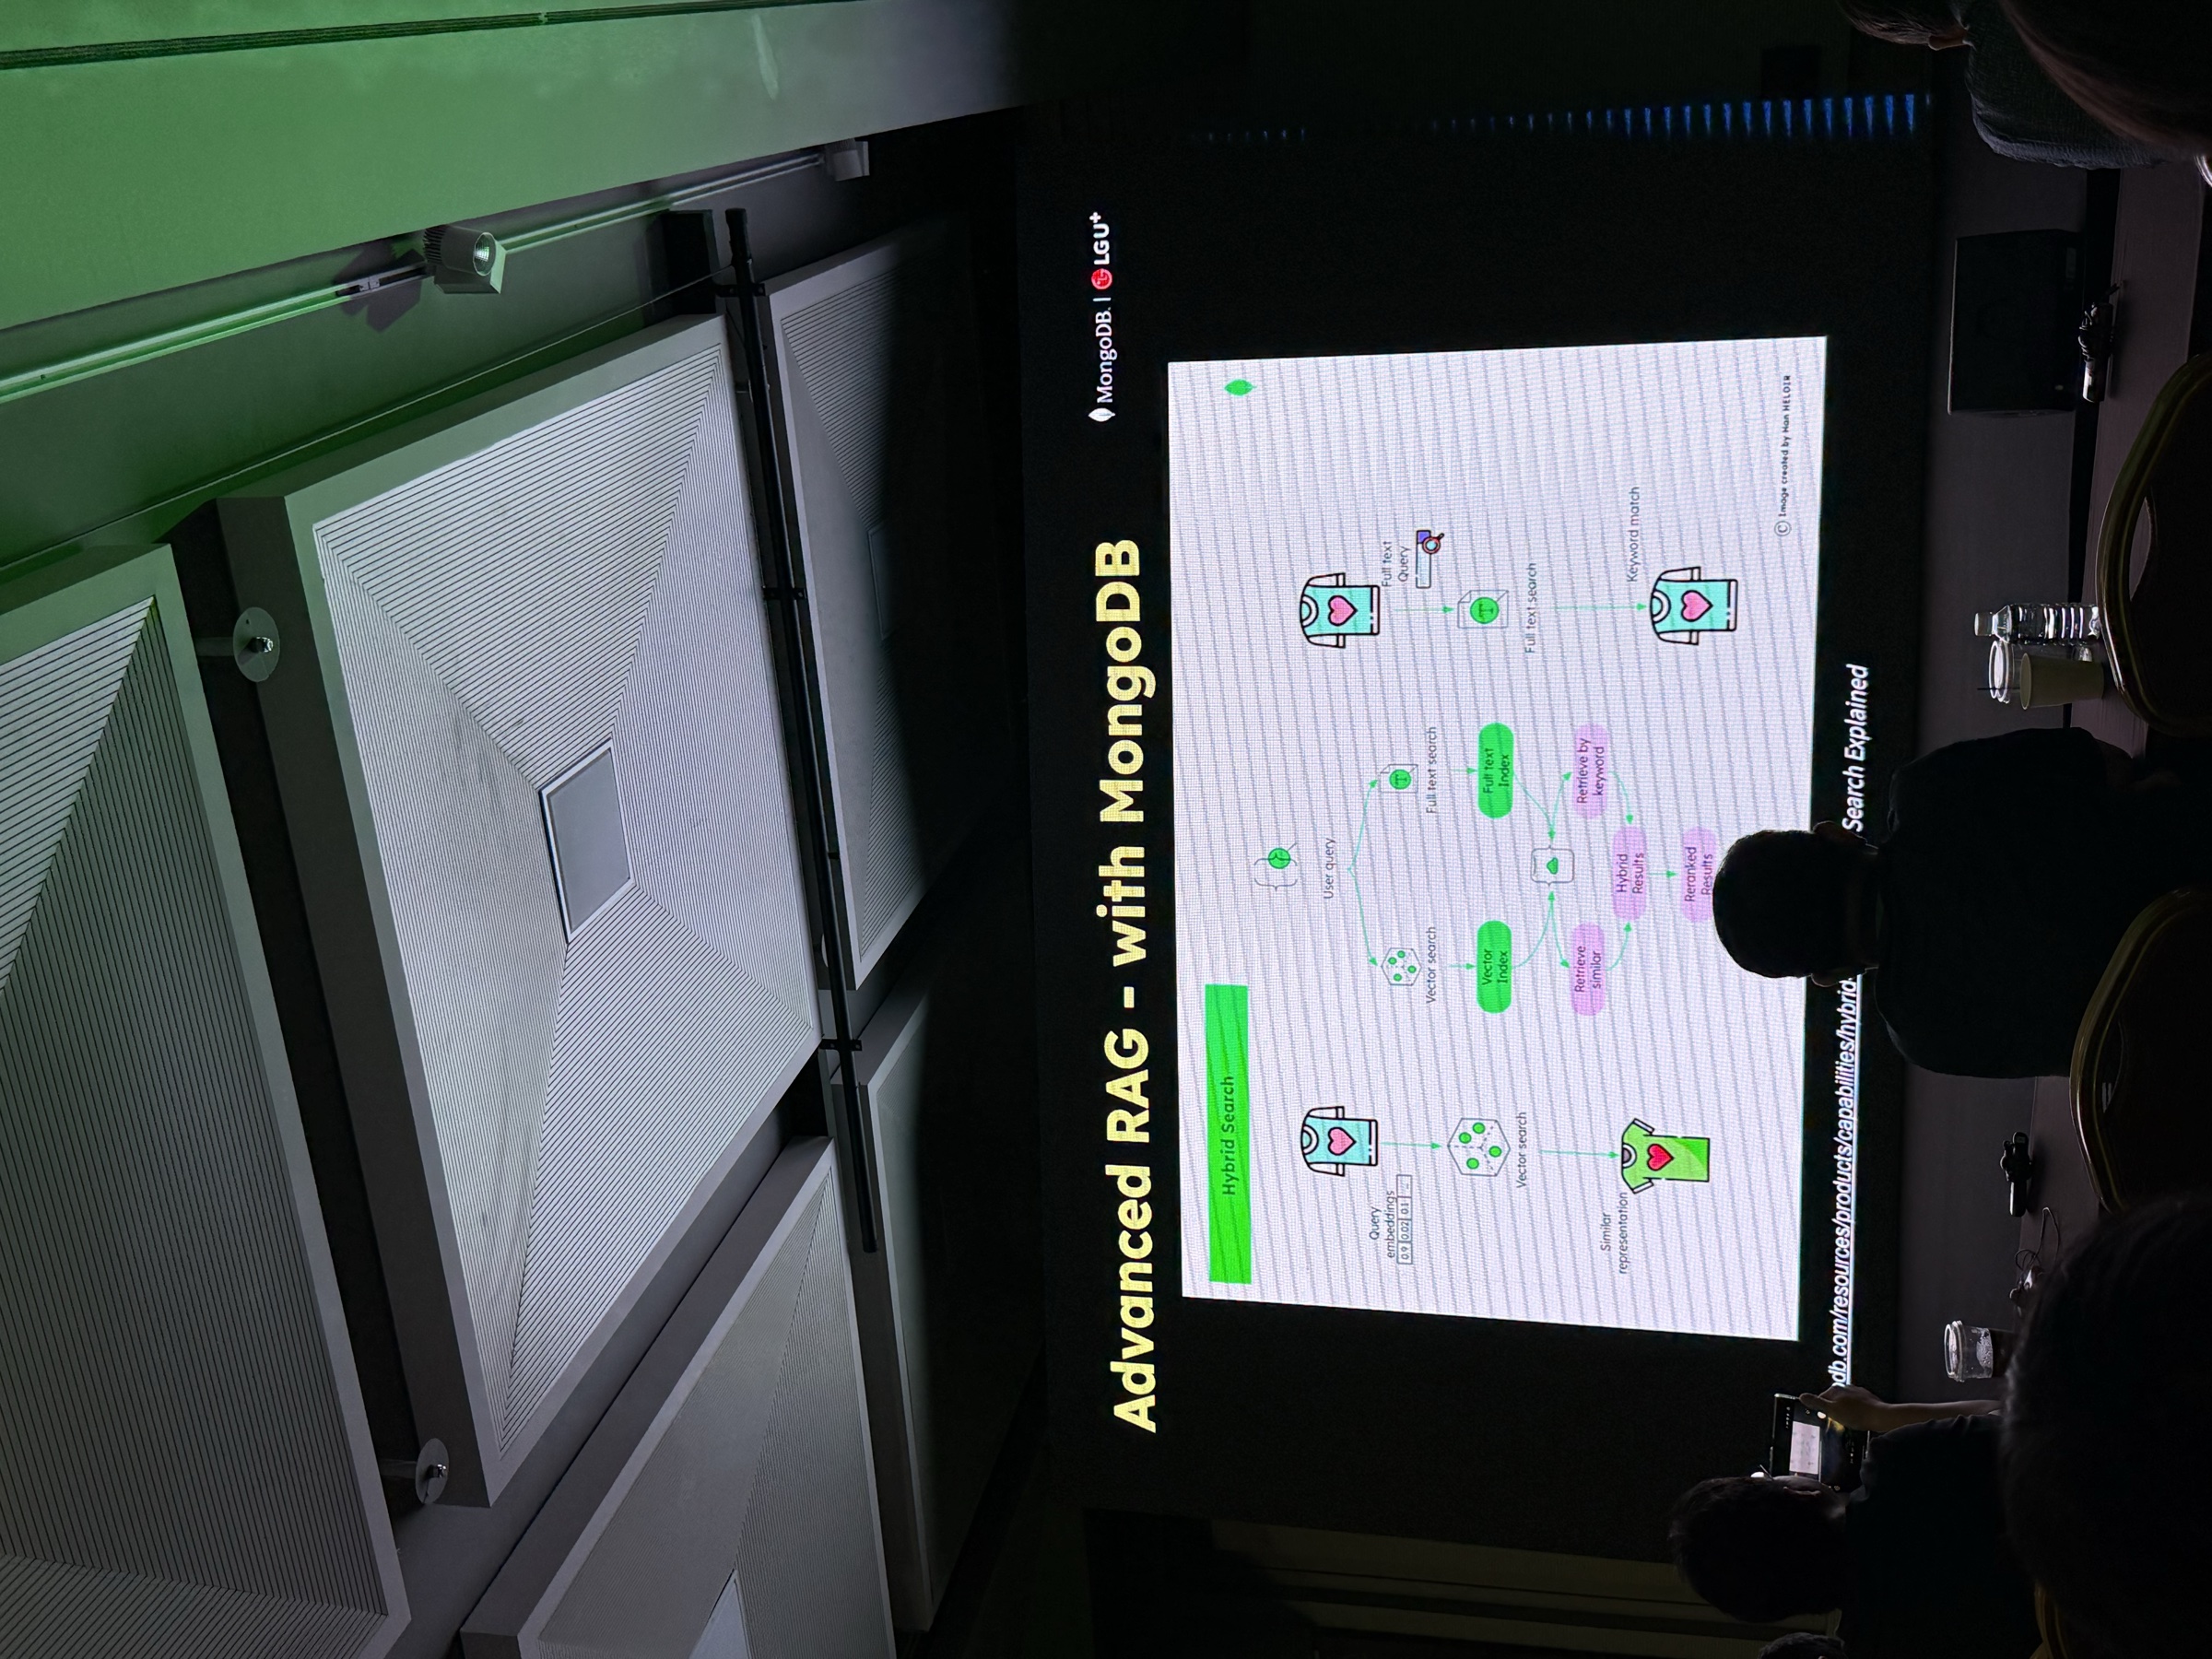
최신 검색 기술은 이전 기술을 대체하는 것이 아니라, 서로의 단점을 보완하며 함께 발전한다.
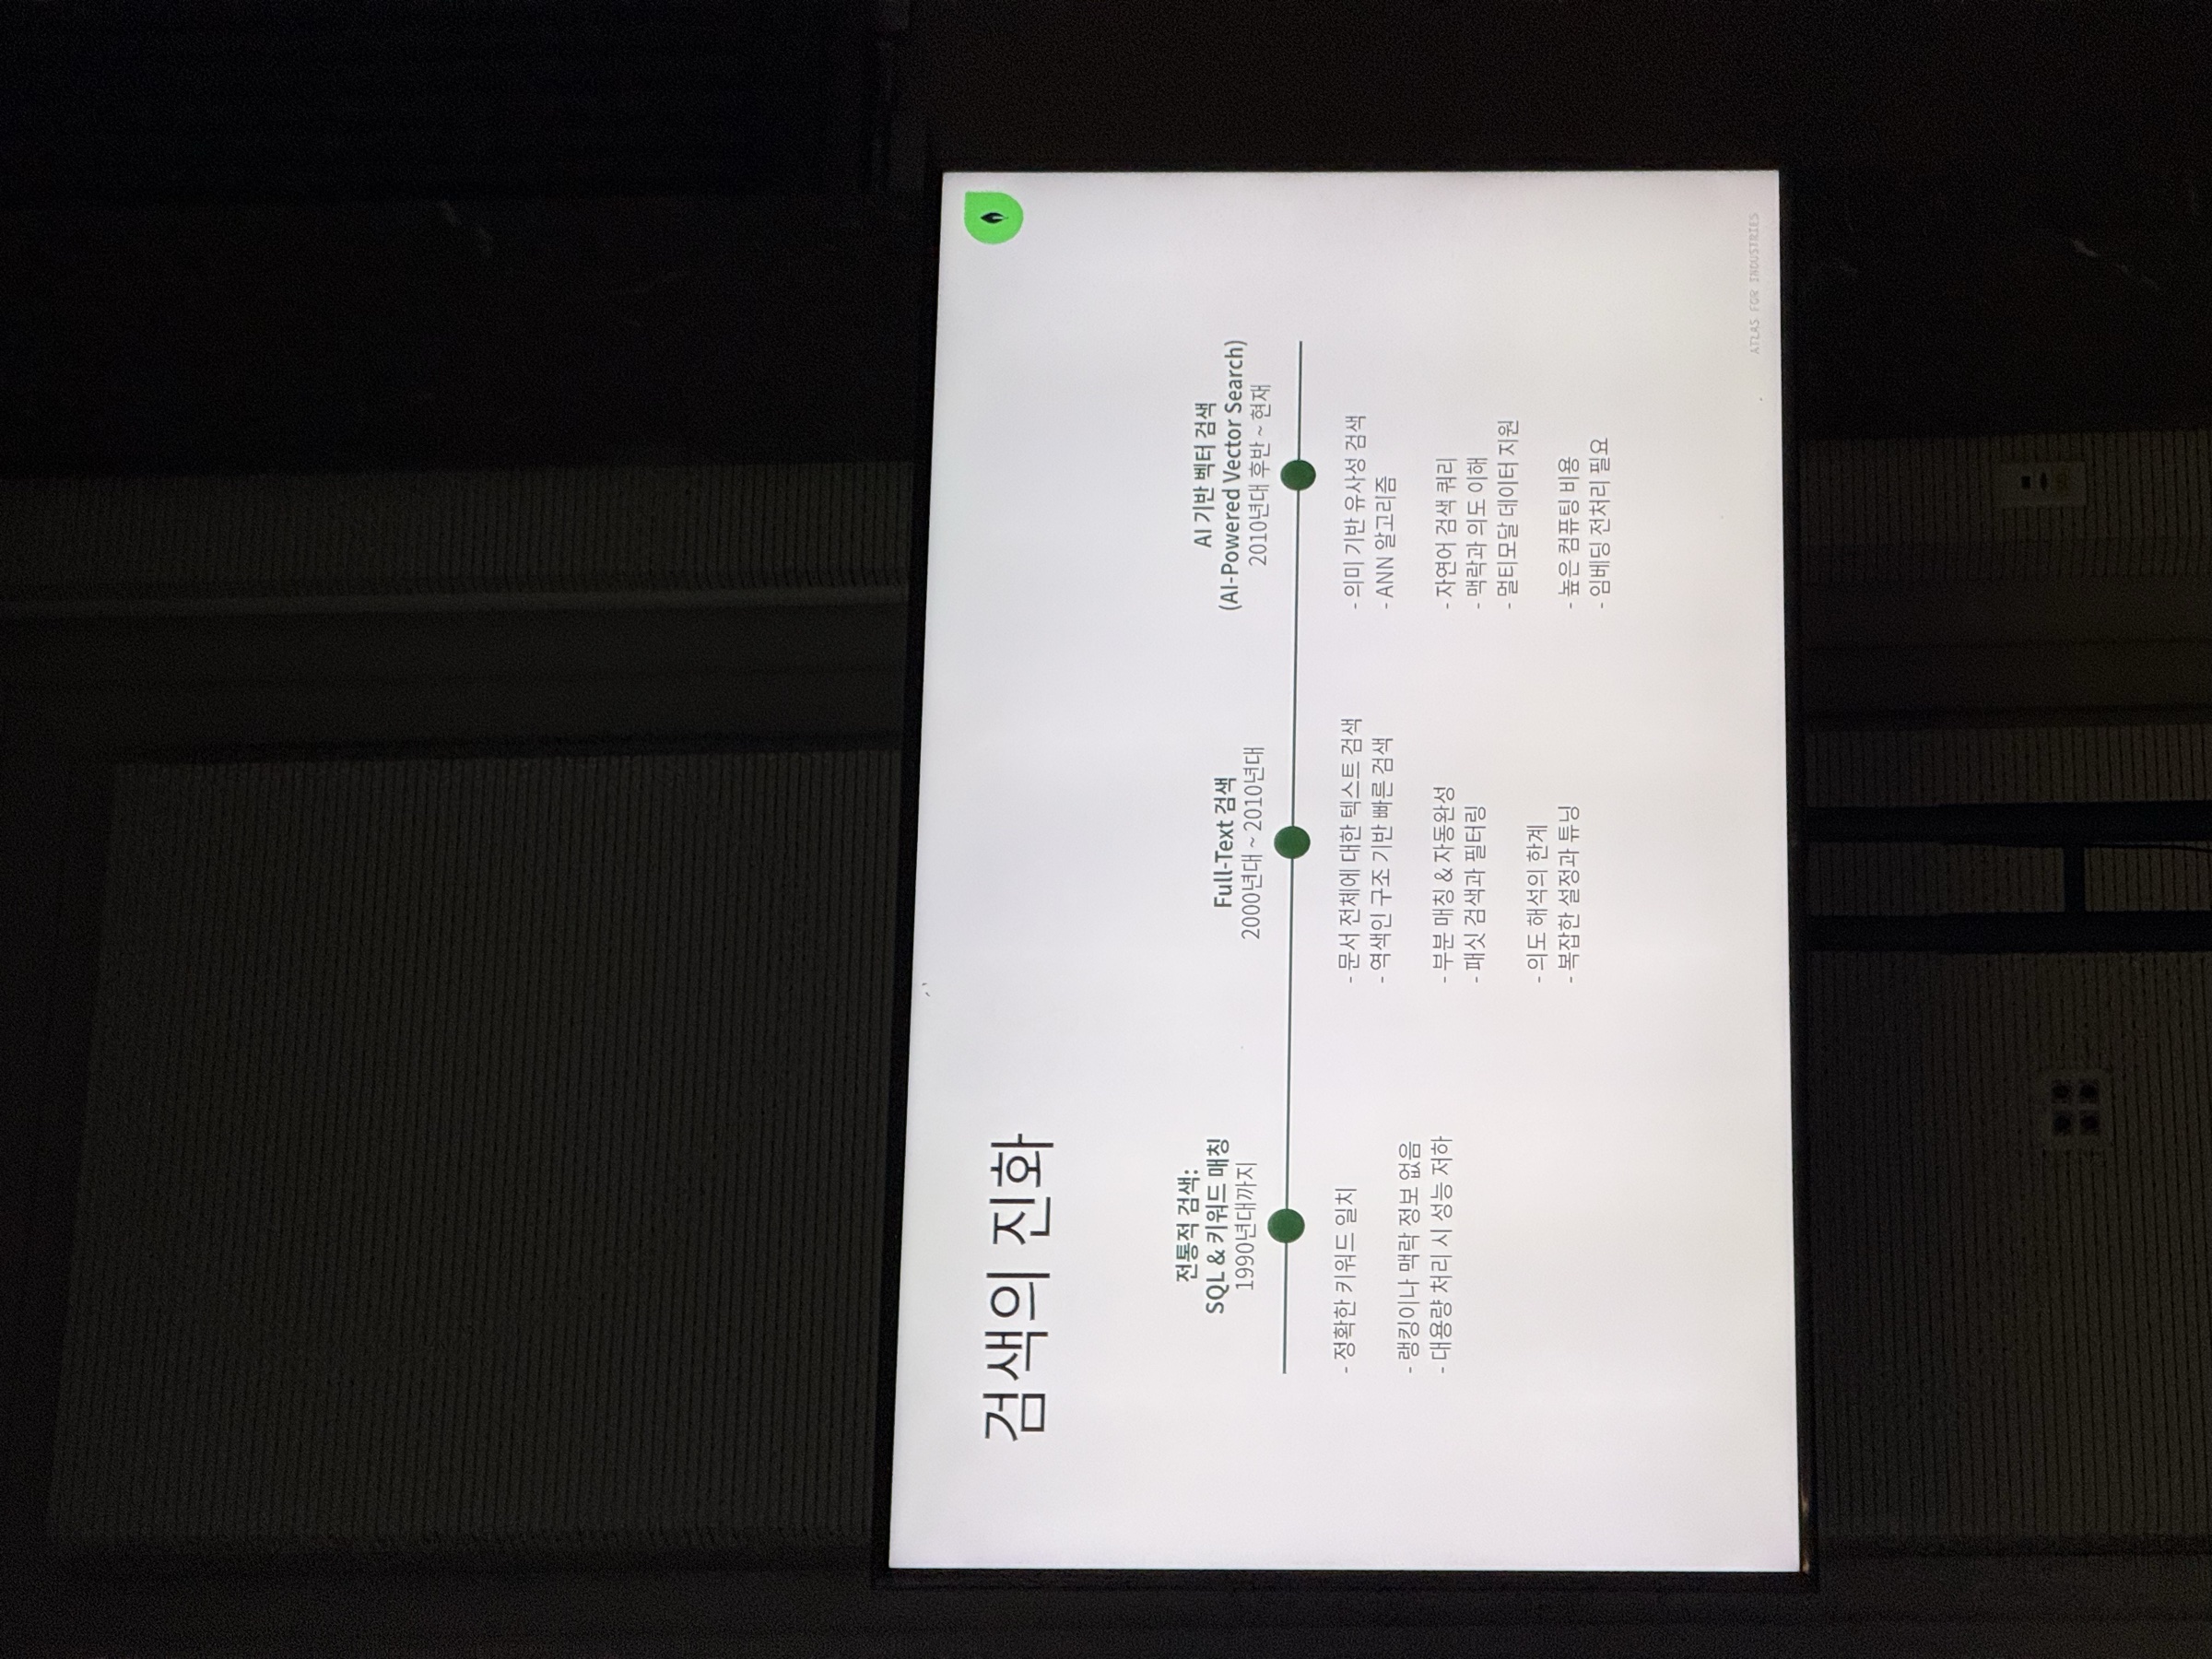
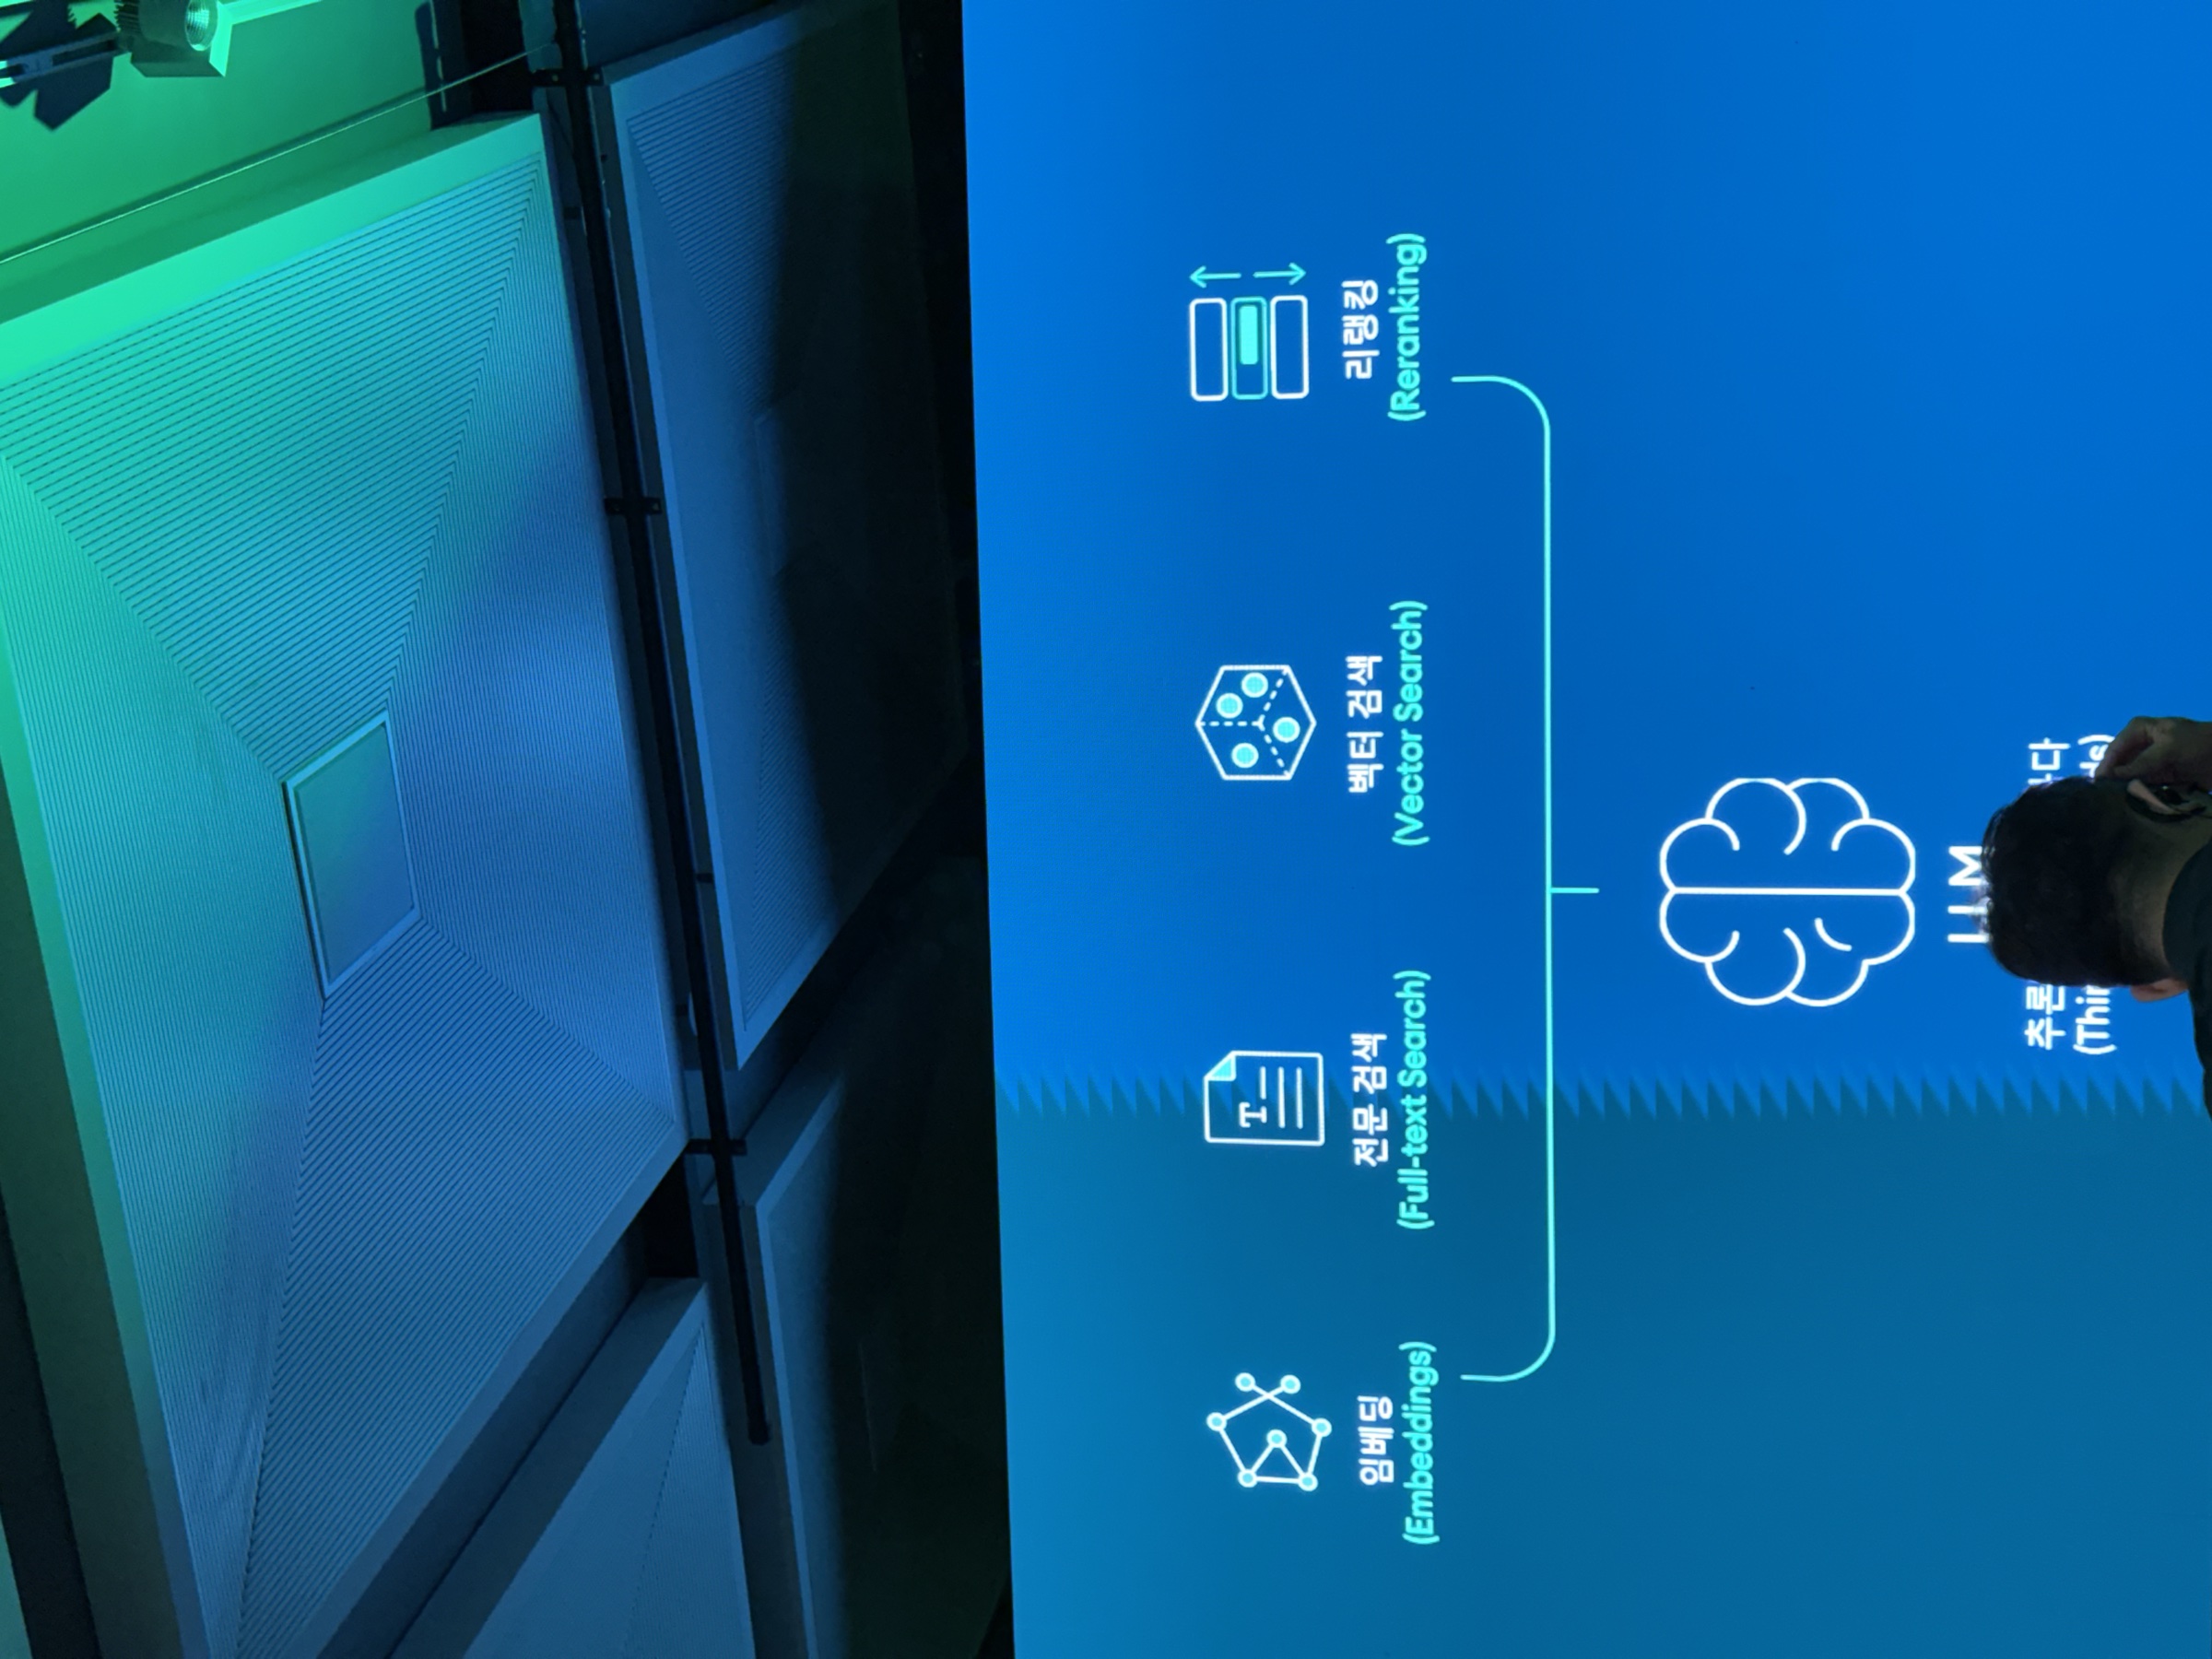
- 1. Full-text 검색 (키워드 검색): 사용자가 입력한 정확한 단어를 찾는 방식이다. “이탈리안”이라는 키워드는 잘 찾지만, “빠르고 쉬운”과 같은 추상적인 의미는 이해하지 못한다.
- 2. Vector 검색 (의미 검색): 단어의 의미나 맥락을 이해하여 유사한 내용을 찾는 방식이다. “빠르고 쉬운” 요리를 찾기 위해 “10분 완성”, “초간단 레시피” 등을 찾아주지만, “이탈리안”이라는 특정 키워드를 놓칠 수 있다.
- 3. 하이브리드 검색 (만능 검색): 위 두 가지 방식을 결합한 것이다. 키워드의 정확성과 의미의 유사성을 모두 고려하여 가장 연관성 높은 결과를 찾아준다.
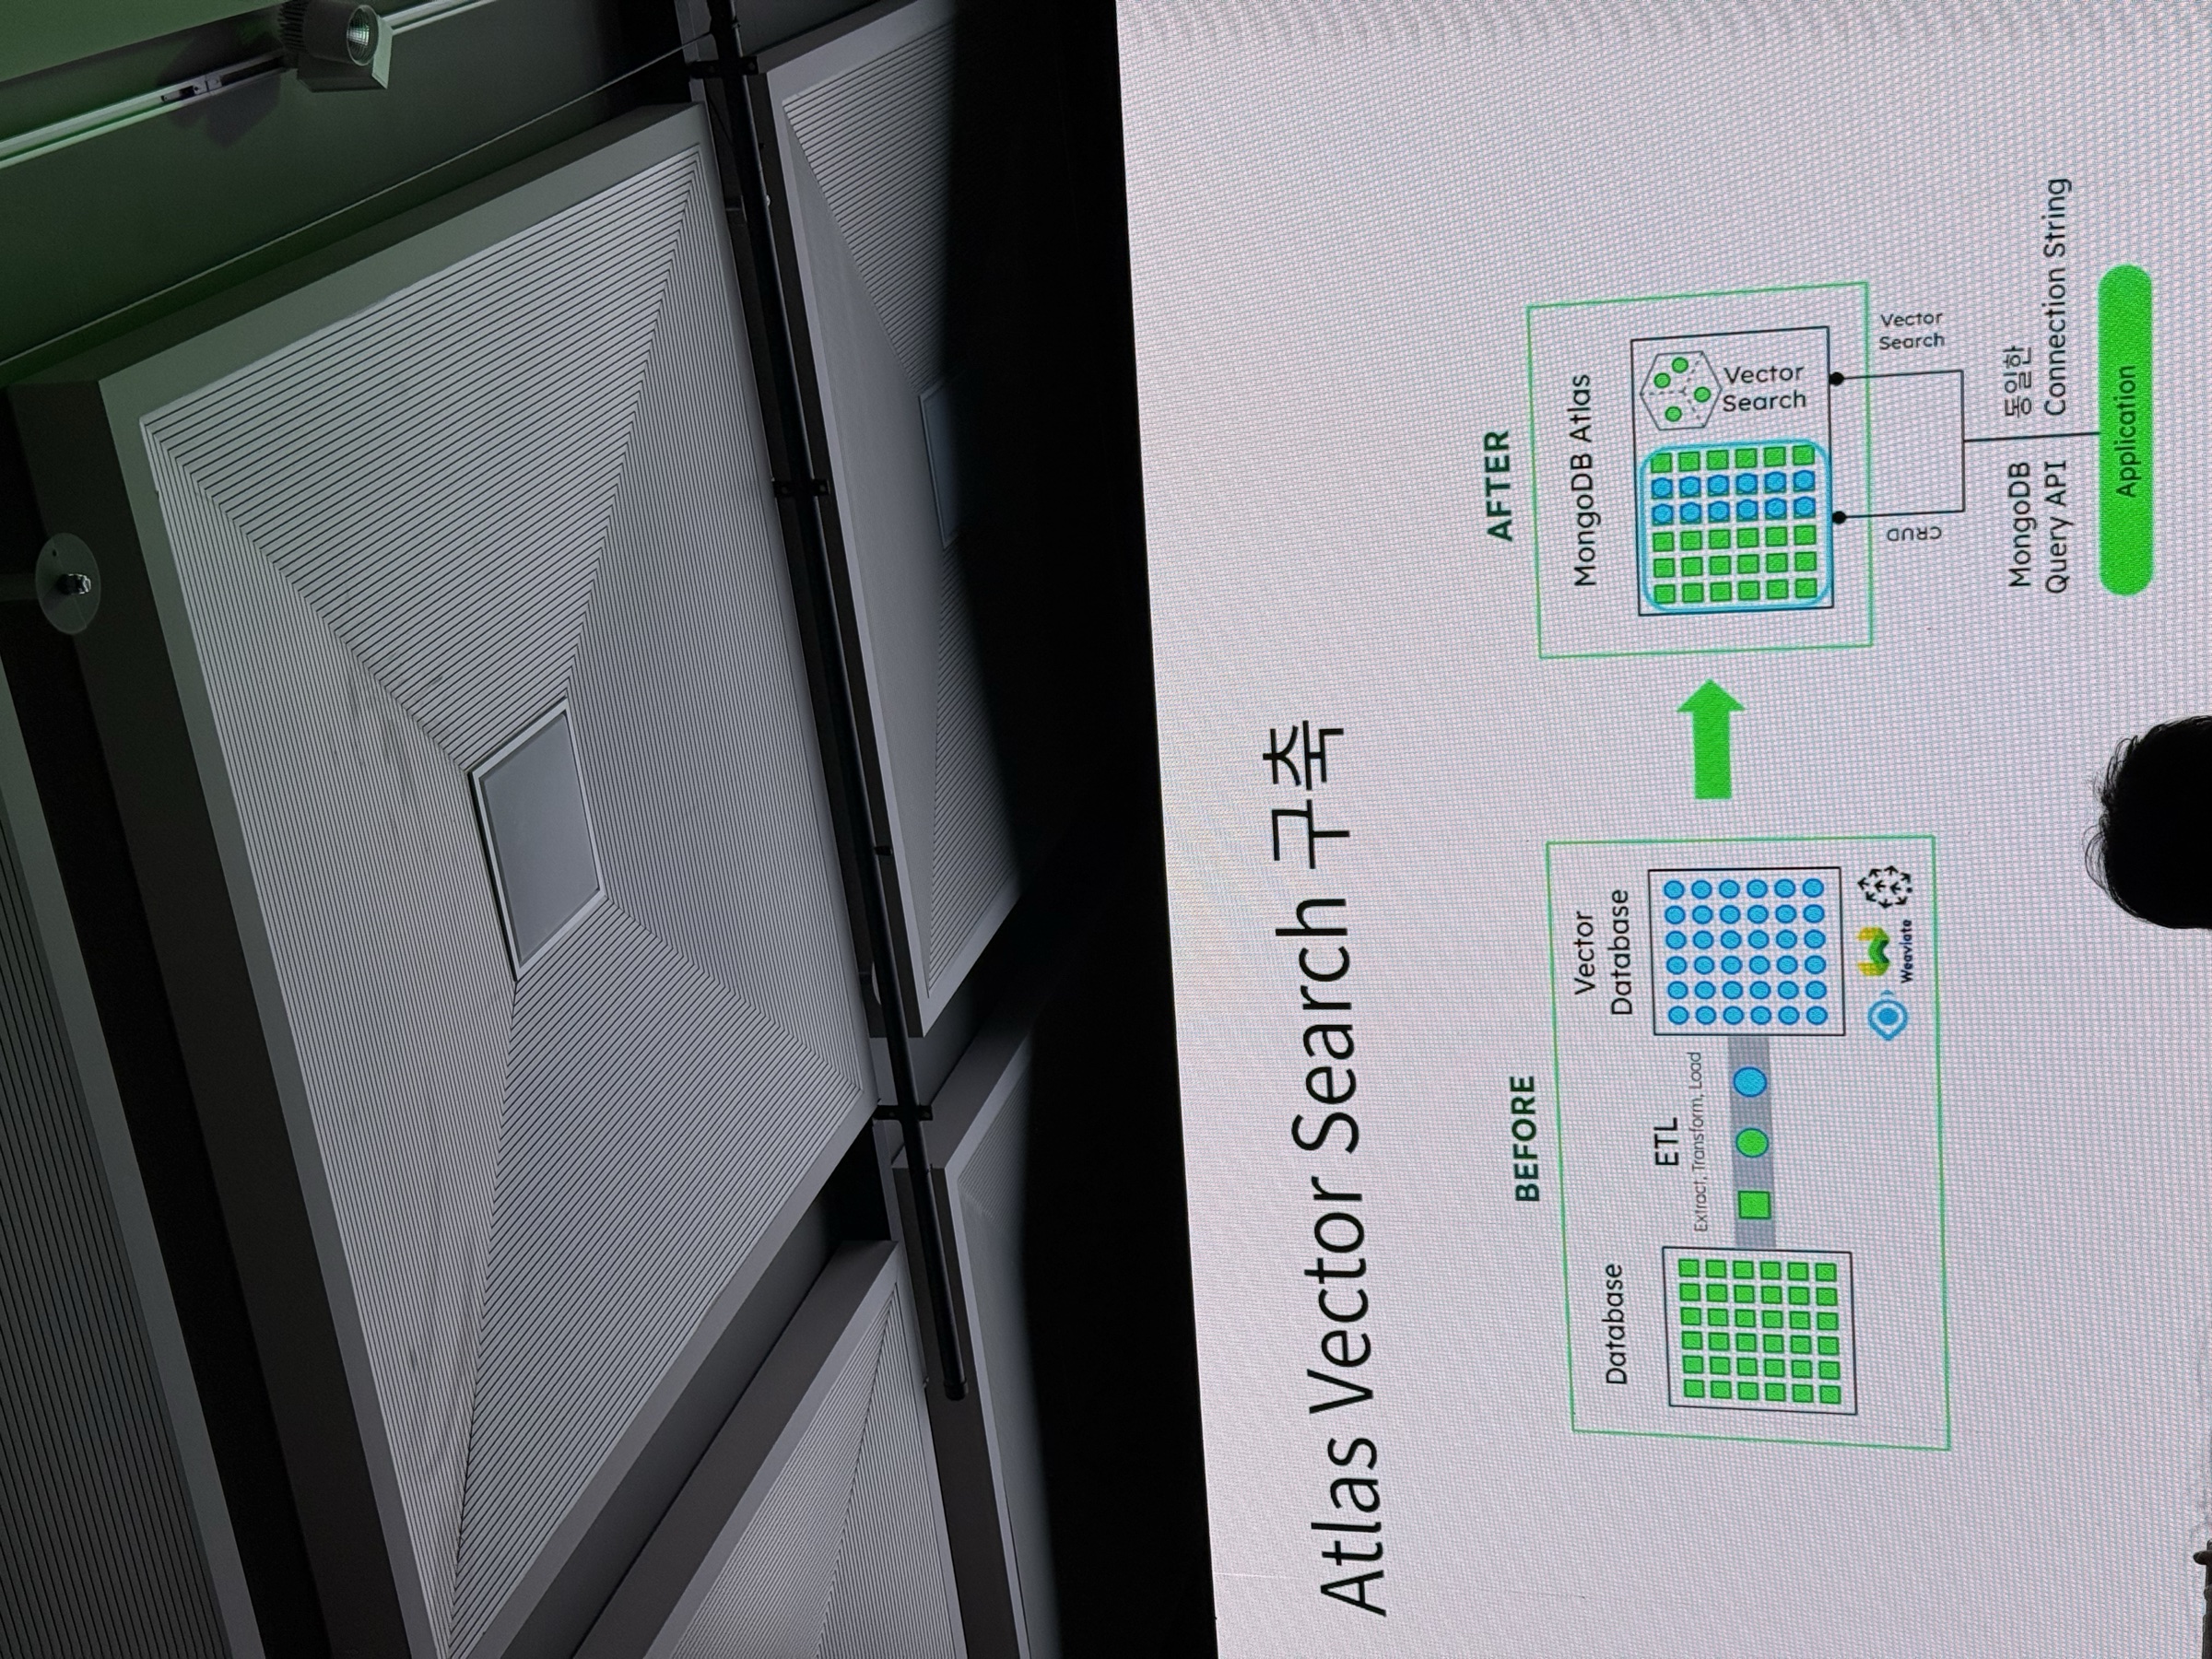
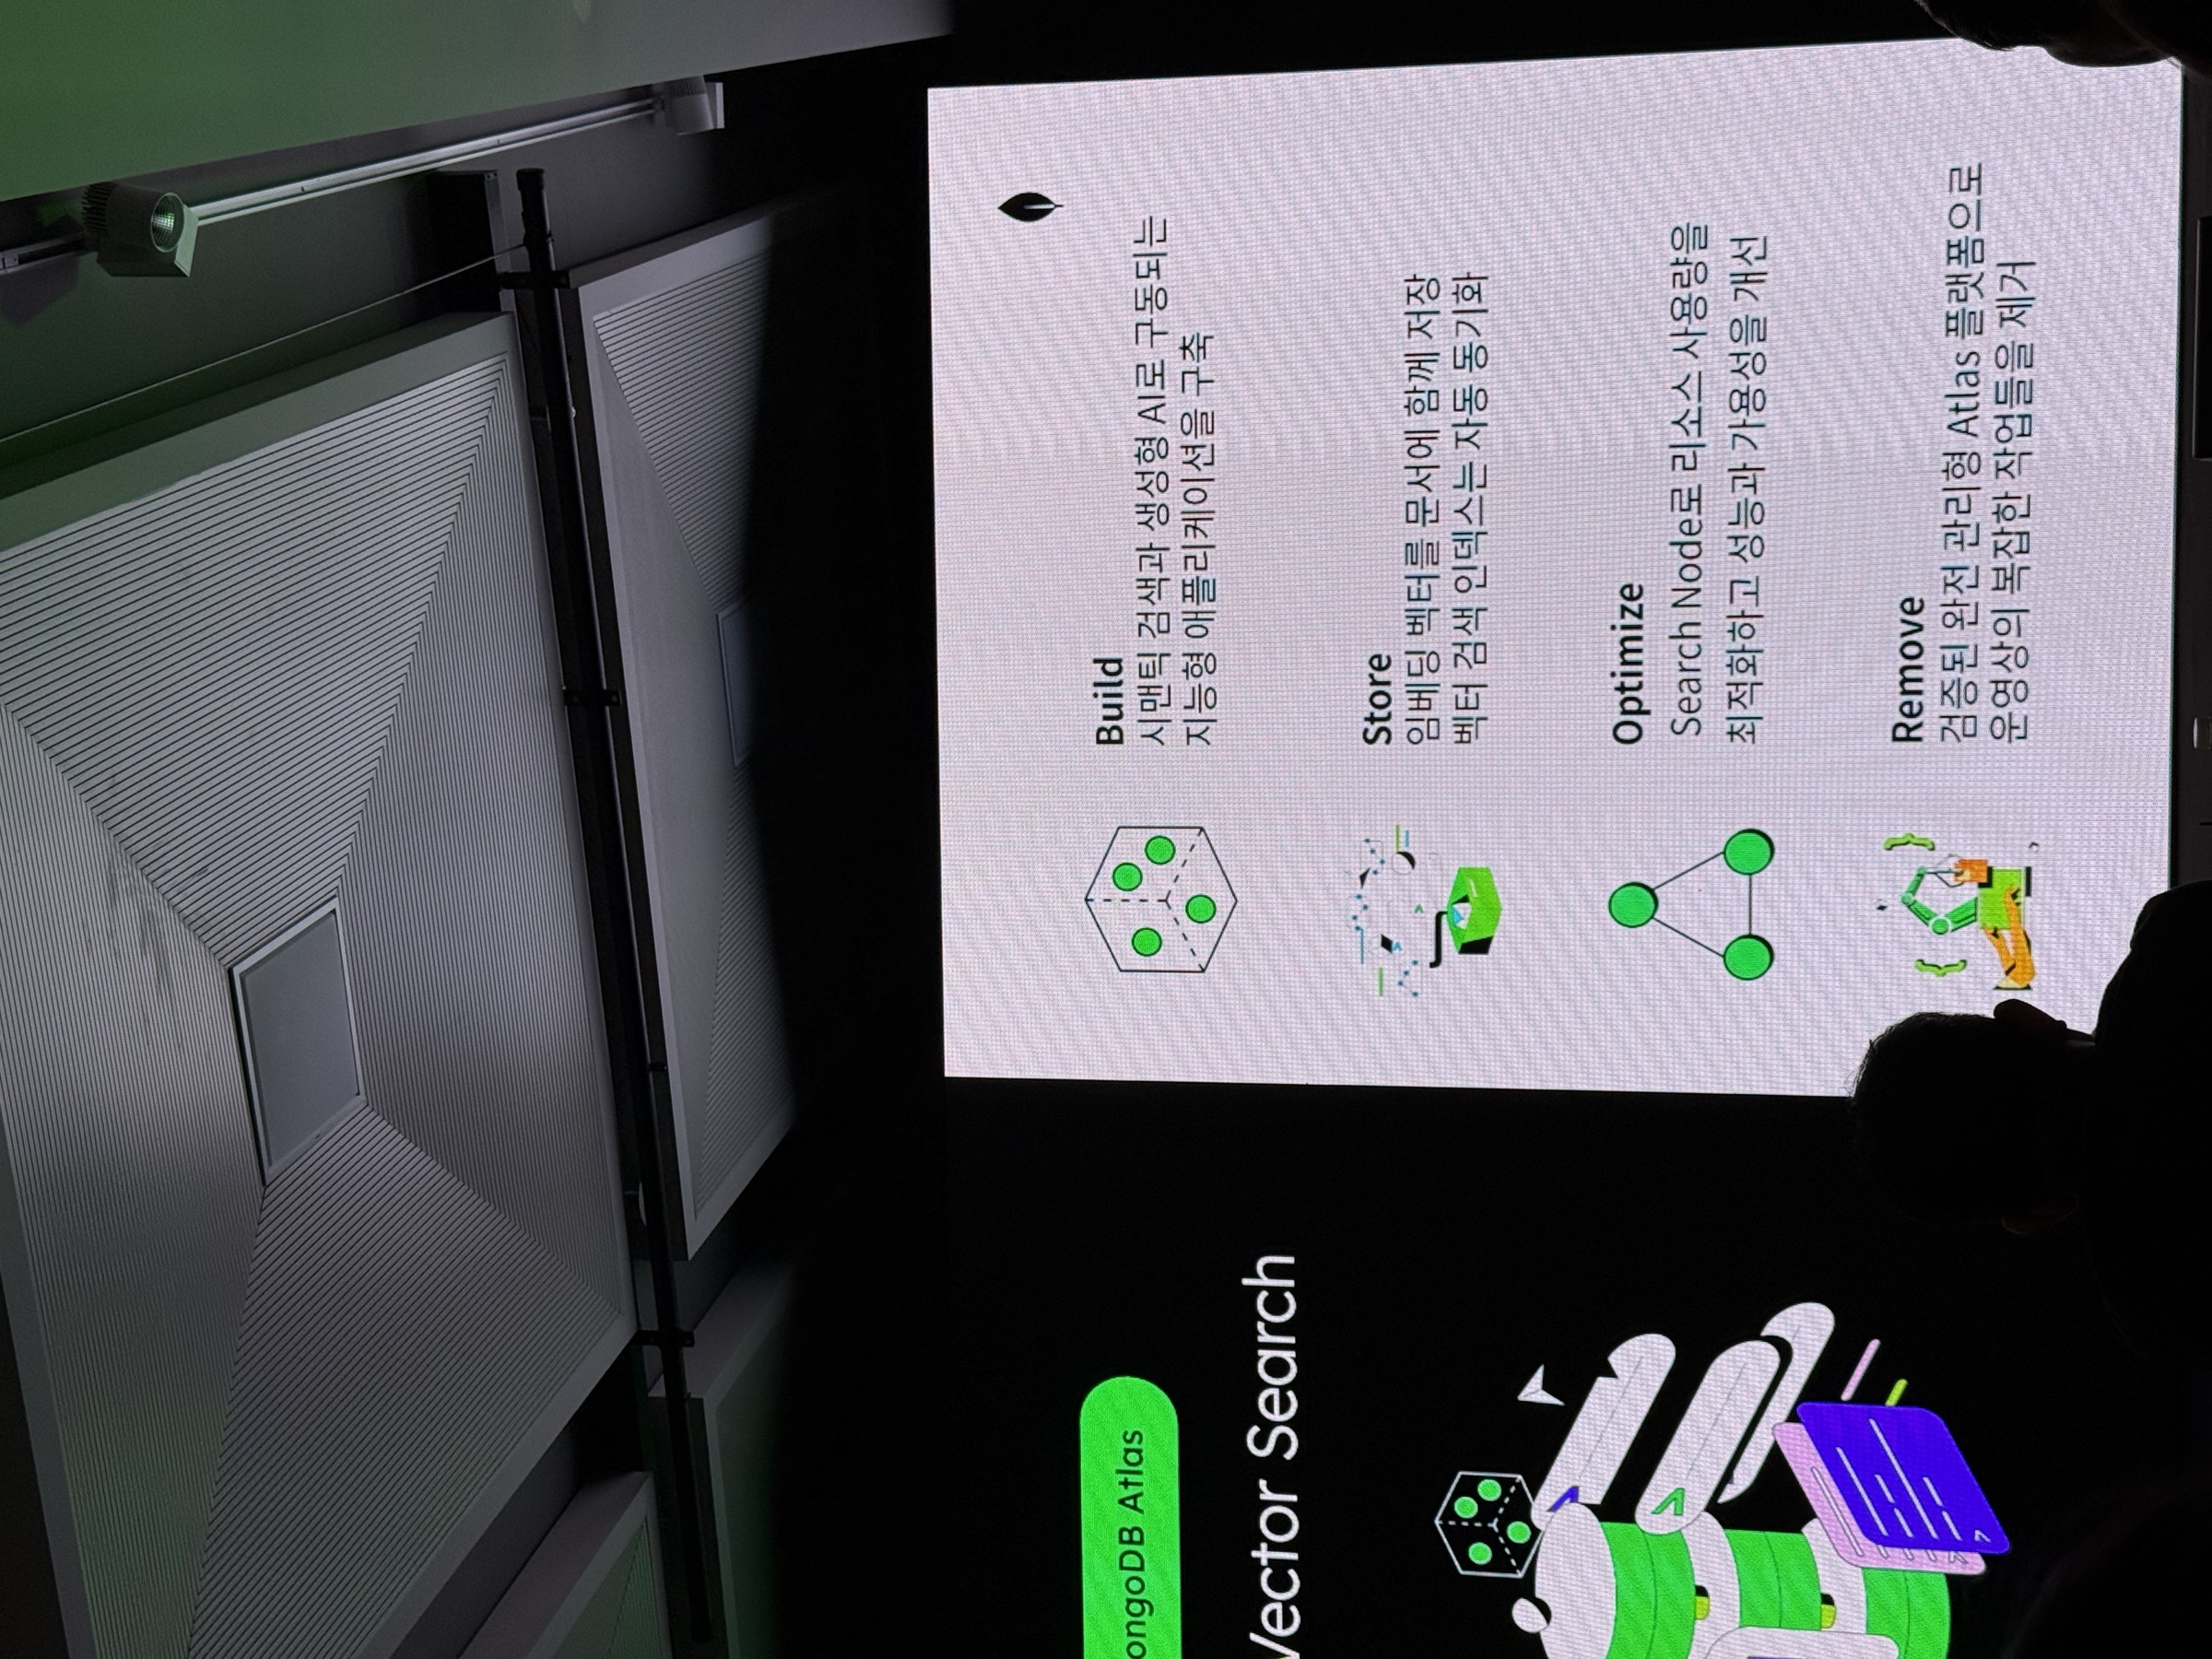
$rankFusion - 복잡한 하이브리드 검색을 한 줄로
과거에는 키워드 검색과 의미 검색을 각각 실행한 후, 개발자가 복잡한 코드를 작성하여 두 결과를 합치고 점수를 다시 매겨야 했다.
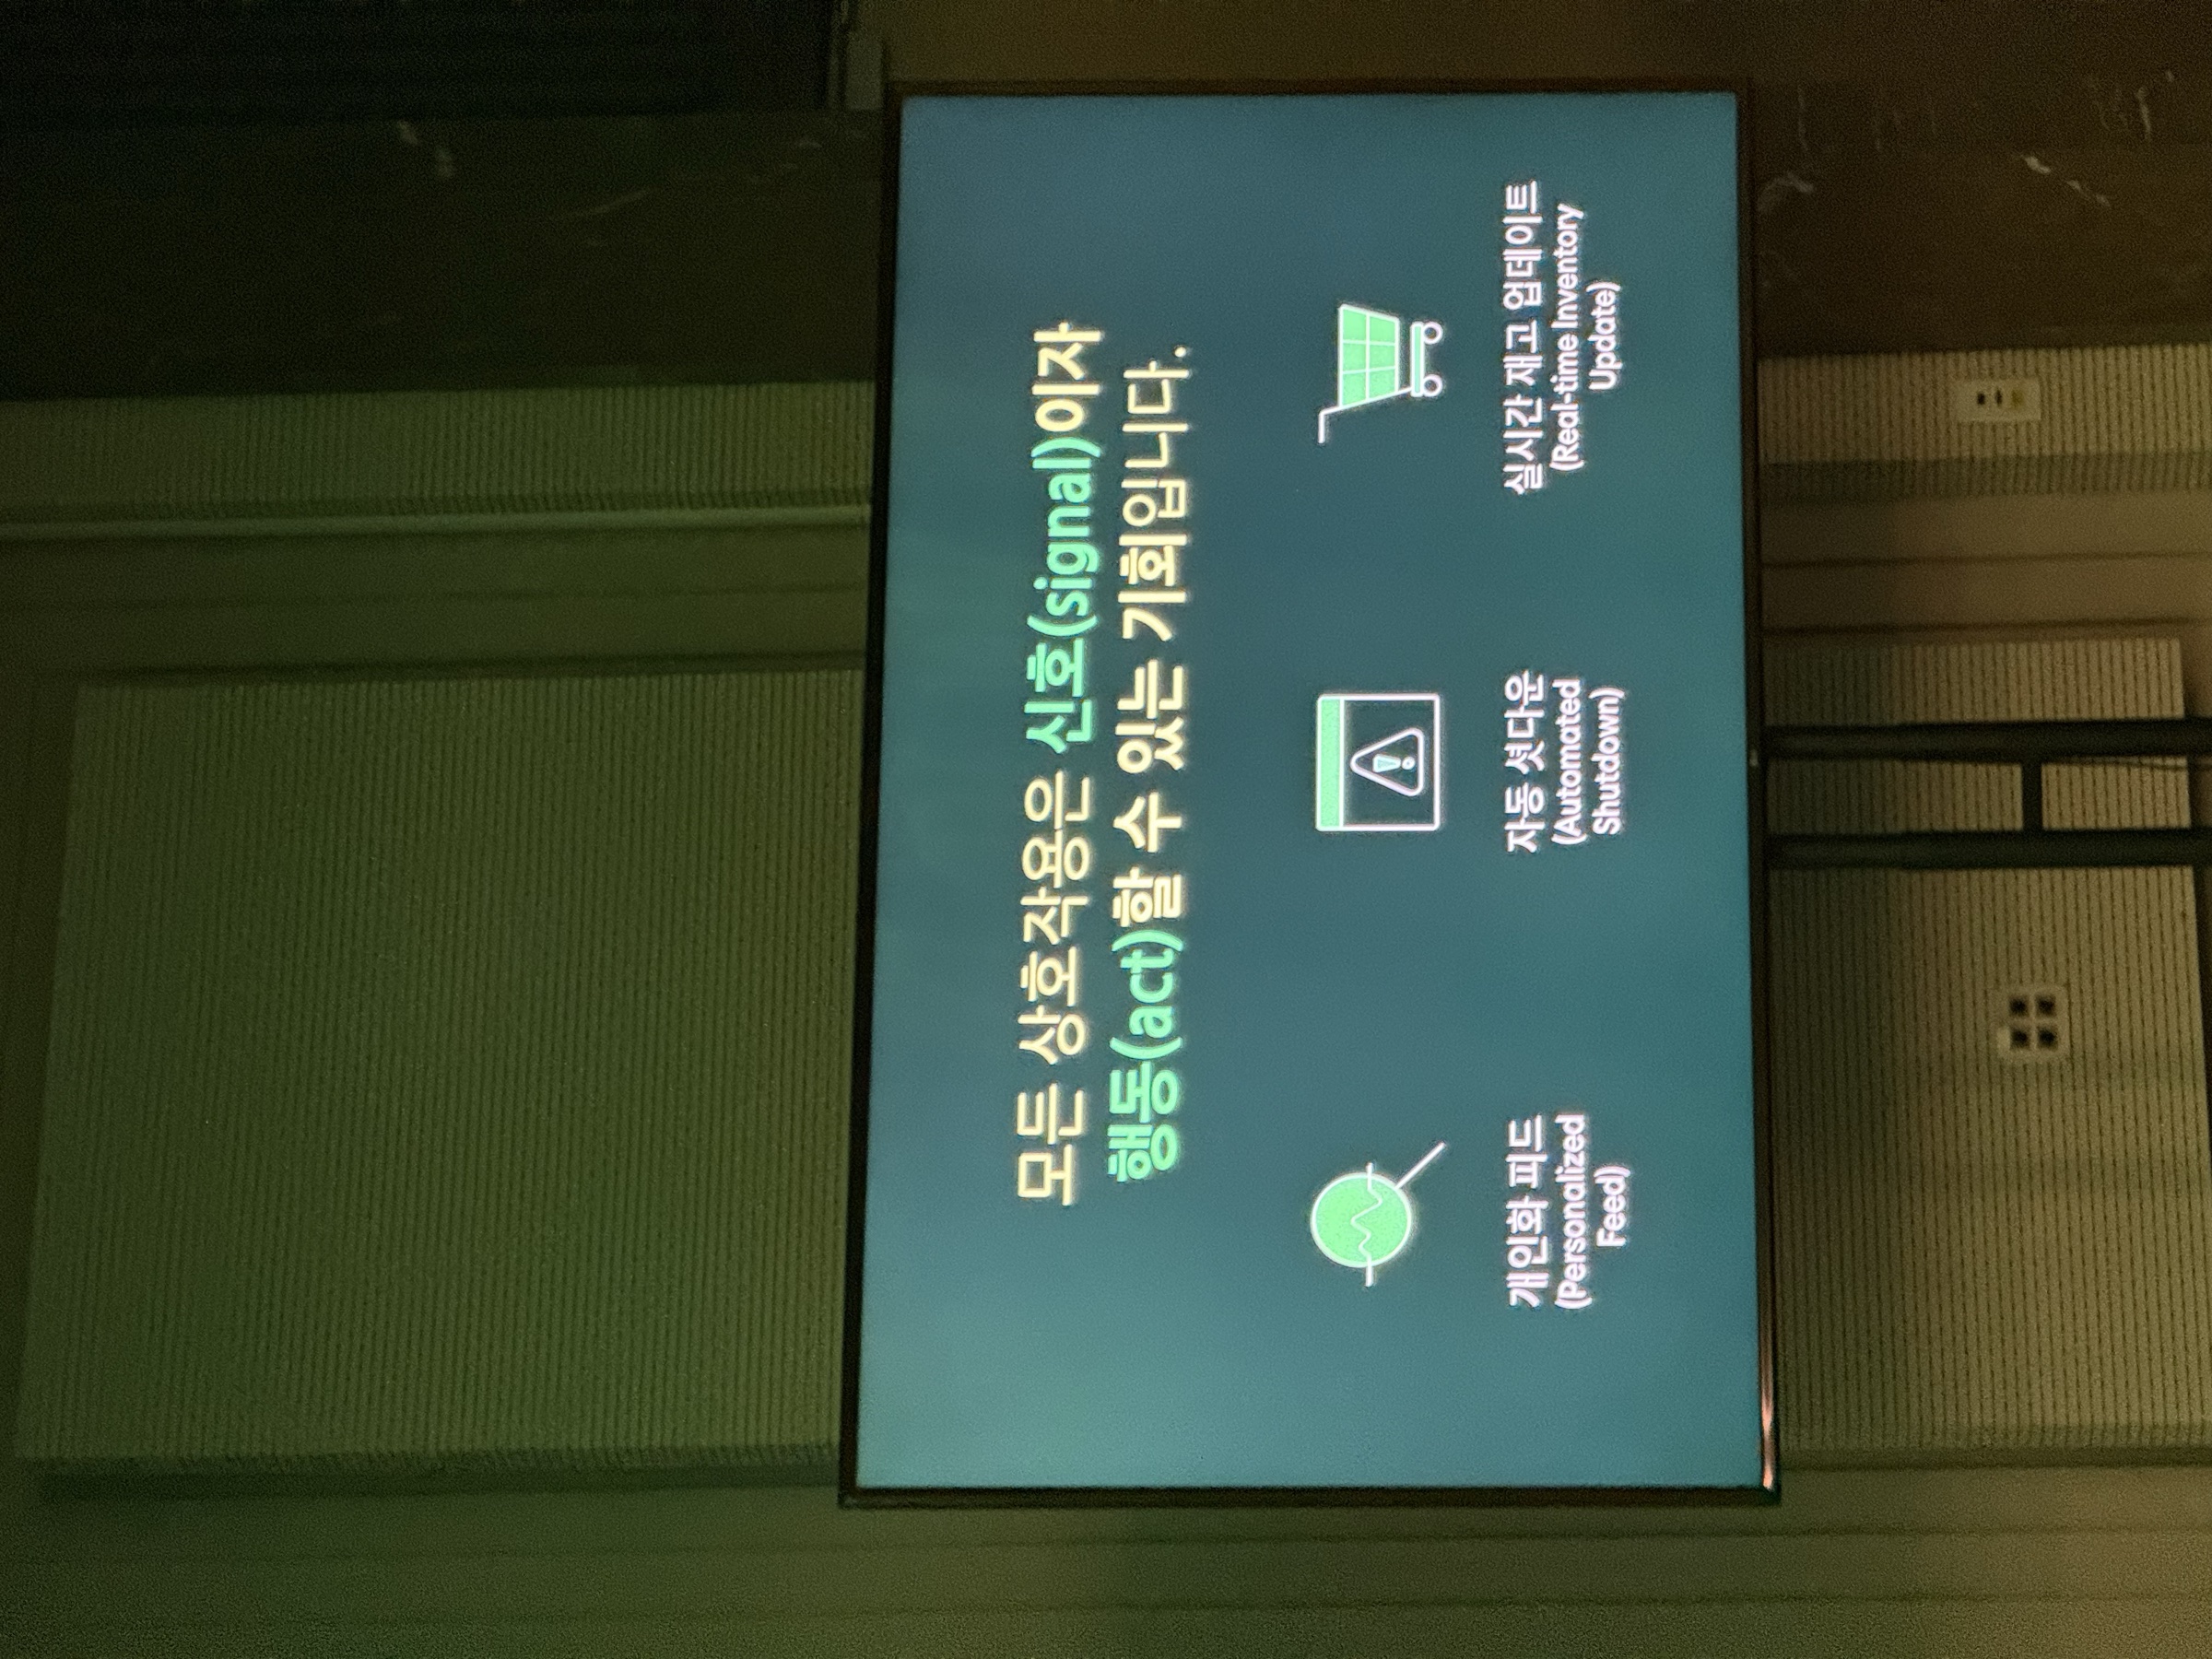
MongoDB 8.1의 $rankFusion은 이 모든 과정을 자동화한다. 개발자는 어떤 검색 방식을 얼마의 가중치로 섞을지만 지정하면 된다.
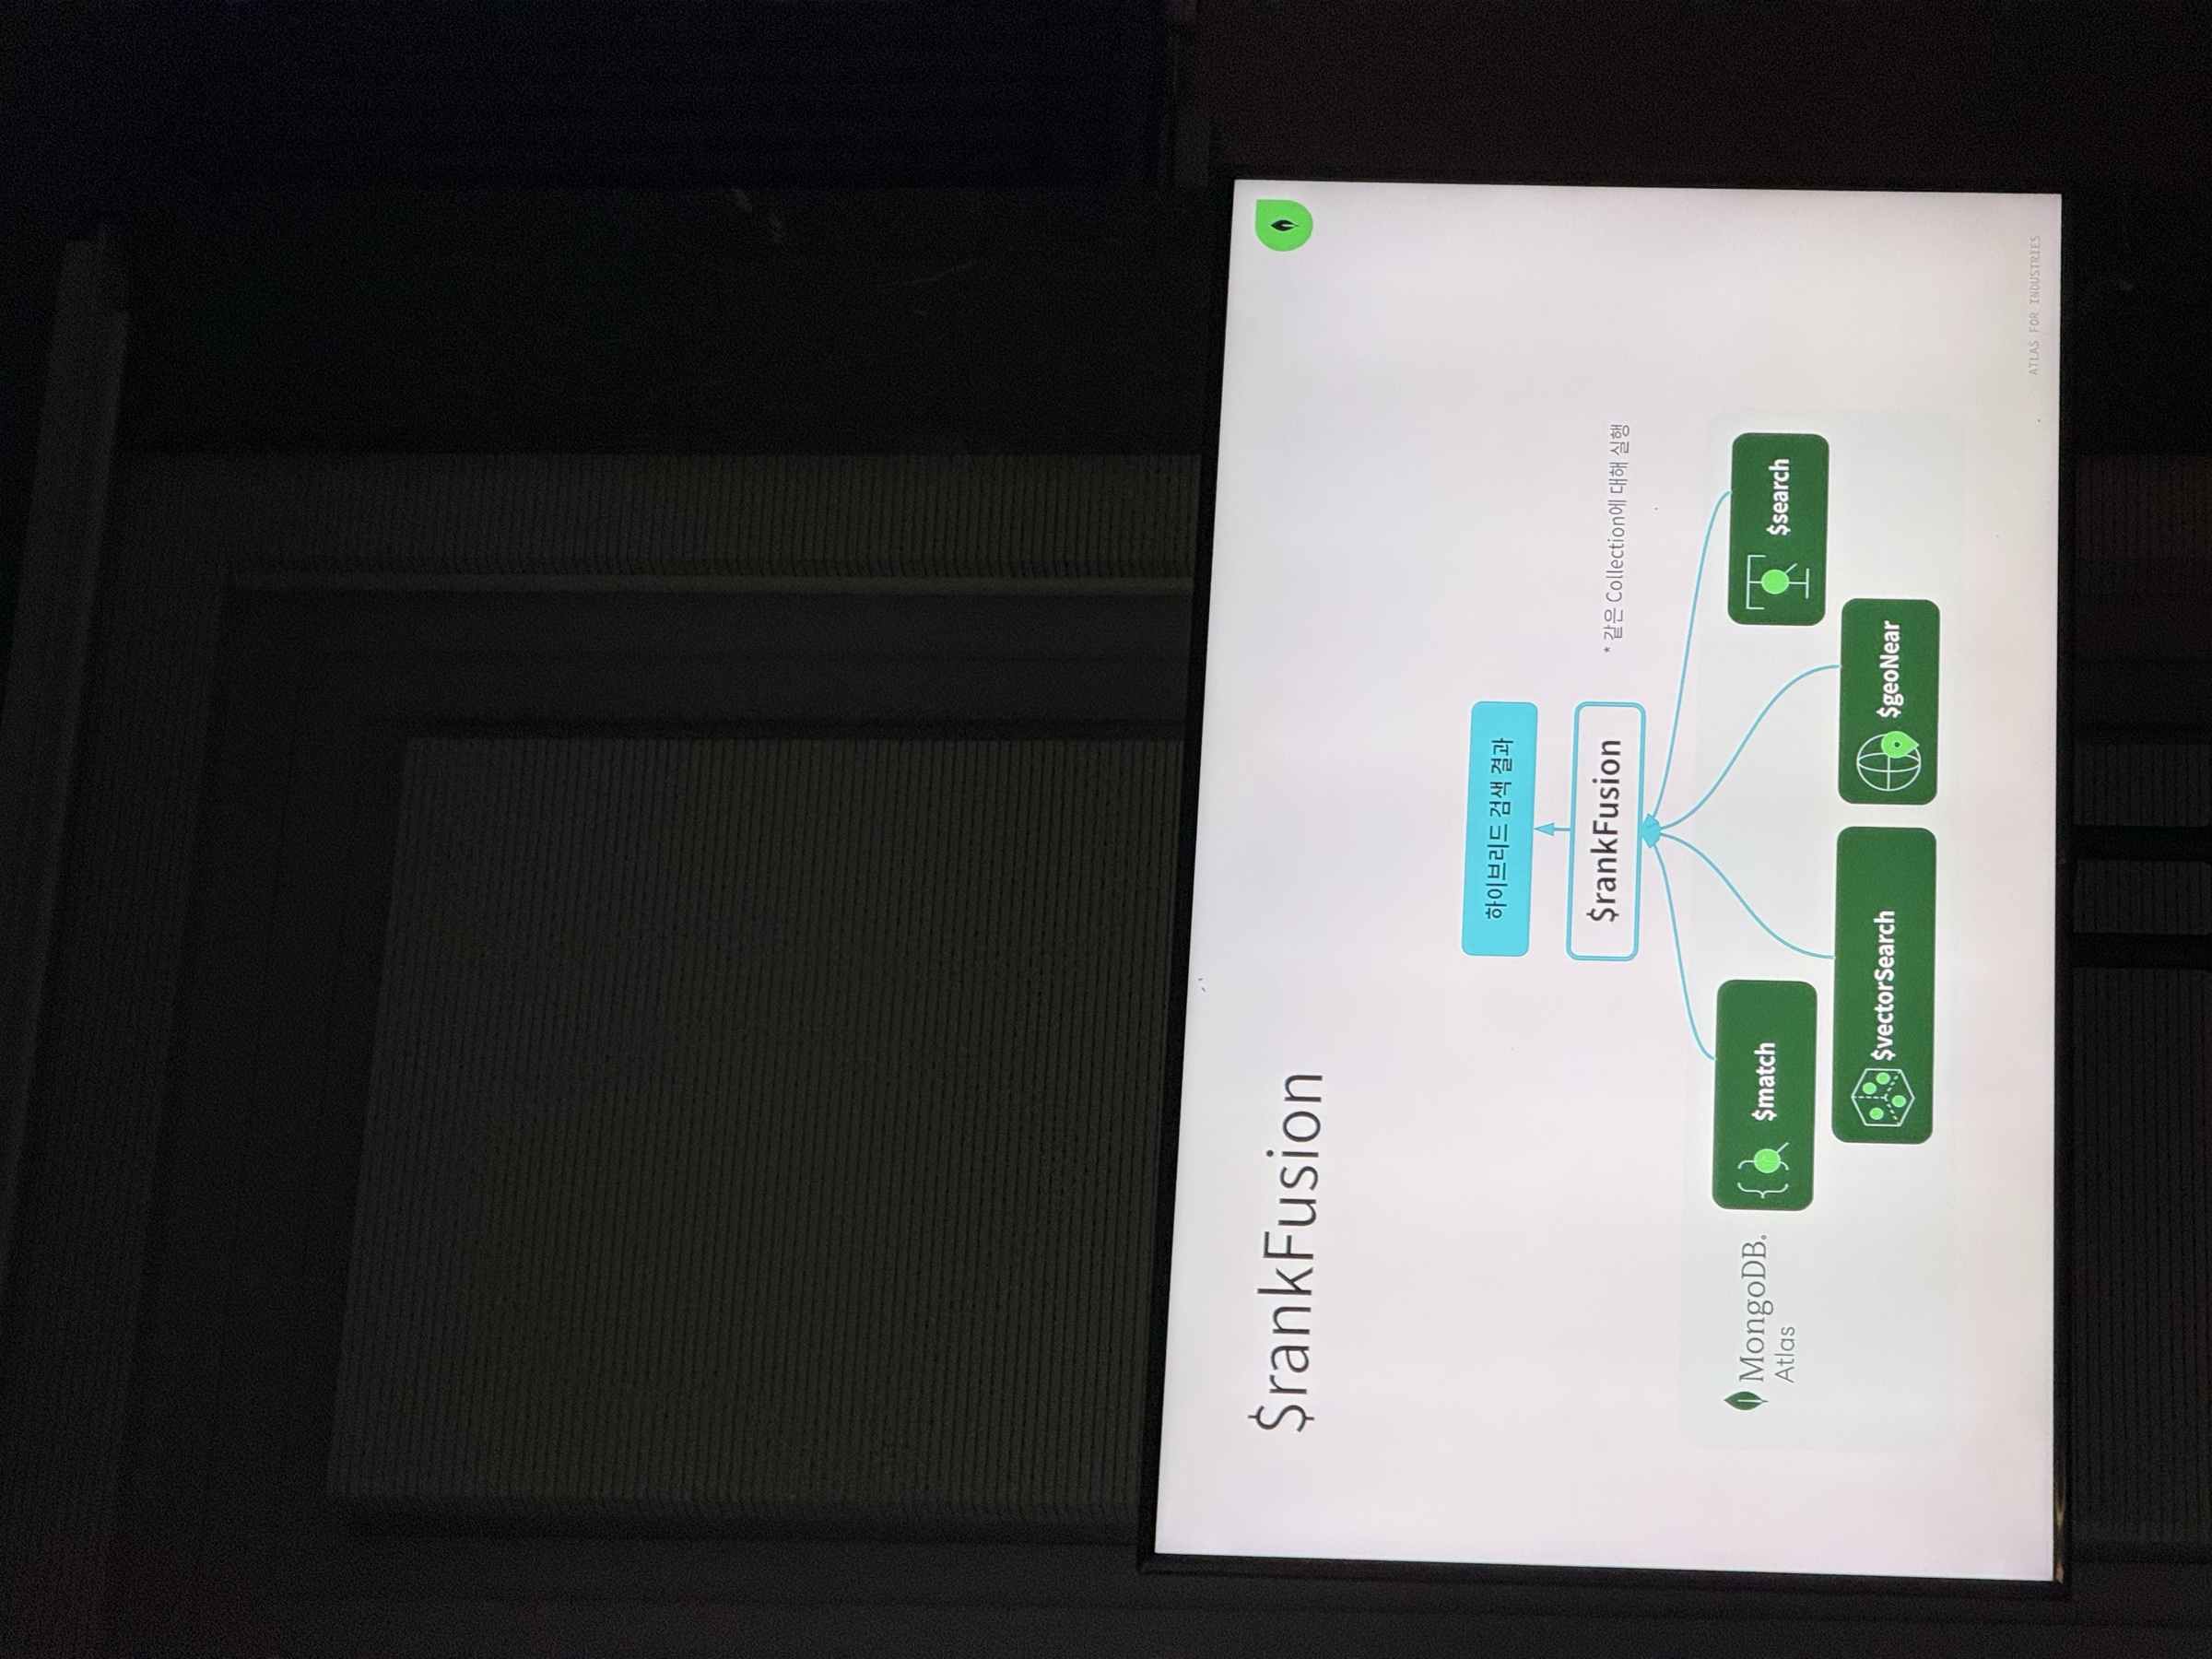
TypeScript
우리 이커머스 프로젝트에 적용하면?
발표자가 든 예시가 딱 우리 상황이었다.
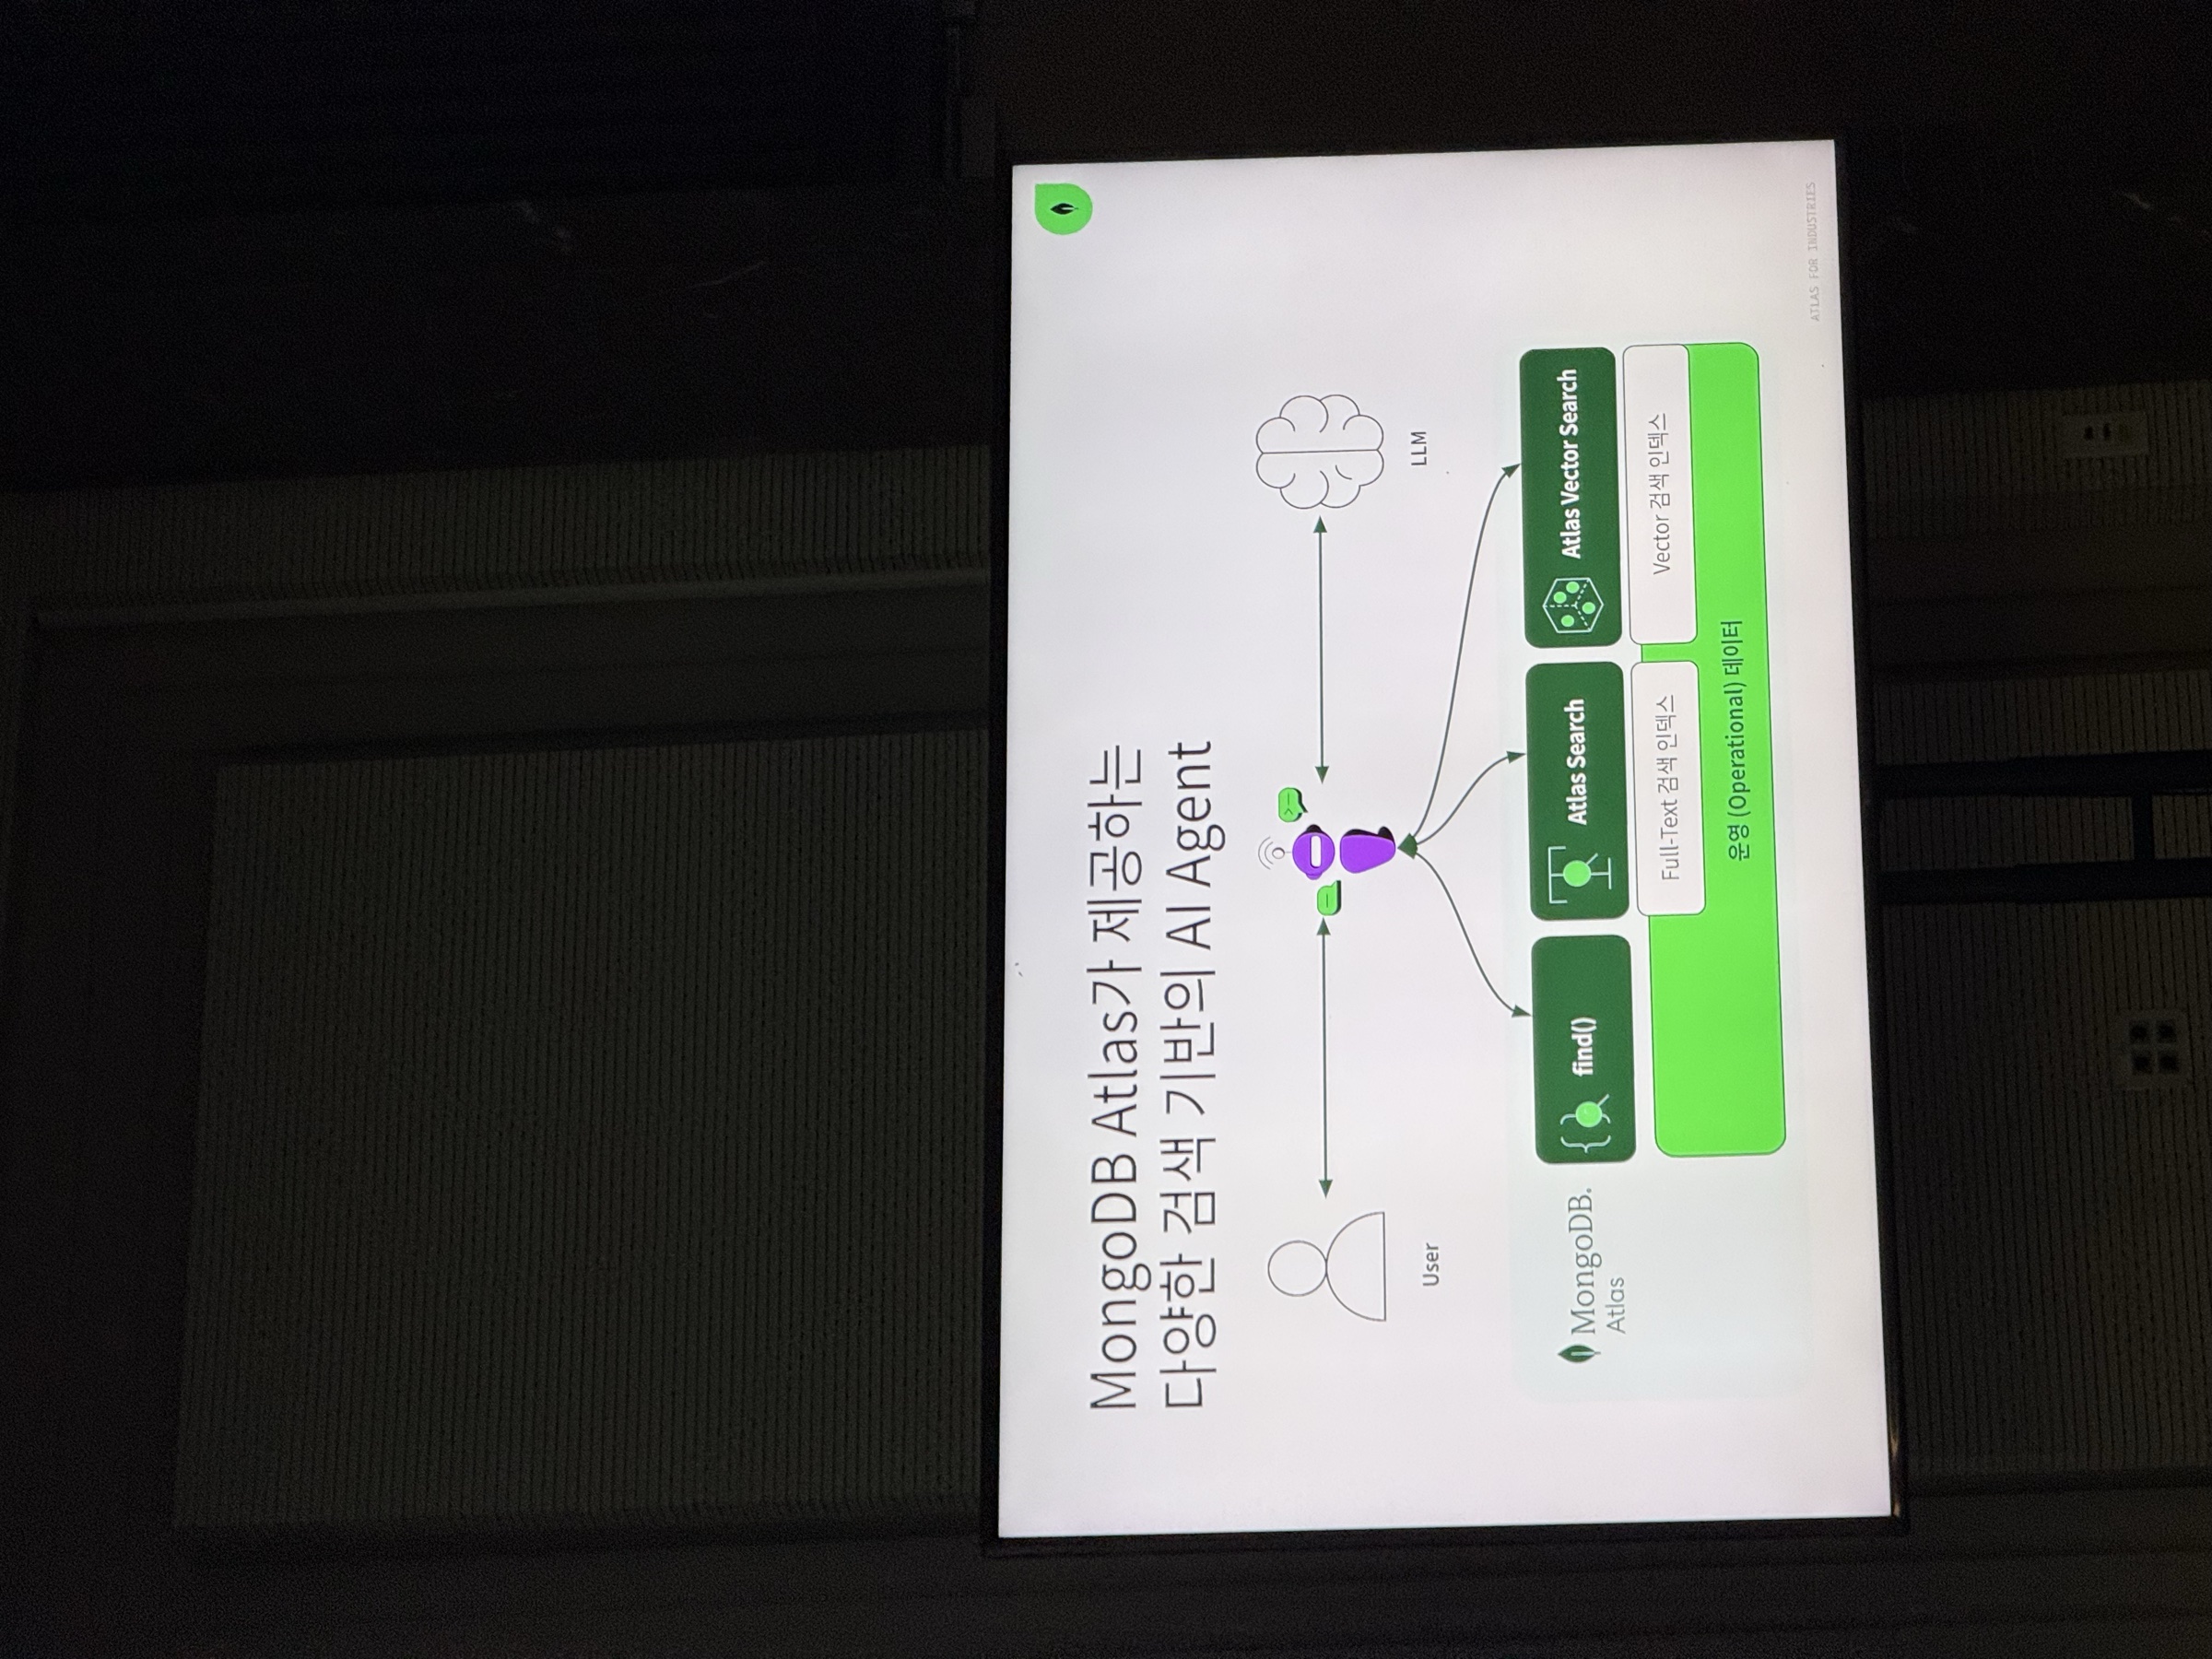
“지난달에 샀던 그 러닝화랑 비슷한 제품 추천해줘”라는 요청을 처리한다고 생각해보자.
TypeScript
RAG의 진화 - Naive에서 Agentic까지
RAG(Retrieval-Augmented Generation)는 AI가 답변을 생성하기 전에, 먼저 관련 정보를 데이터베이스에서 검색하여 그 내용을 바탕으로 더 정확한 답변을 만드는 기술이다. 이 기술은 3단계로 진화한다.
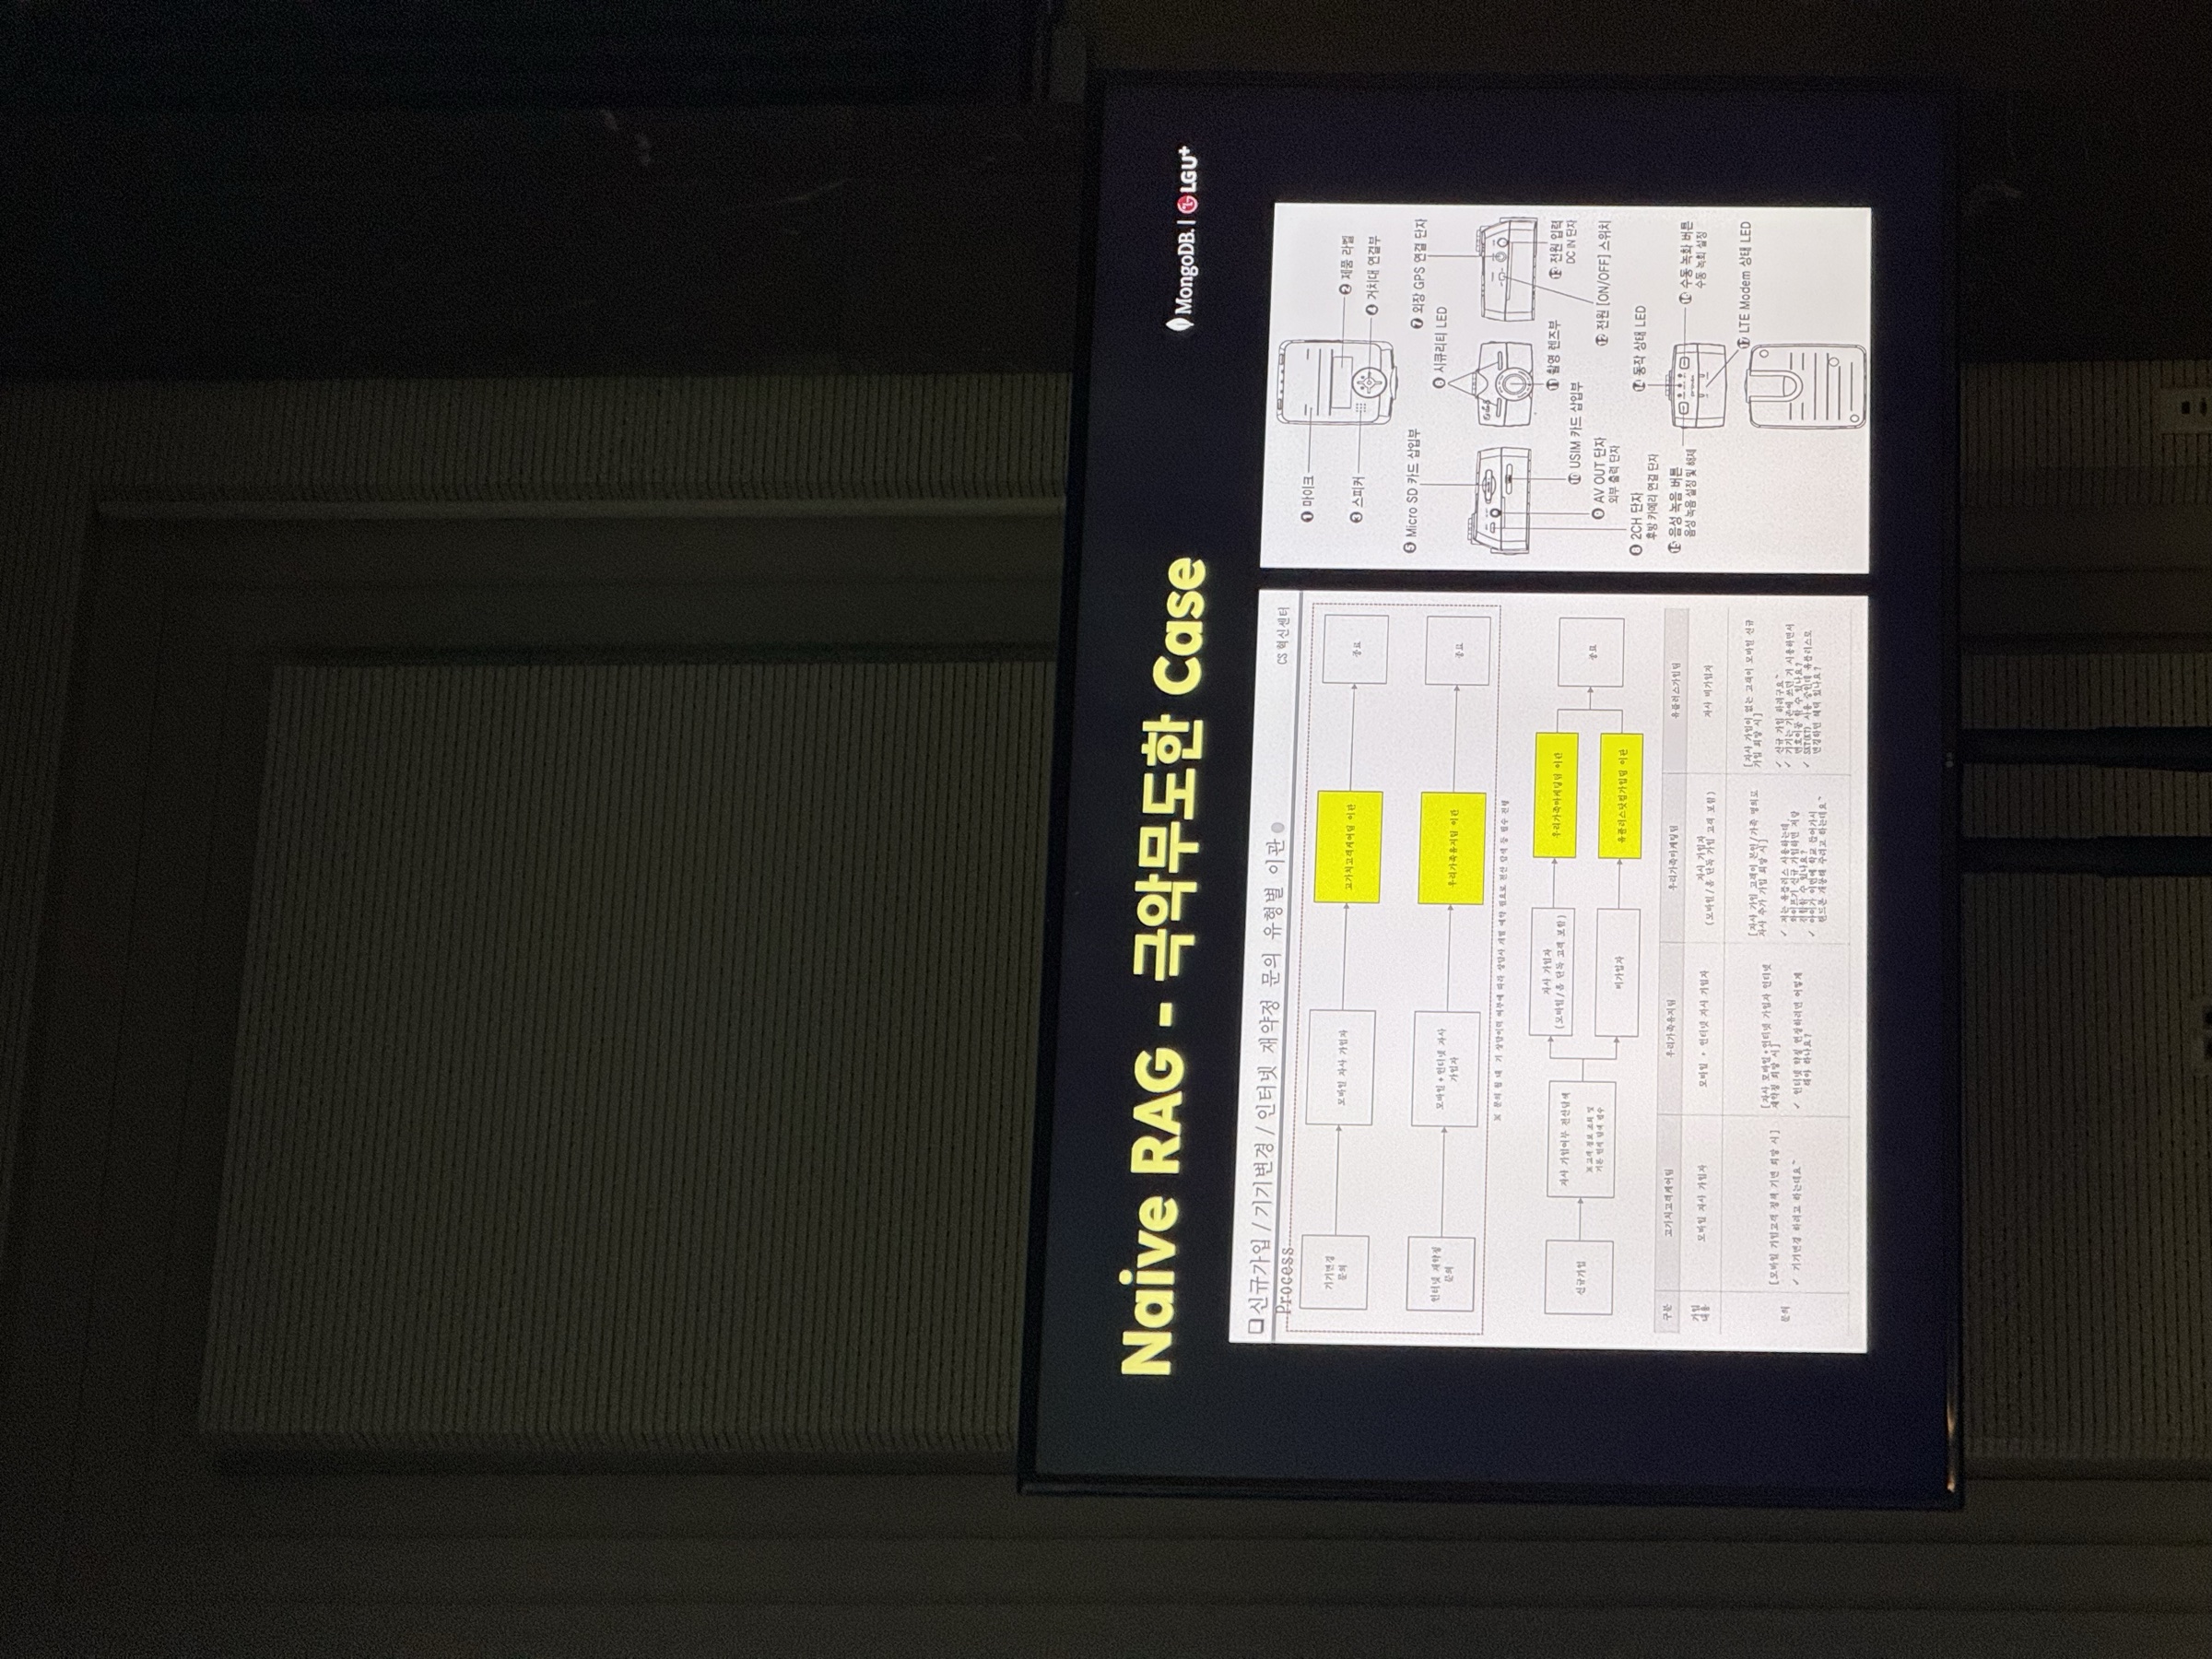
1단계: Naive RAG (단순 검색 후 답변)
가장 기초적인 RAG. 단순히 질문과 관련 있어 보이는 문서를 찾아 그 내용을 그대로 LLM(거대 언어 모델)에게 전달하여 답변을 생성하게 한다.
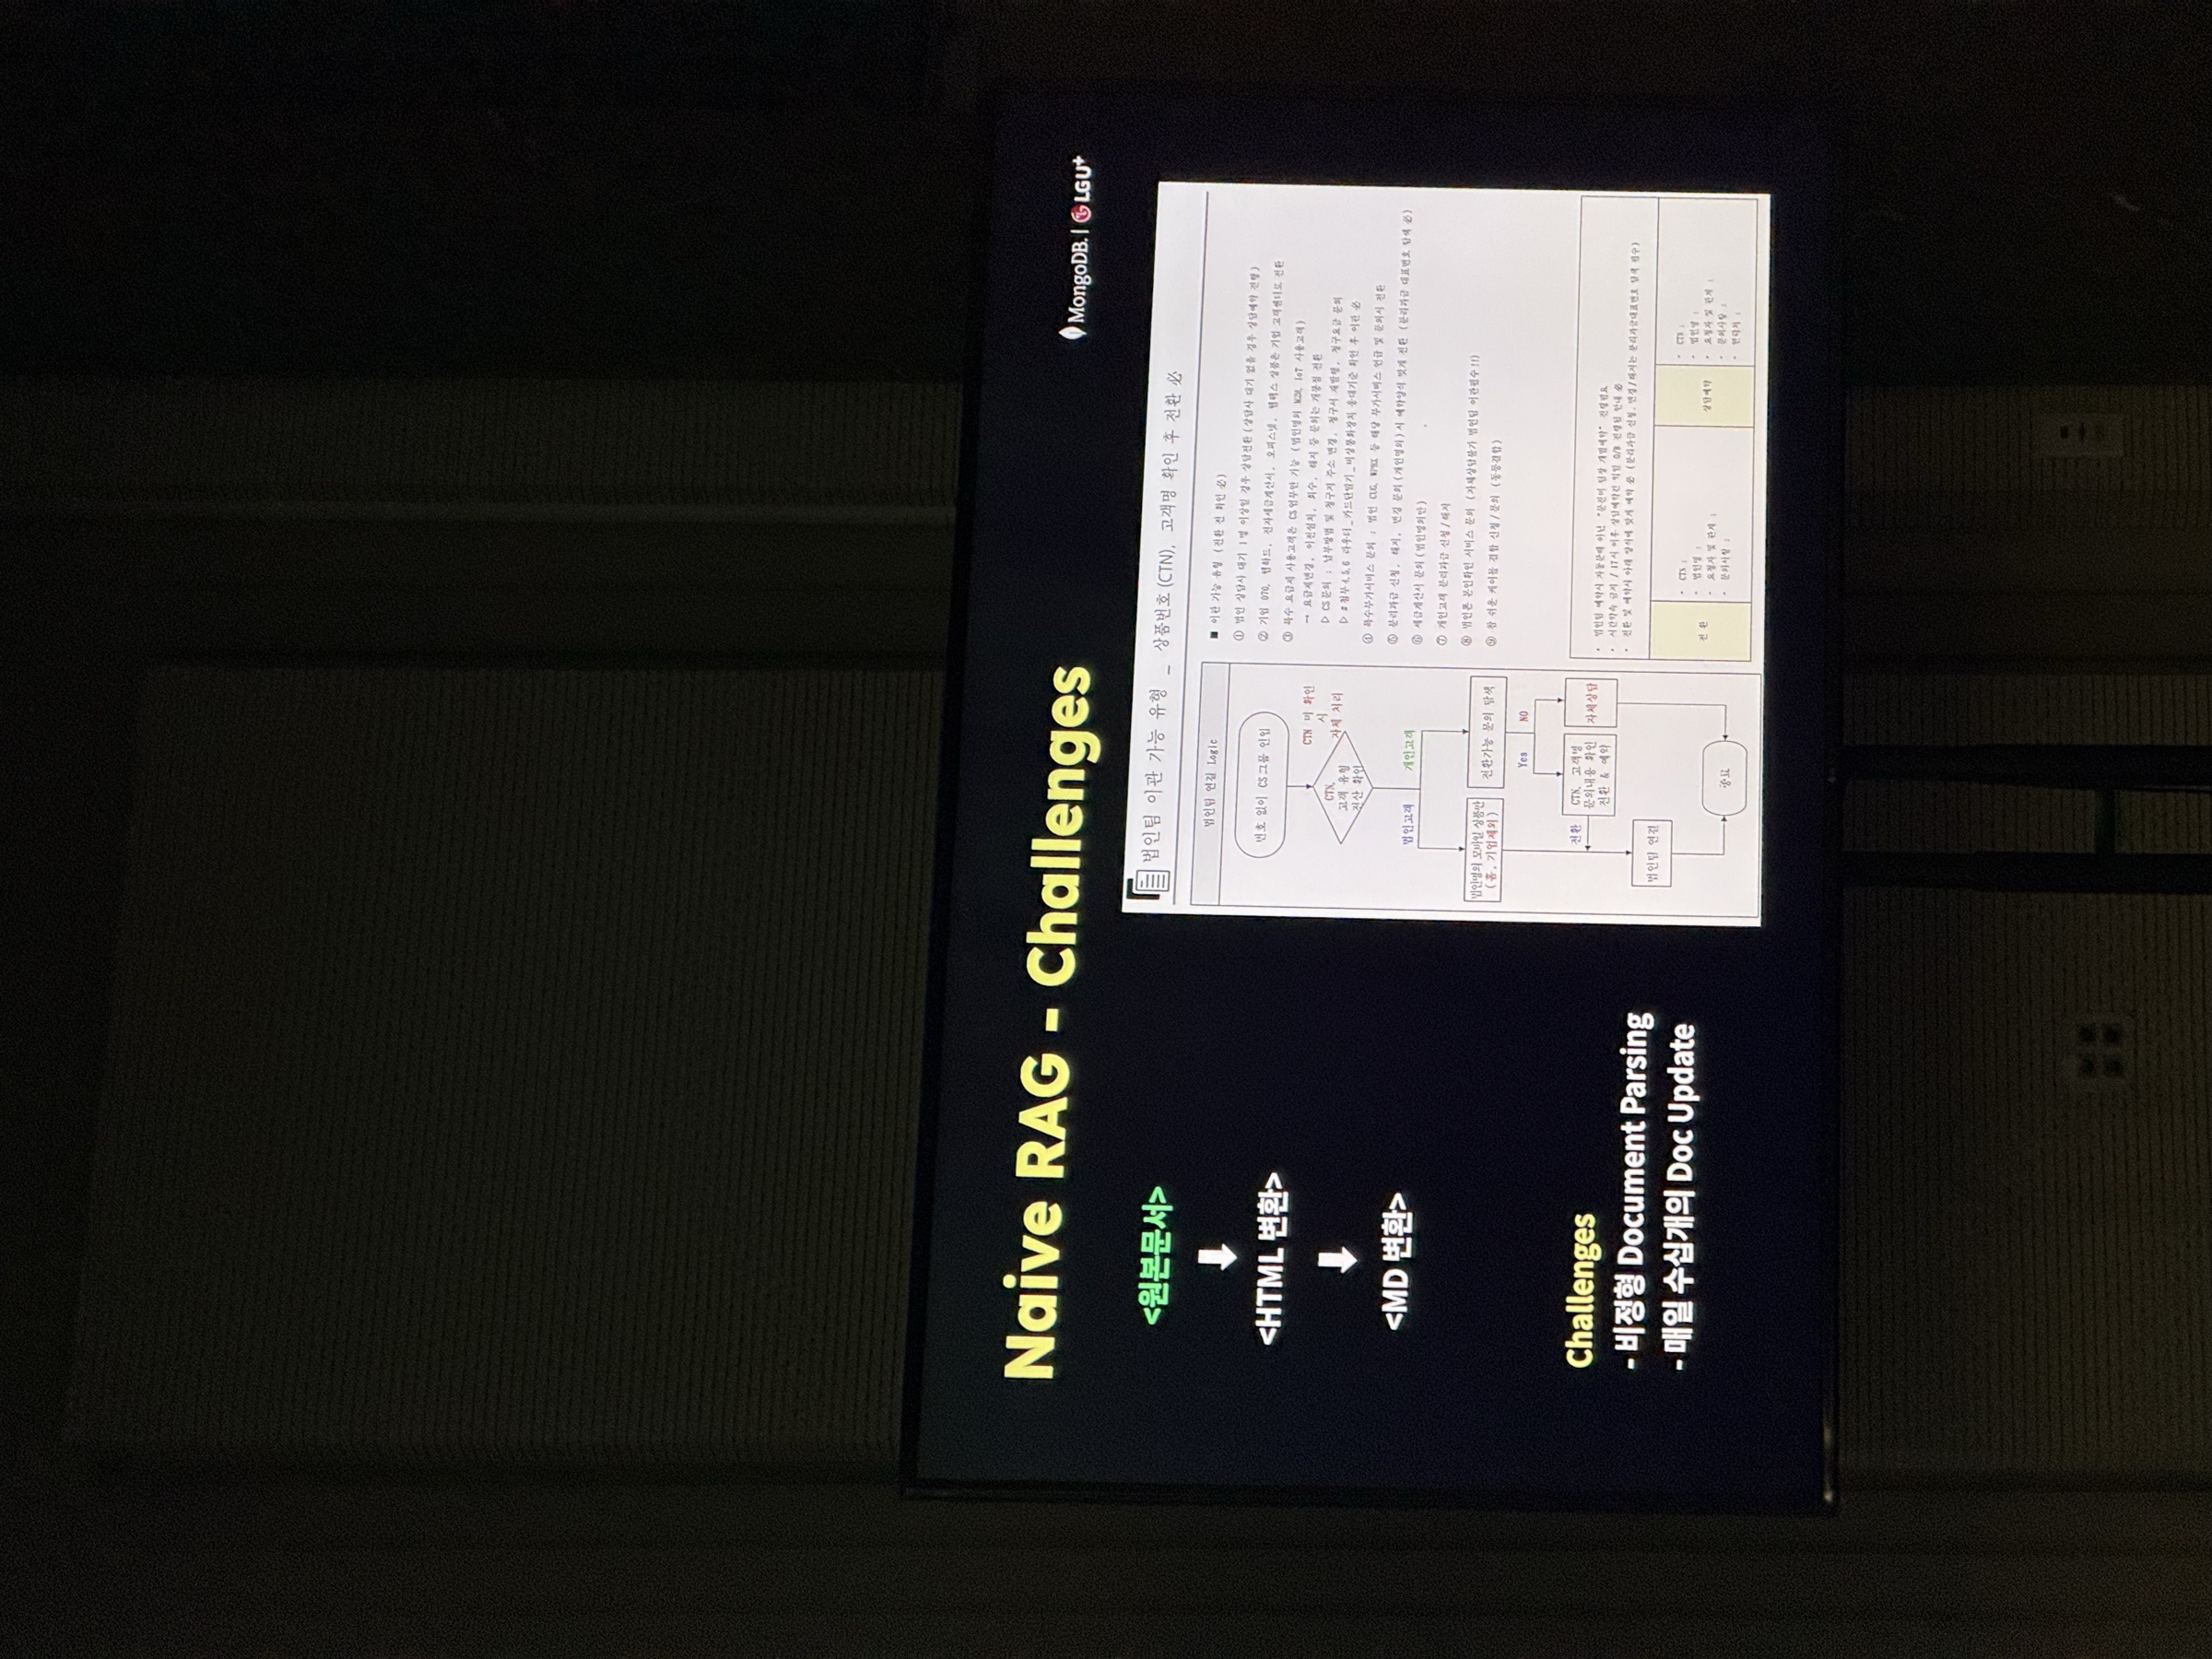
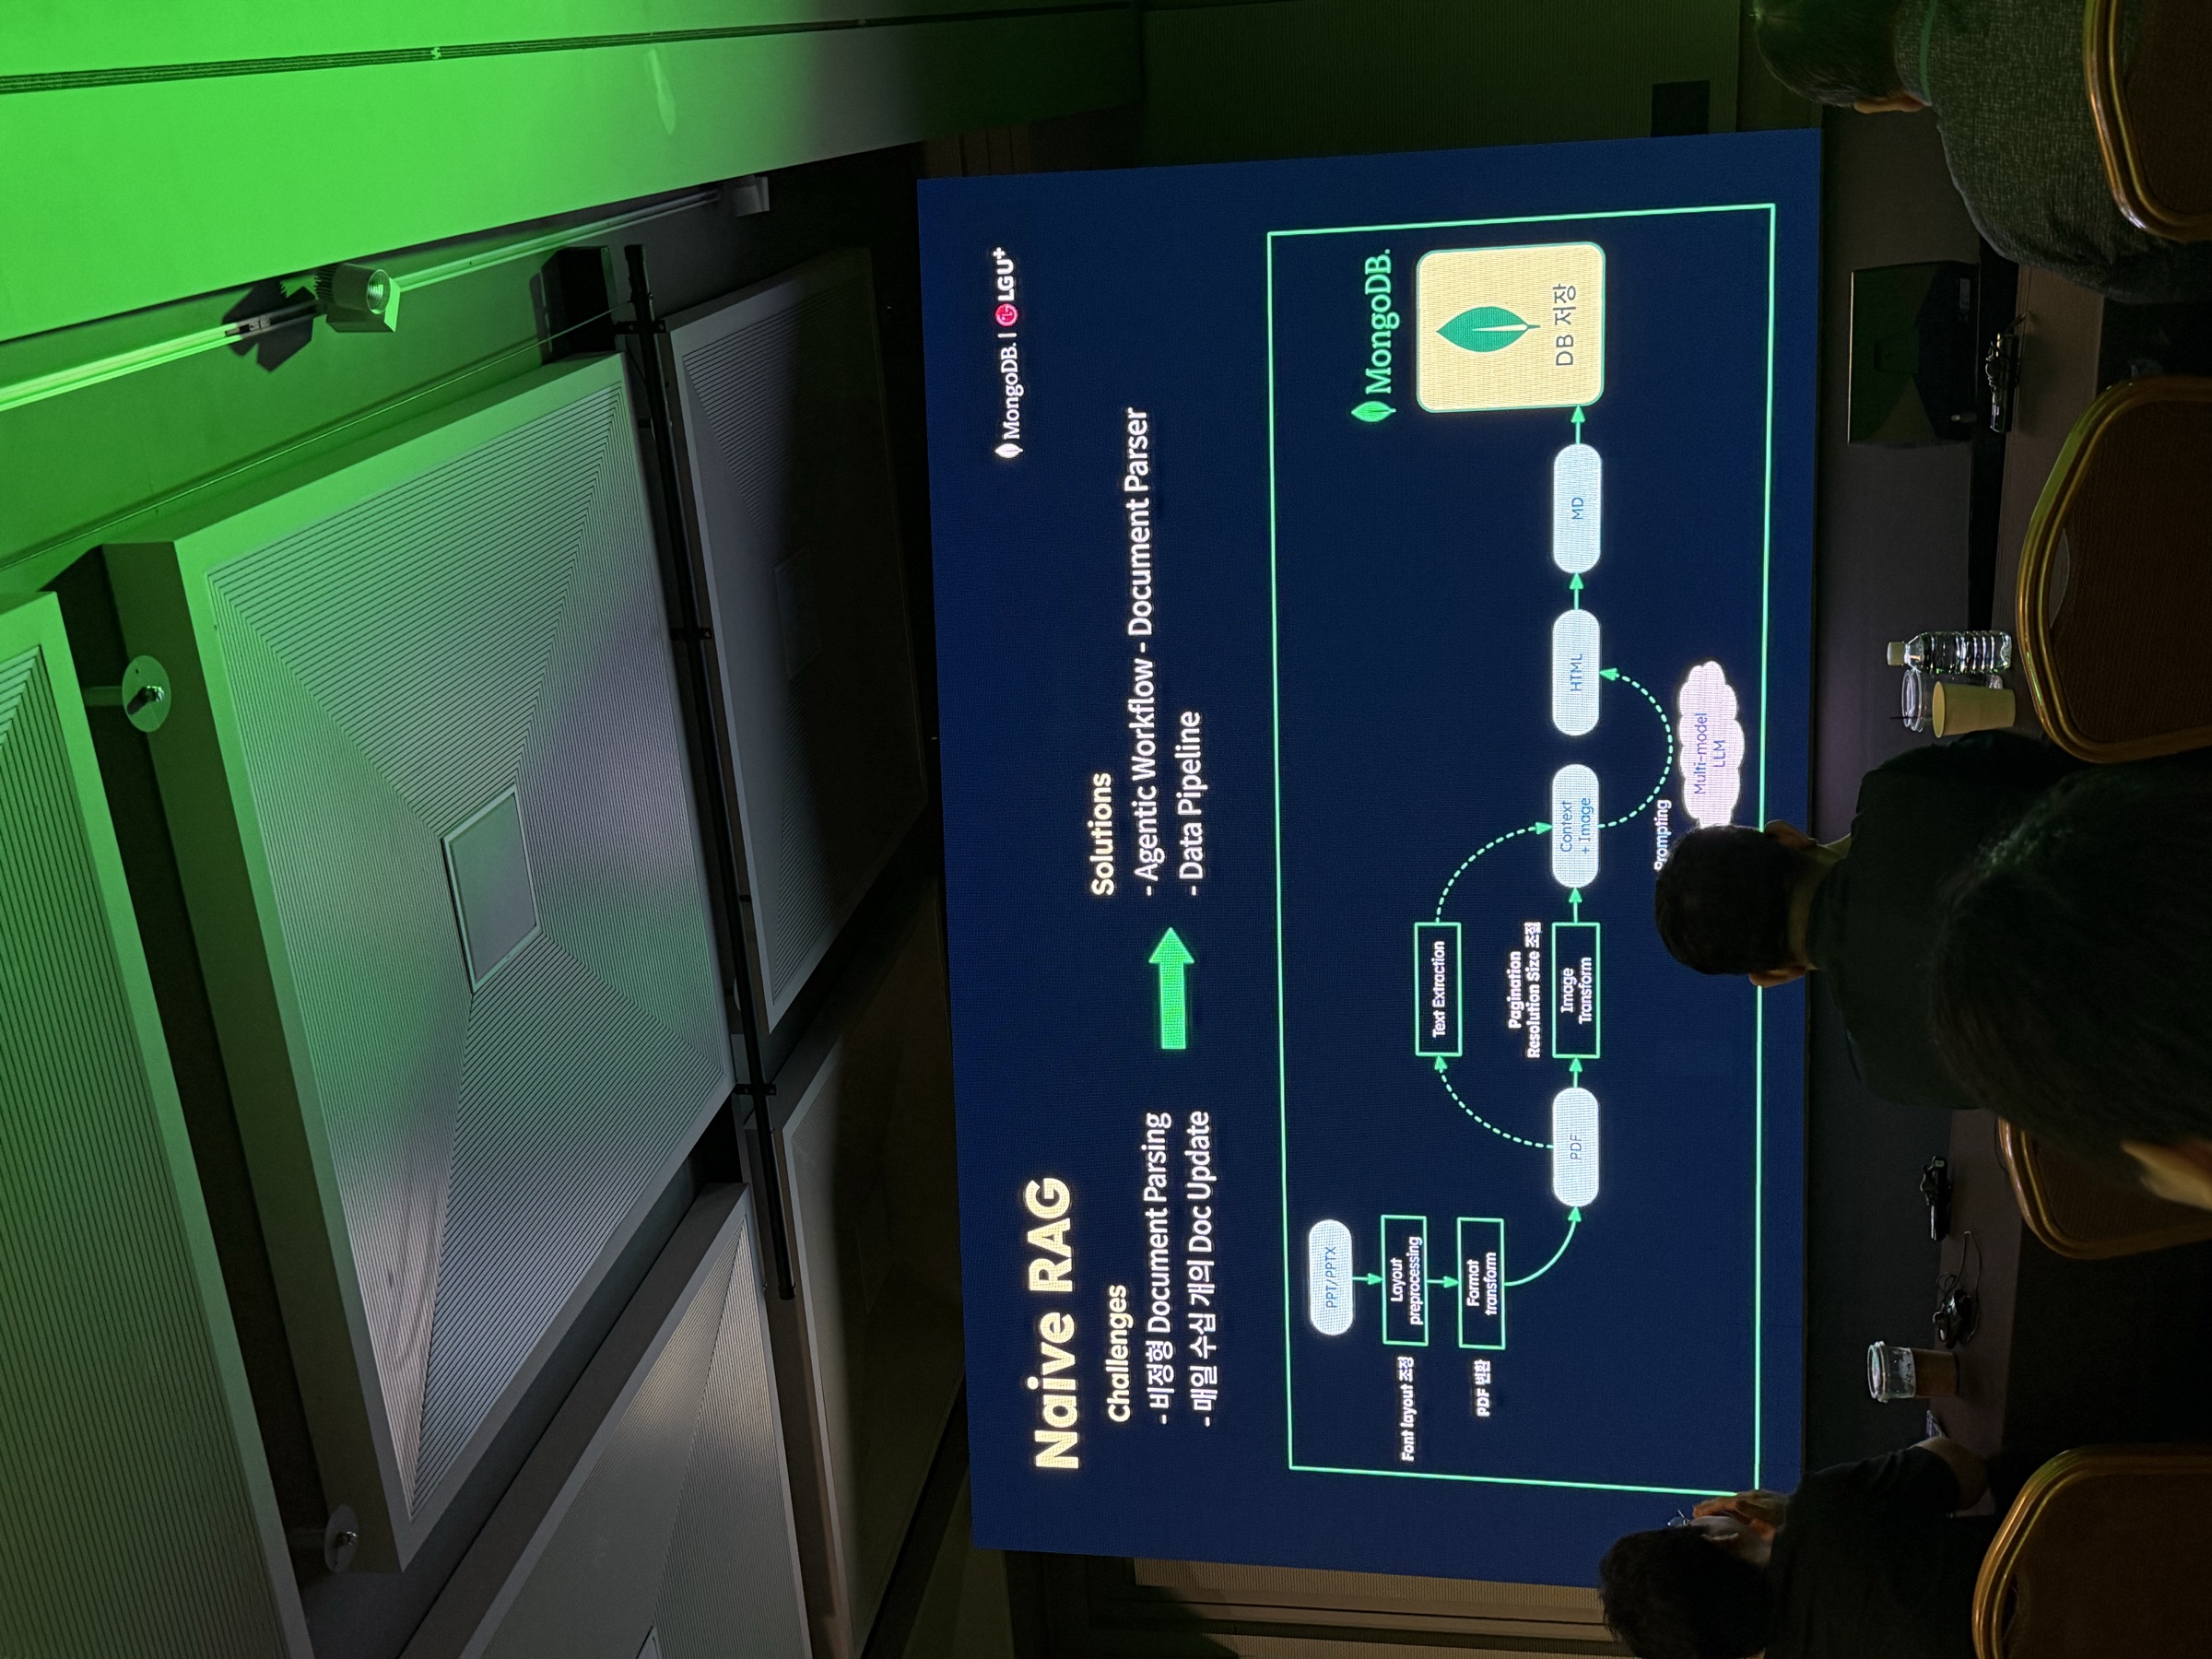
- 문제점: 관련 없는 내용이 섞여 들어가거나, 중요한 맥락이 잘리는 등 답변의 품질이 낮고 환각(hallucination) 현상이 발생하기 쉽다.
TypeScript
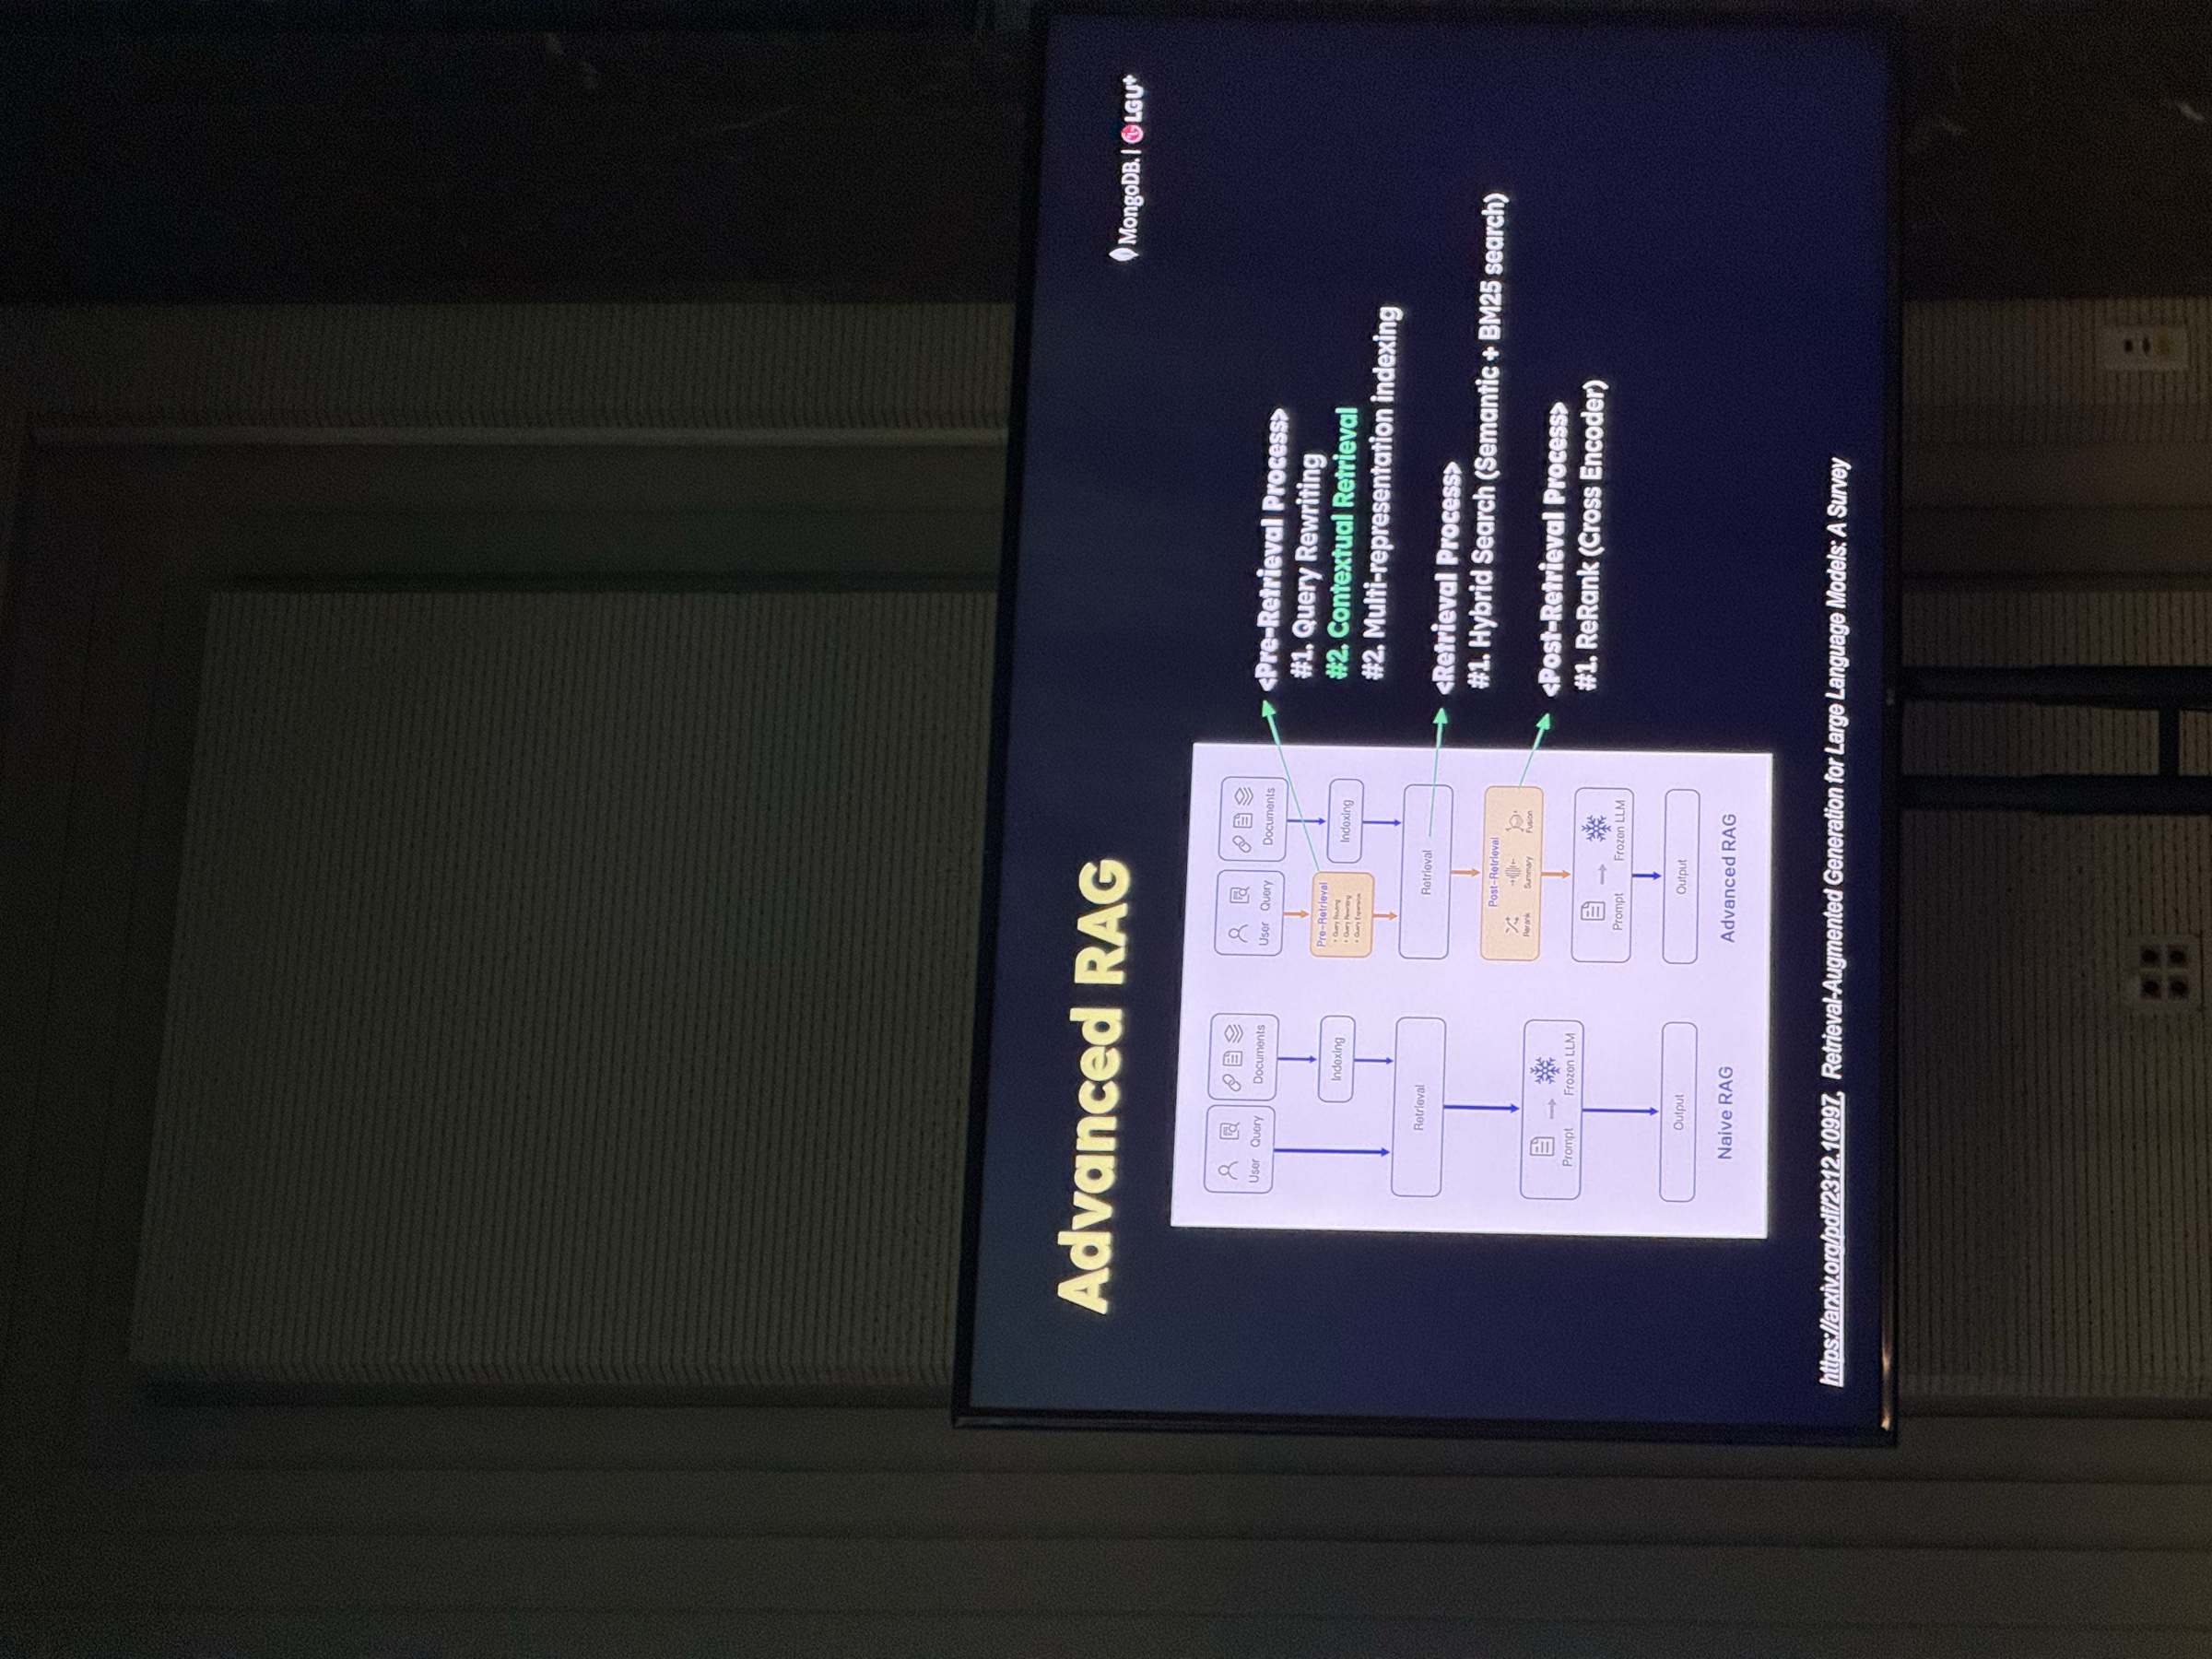
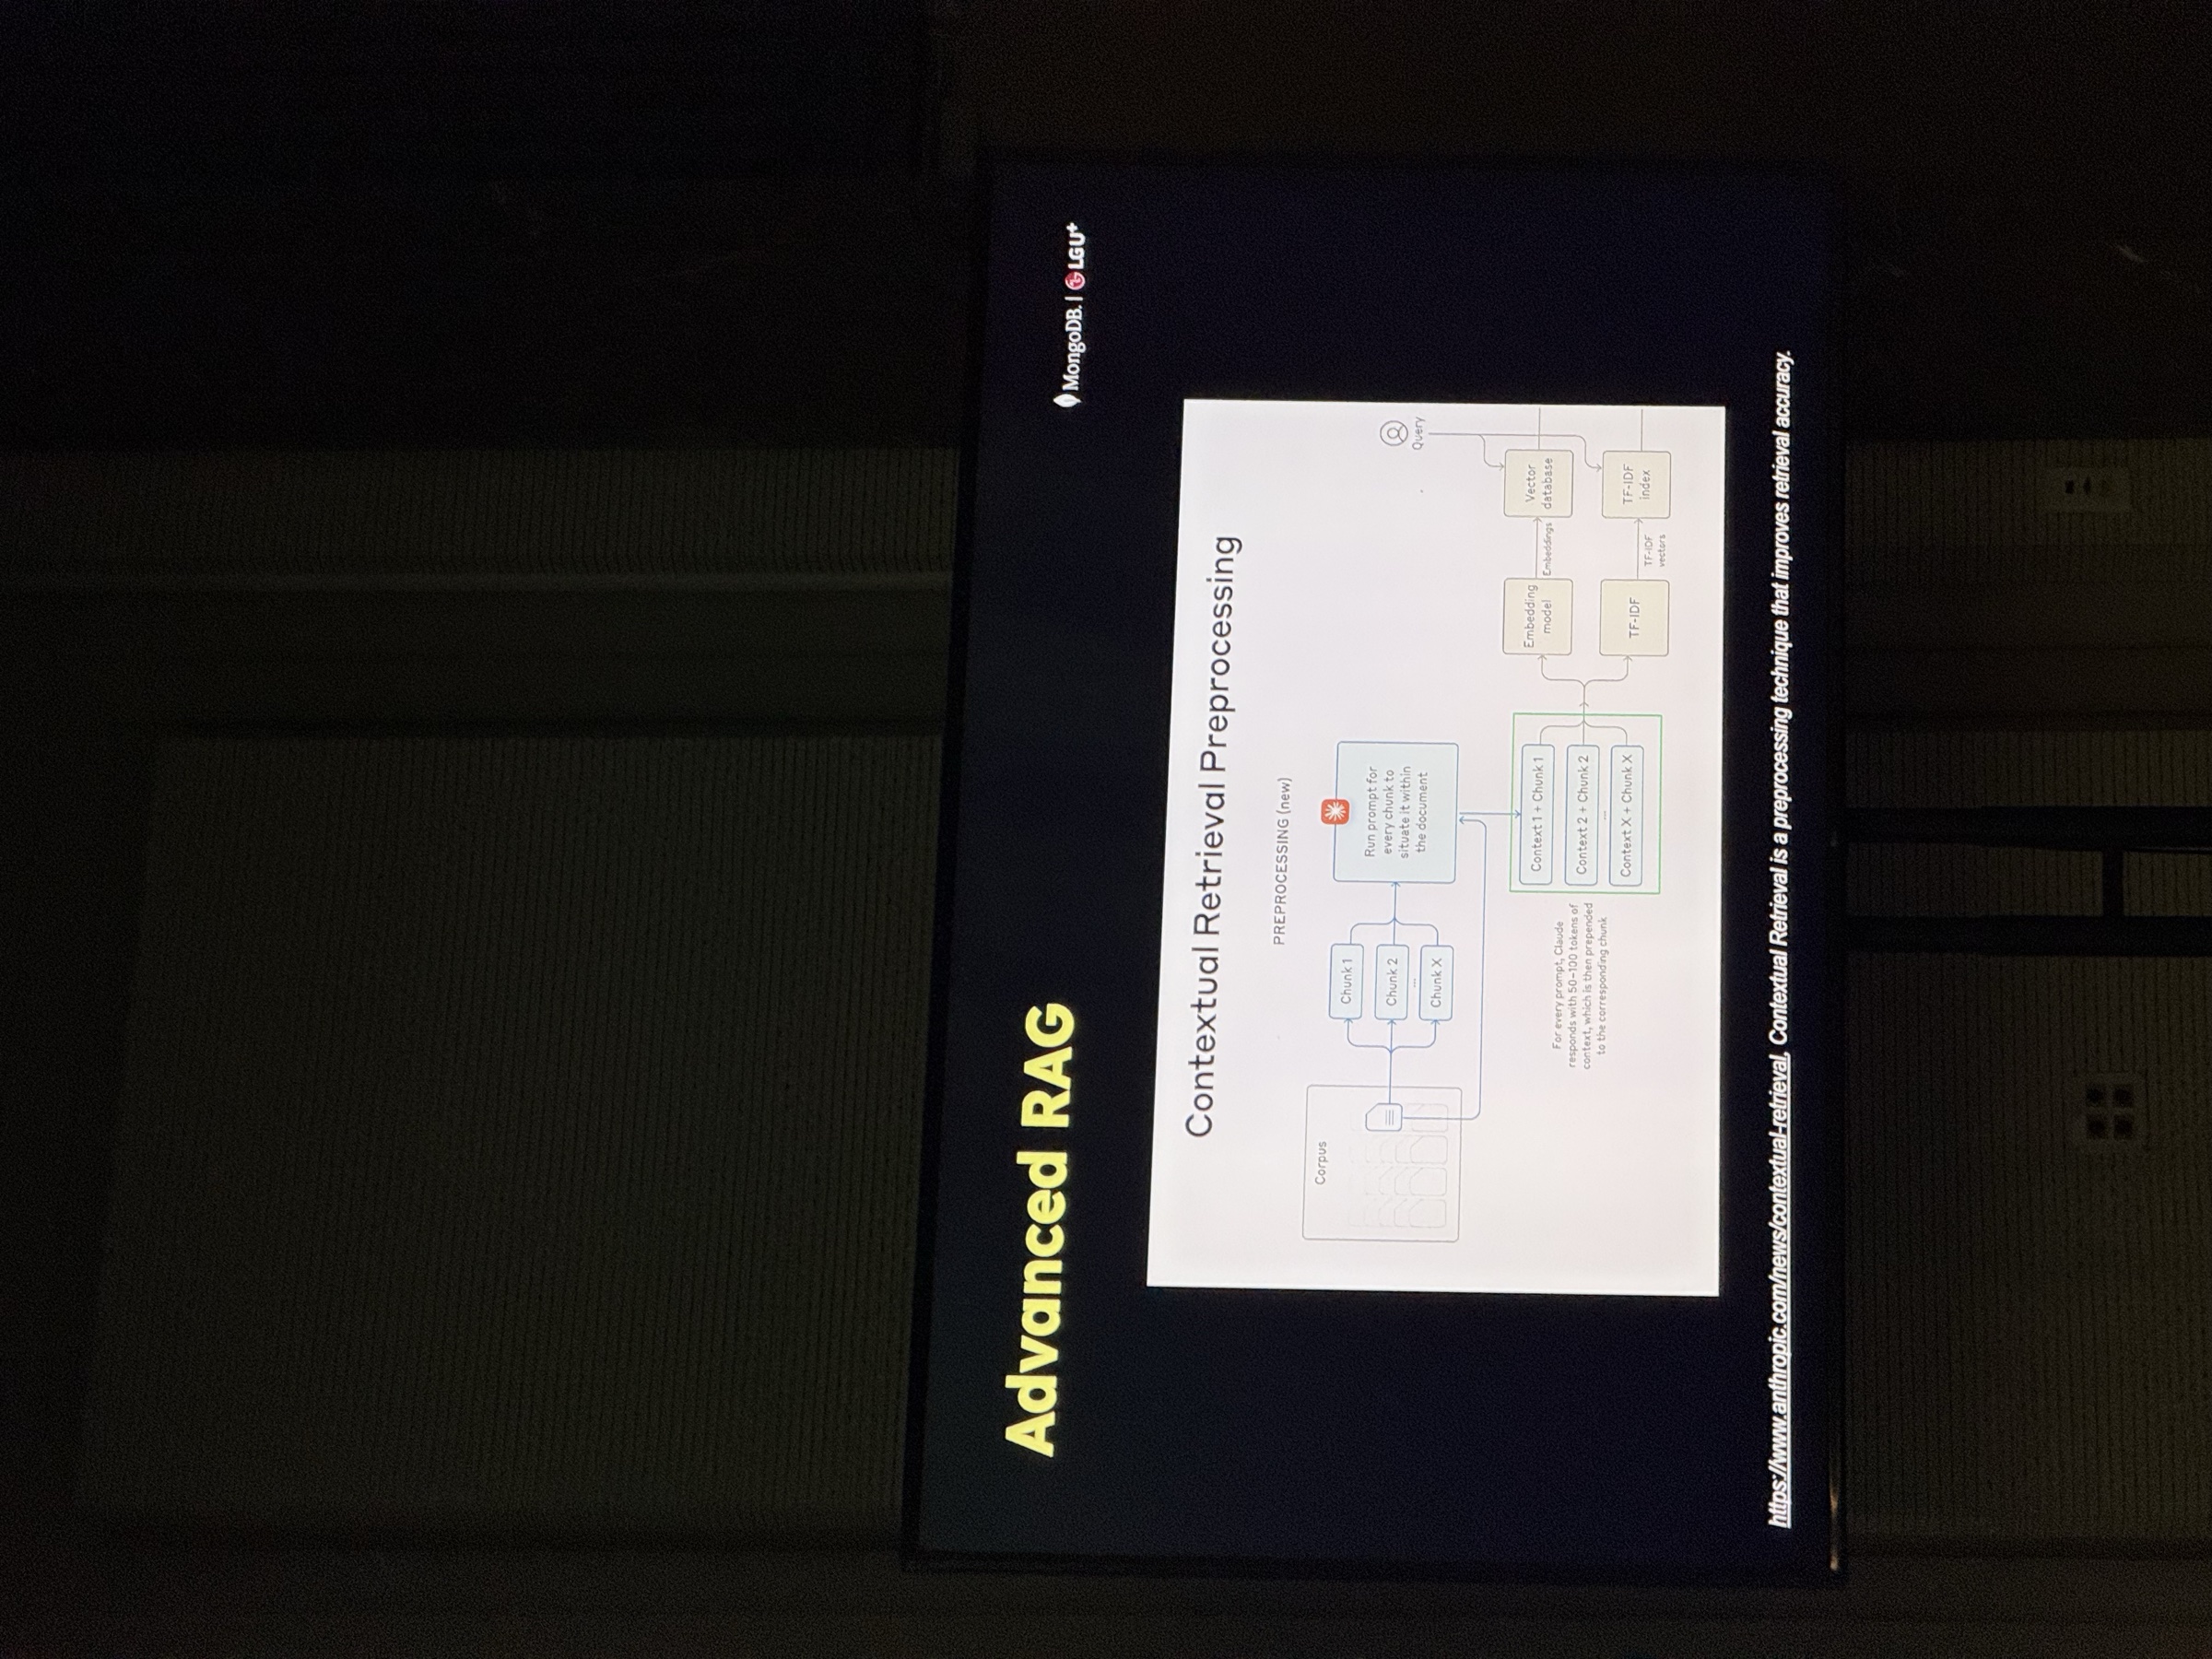
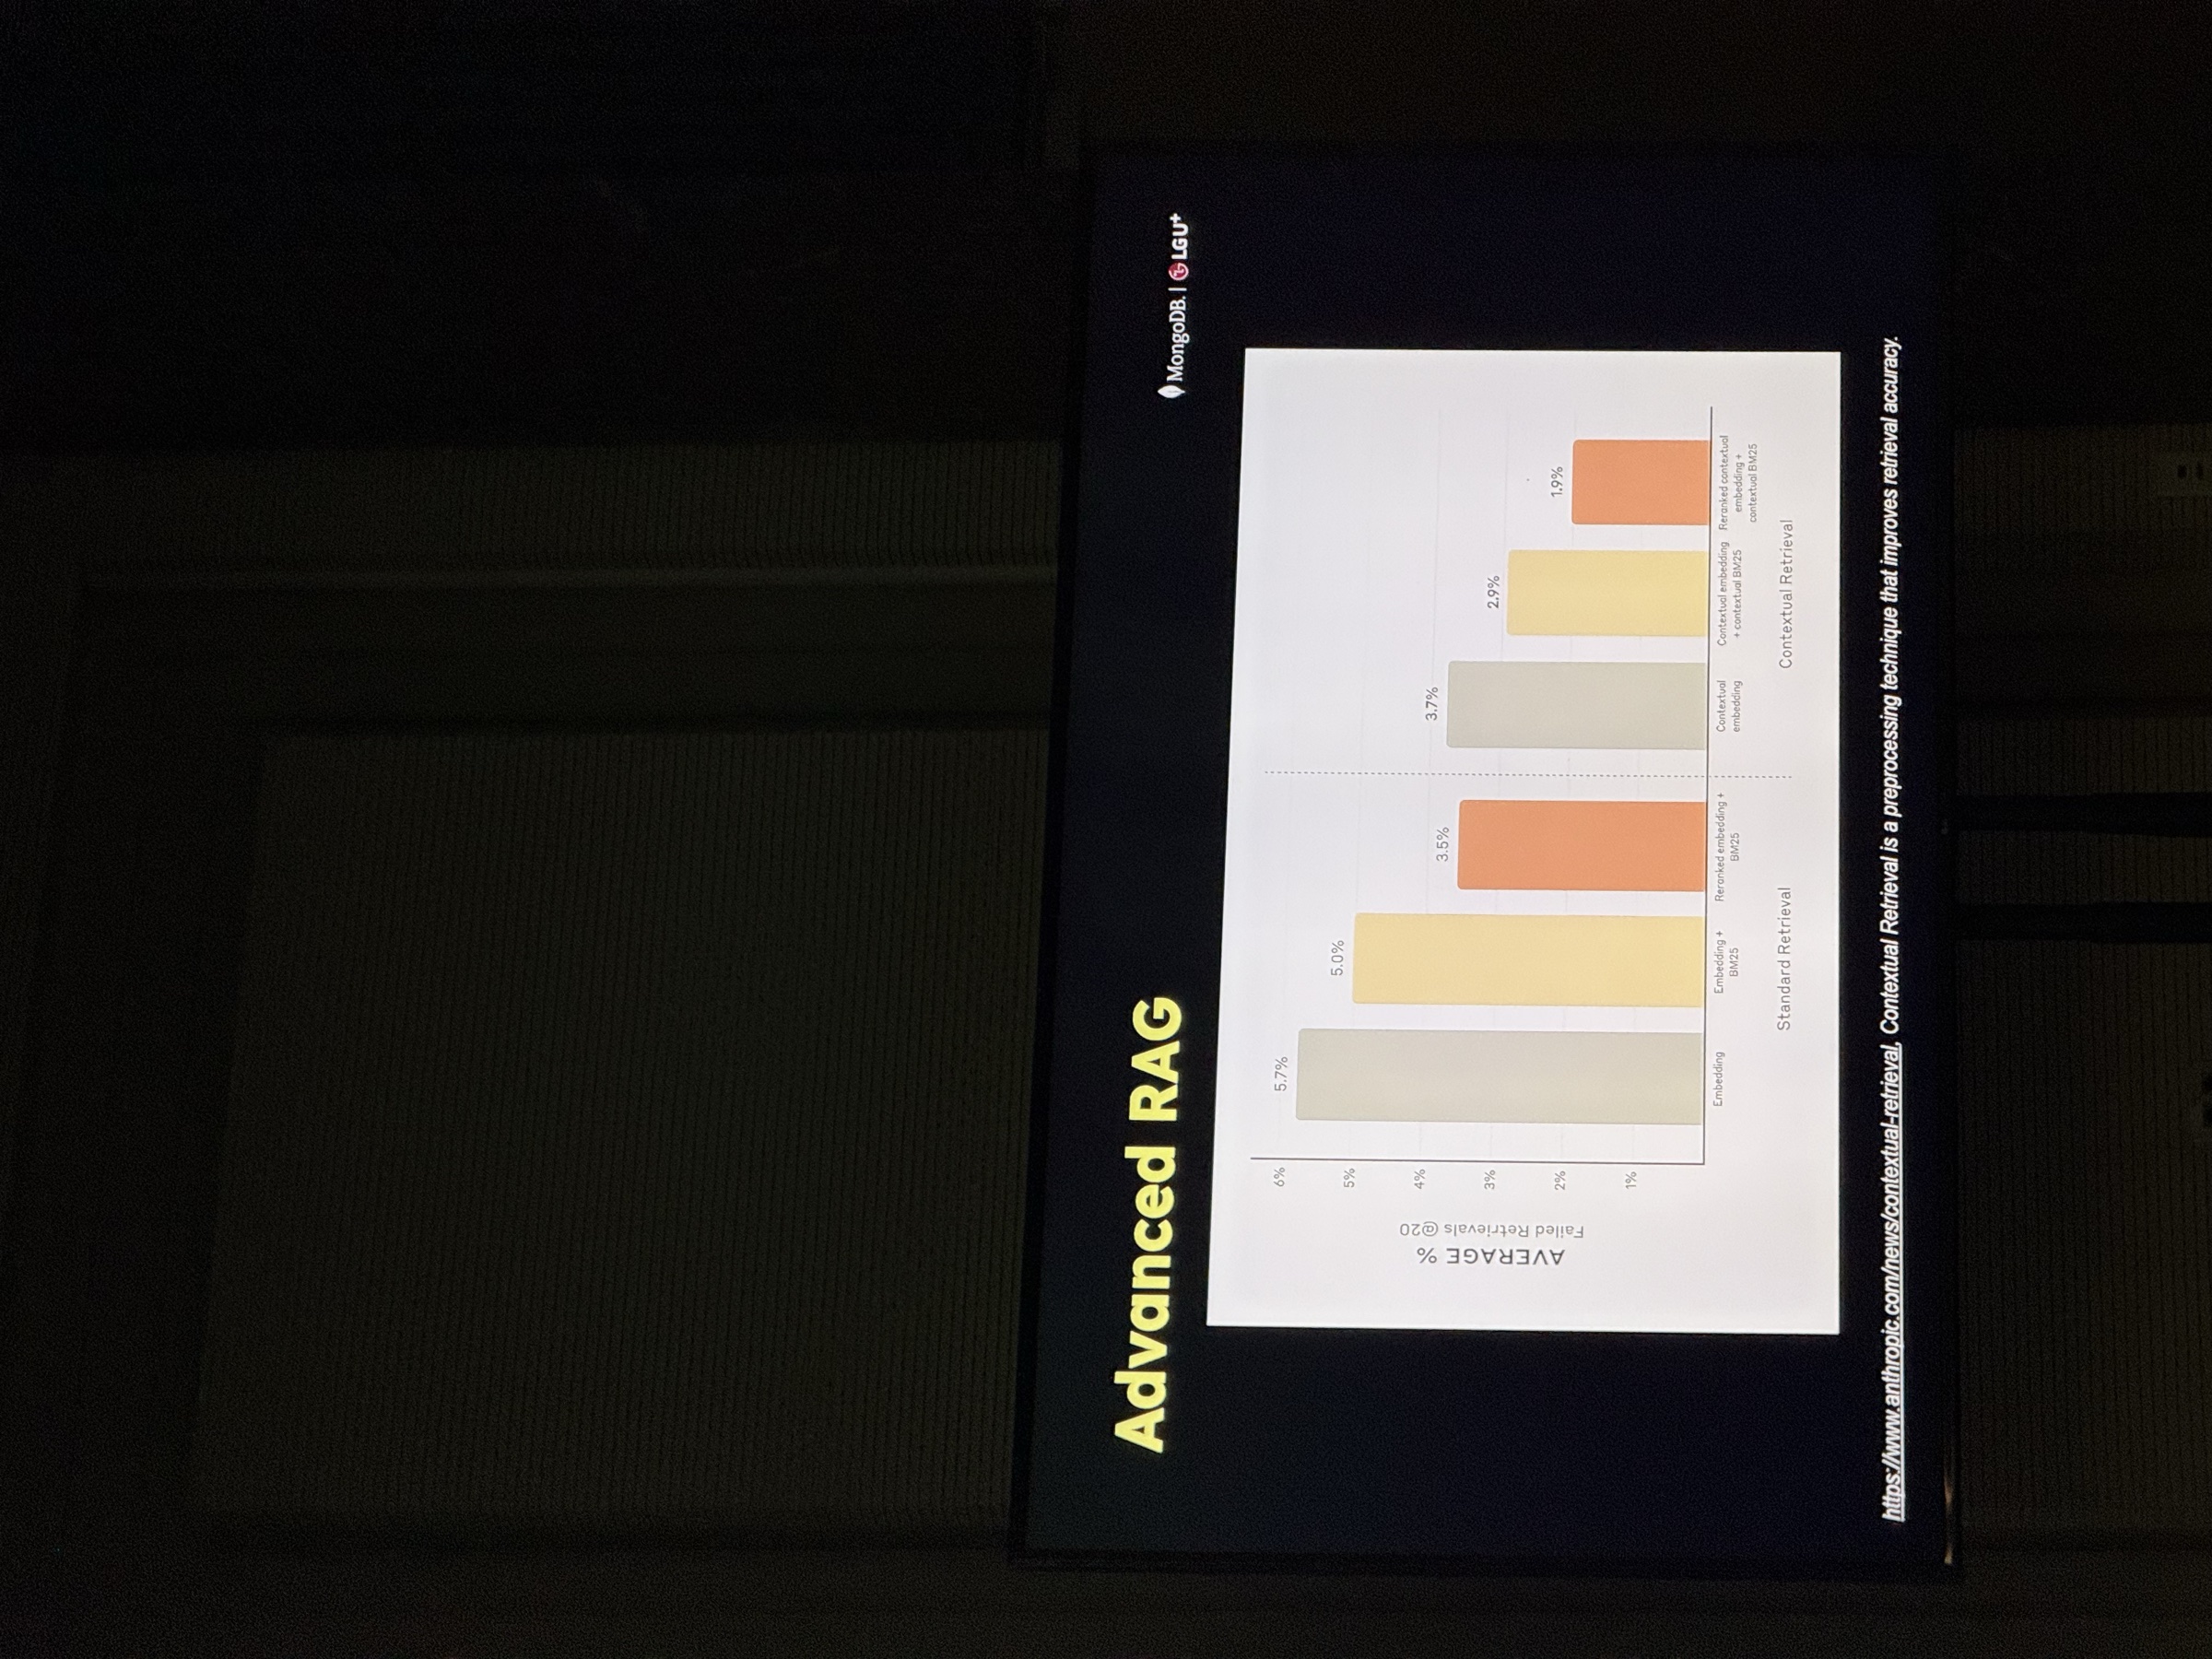
2단계: Advanced RAG (정보 정제 후 답변)
Naive RAG의 문제점을 해결하기 위해 여러 단계를 추가하여 LLM에 전달할 정보를 정교하게 다듬는다.
- 핵심 과정:
- 쿼리 확장: 질문을 동의어, 관련 용어 등으로 여러 버전으로 만든다.
- 하이브리드 검색: 키워드와 의미를 모두 사용해 정확하고 풍부한 정보를 찾는다.
- 리랭킹: 찾은 정보들 중 질문과 가장 관련성이 높은 순서로 다시 정렬한다.
- 정보 압축: 정제된 정보에서 핵심 내용만 요약하여 최종 컨텍스트를 만든다. 이 과정을 통해 훨씬 더 정확하고 신뢰도 높은 답변을 생성한다.
TypeScript
3단계: Agentic RAG (스스로 계획하고 실행하는 AI)
AI가 단순한 정보 검색을 넘어, 스스로 계획을 세우고 여러 도구를 자율적으로 사용하여 문제를 해결하는 단계다.
- 작동 방식:
- 의도 파악: 사용자의 질문의 진짜 의도를 파악한다.
- 계획 수립: 문제를 해결하기 위한 단계별 계획을 세운다. (예: 1. 데이터베이스 조회, 2. API 호출, 3. 결과 계산)
- 도구 사용: 계획에 따라 검색, 계산기, API 호출 등 필요한 도구를 실행한다.
- 결과 종합: 각 단계에서 얻은 결과를 종합하여 최종 답변을 생성한다.
- 기억: 대화 내용을 기억하여 다음 대화에 활용한다. 이는 마치 AI가 스스로 생각하고 행동하는 ’에이전트’처럼 작동하는 것이다.
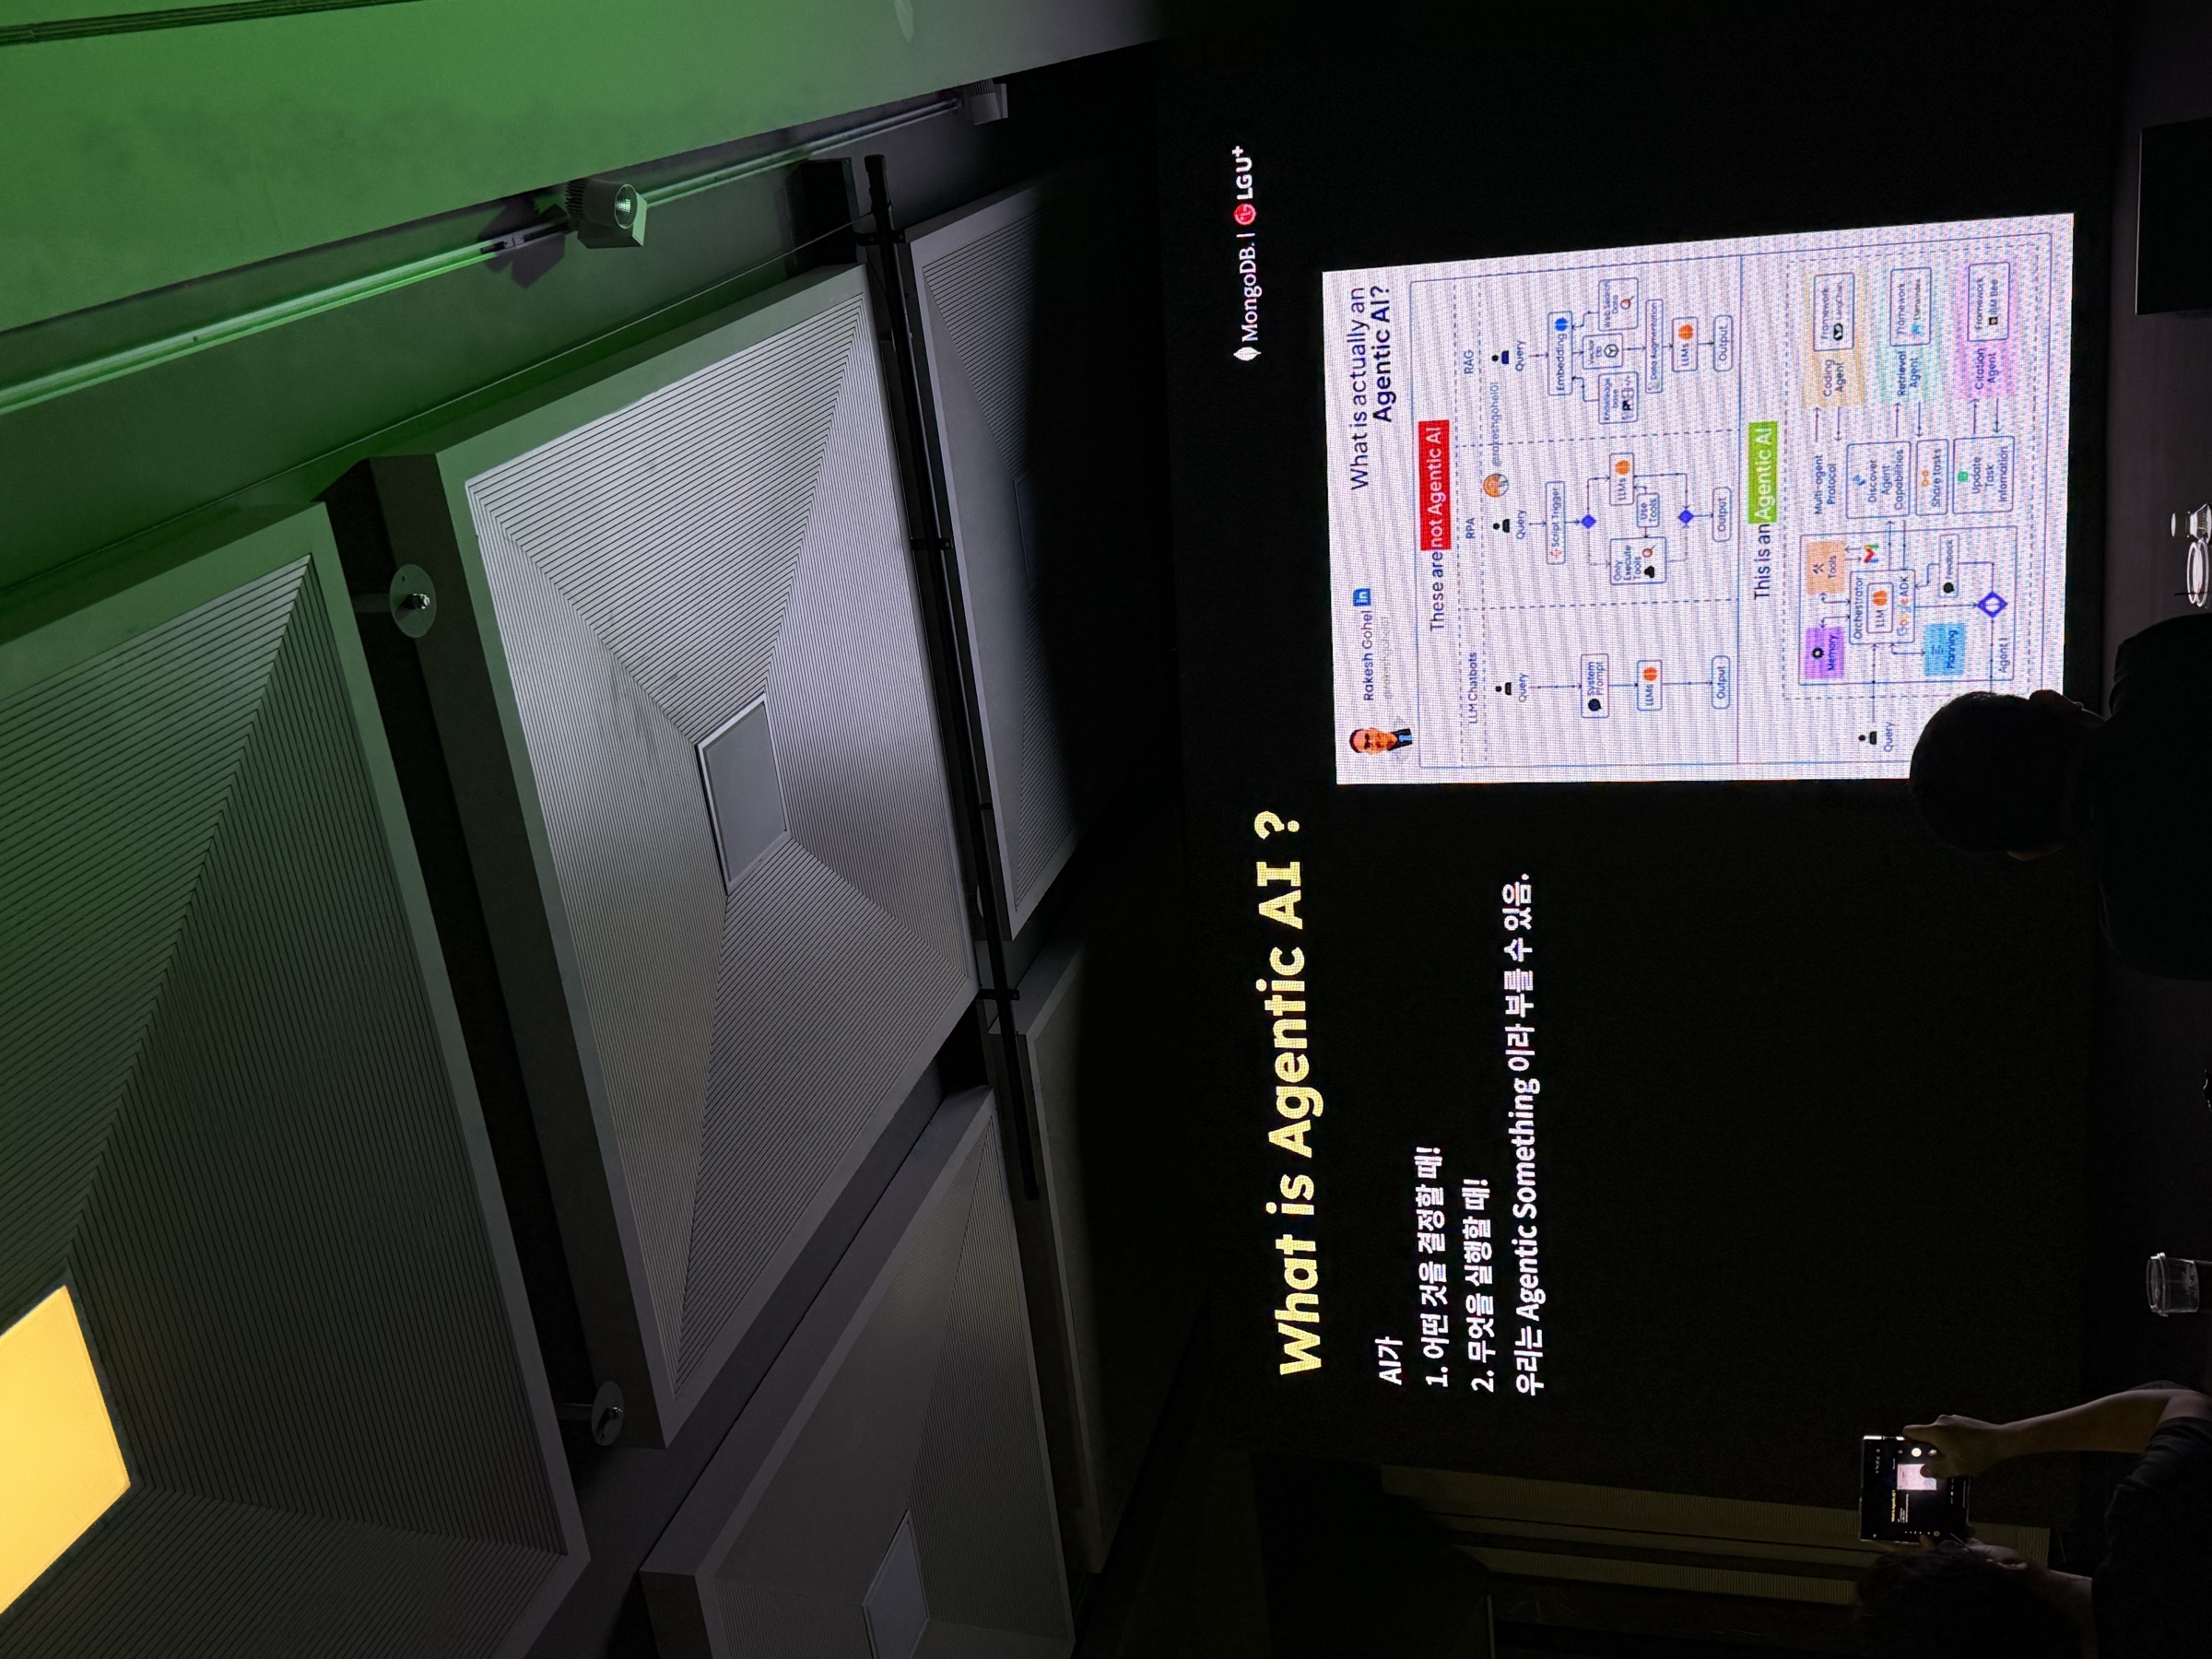
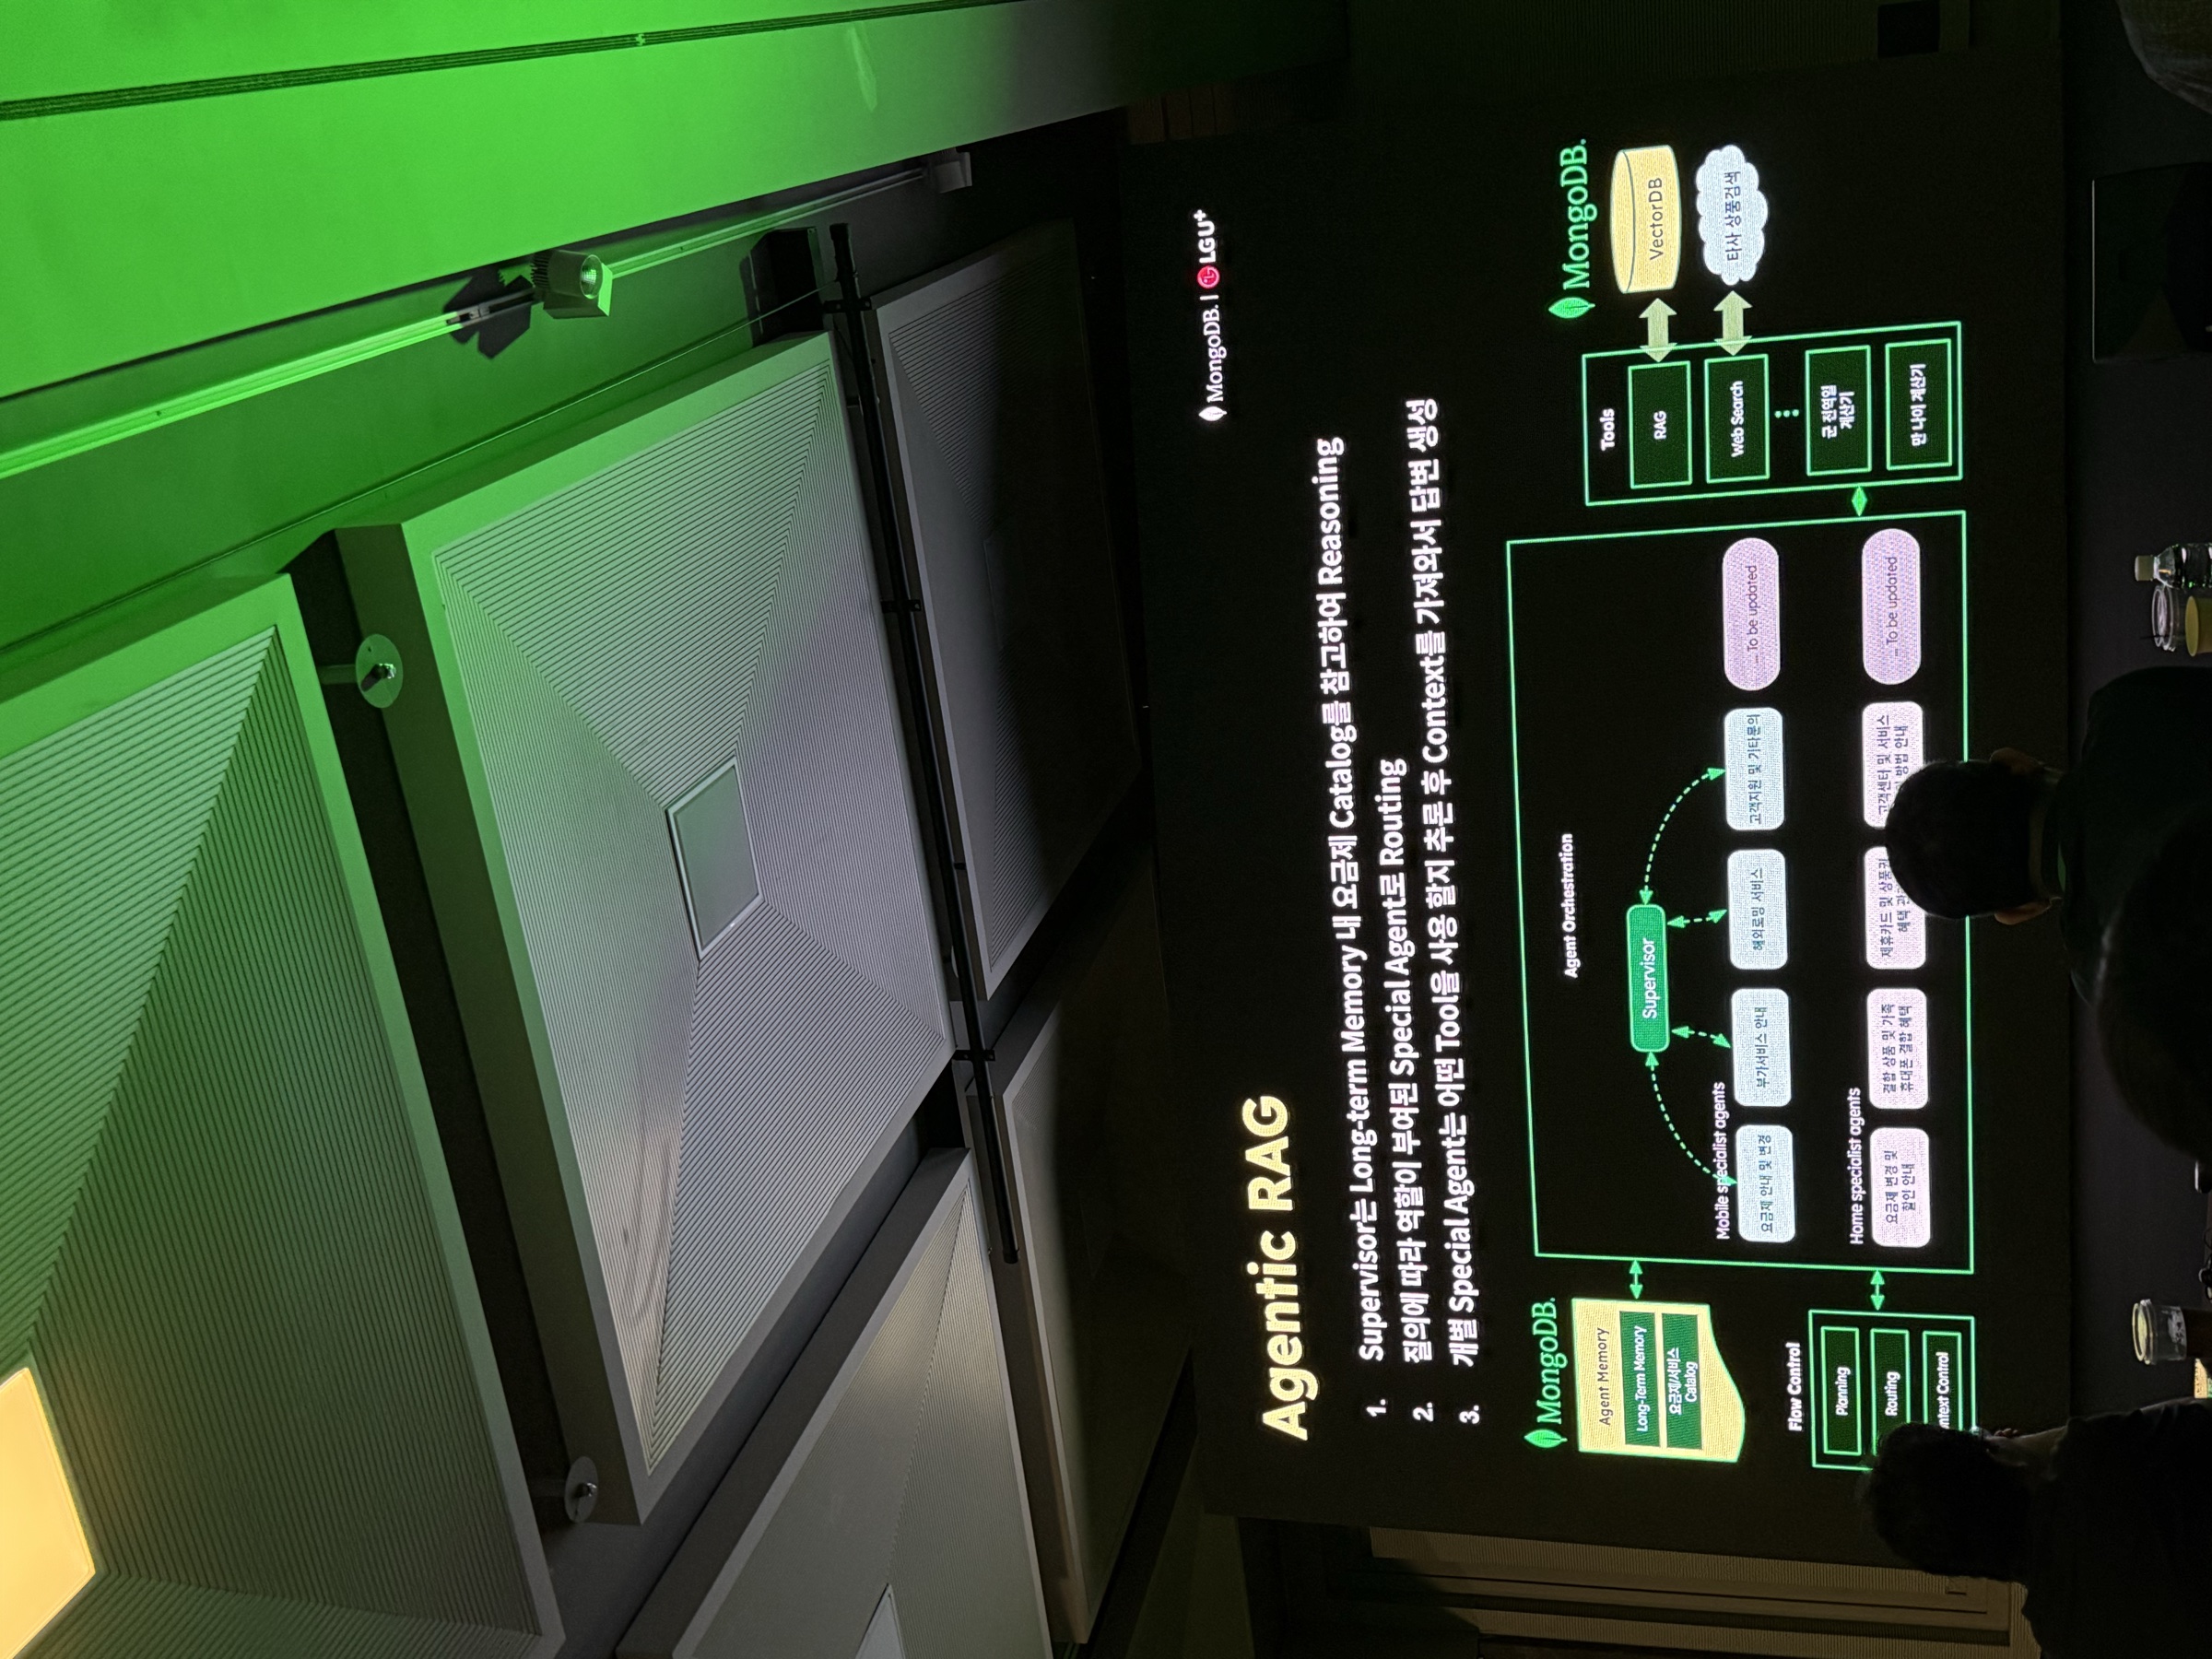
TypeScript
기업 사례: MongoDB Atlas를 통한 비즈니스 혁신
MongoDB 컨퍼런스에서는 Atlas를 활용하여 실제 비즈니스 문제를 해결한 여러 기업의 성공 사례가 공유되었다.
Novo Nordisk - 12주를 10분으로 단축한 비결
글로벌 제약사 Novo Nordisk는 MongoDB Atlas를 중심으로 통합 데이터 아키텍처를 구축하여 신약 연구 개발 프로세스를 획기적으로 단축했다.
발표에서 특히 강조된 점은, 처음에는 관계형 데이터베이스로 시도했다가 실패했다는 사실이다. 수십 개의 테이블을 조인(join)하는 과정에서 성능 저하가 심각했고, 고정된 스키마 구조 때문에 새로운 데이터를 추가하거나 변경하는 것이 어려워 빠른 실험이 불가능했다.
반면, MongoDB의 유연한 문서 모델은 복잡한 연구 데이터를 있는 그대로 저장하고 빠르게 수정할 수 있게 해주었다. 이를 통해 RAG(검색 증강 생성) 시스템을 성공적으로 구현하여, 이전에 12주가 걸리던 분석 작업을 단 10분 만에 완료하는 성과를 거두었다.
Meltwater - 하루 10억 건의 스트리밍 데이터 처리
미디어 인텔리전스 기업 Meltwater는 전 세계 뉴스, 소셜 미디어 등에서 발생하는 하루 10억 건 이상의 데이터를 실시간으로 수집하고 분석한다.
이 사례의 핵심은 Spark나 Flink 같은 별도의 스트림 처리 프레임워크 없이, MongoDB Atlas Stream Processing 기능만으로 이 모든 대용량 데이터를 처리했다는 점이다. 이는 데이터 파이프라인을 단순화하여 인프라 복잡성과 운영 비용을 크게 절감하는 효과를 가져온다. 데이터를 한곳에 모아 저장, 처리, 분석까지 모두 해결한 것이다.
LG U+ AICC - AI 컨택센터의 혁신
LG U+는 AI 컨택센터(AICC)의 상담원 지원 시스템(Agent Assist System)에 MongoDB Atlas를 도입하여 큰 성공을 거두었다. 이 시스템은 고객과의 통화 내용을 실시간으로 분석하여 상담원에게 최적의 답변 가이드라인을 제공한다.
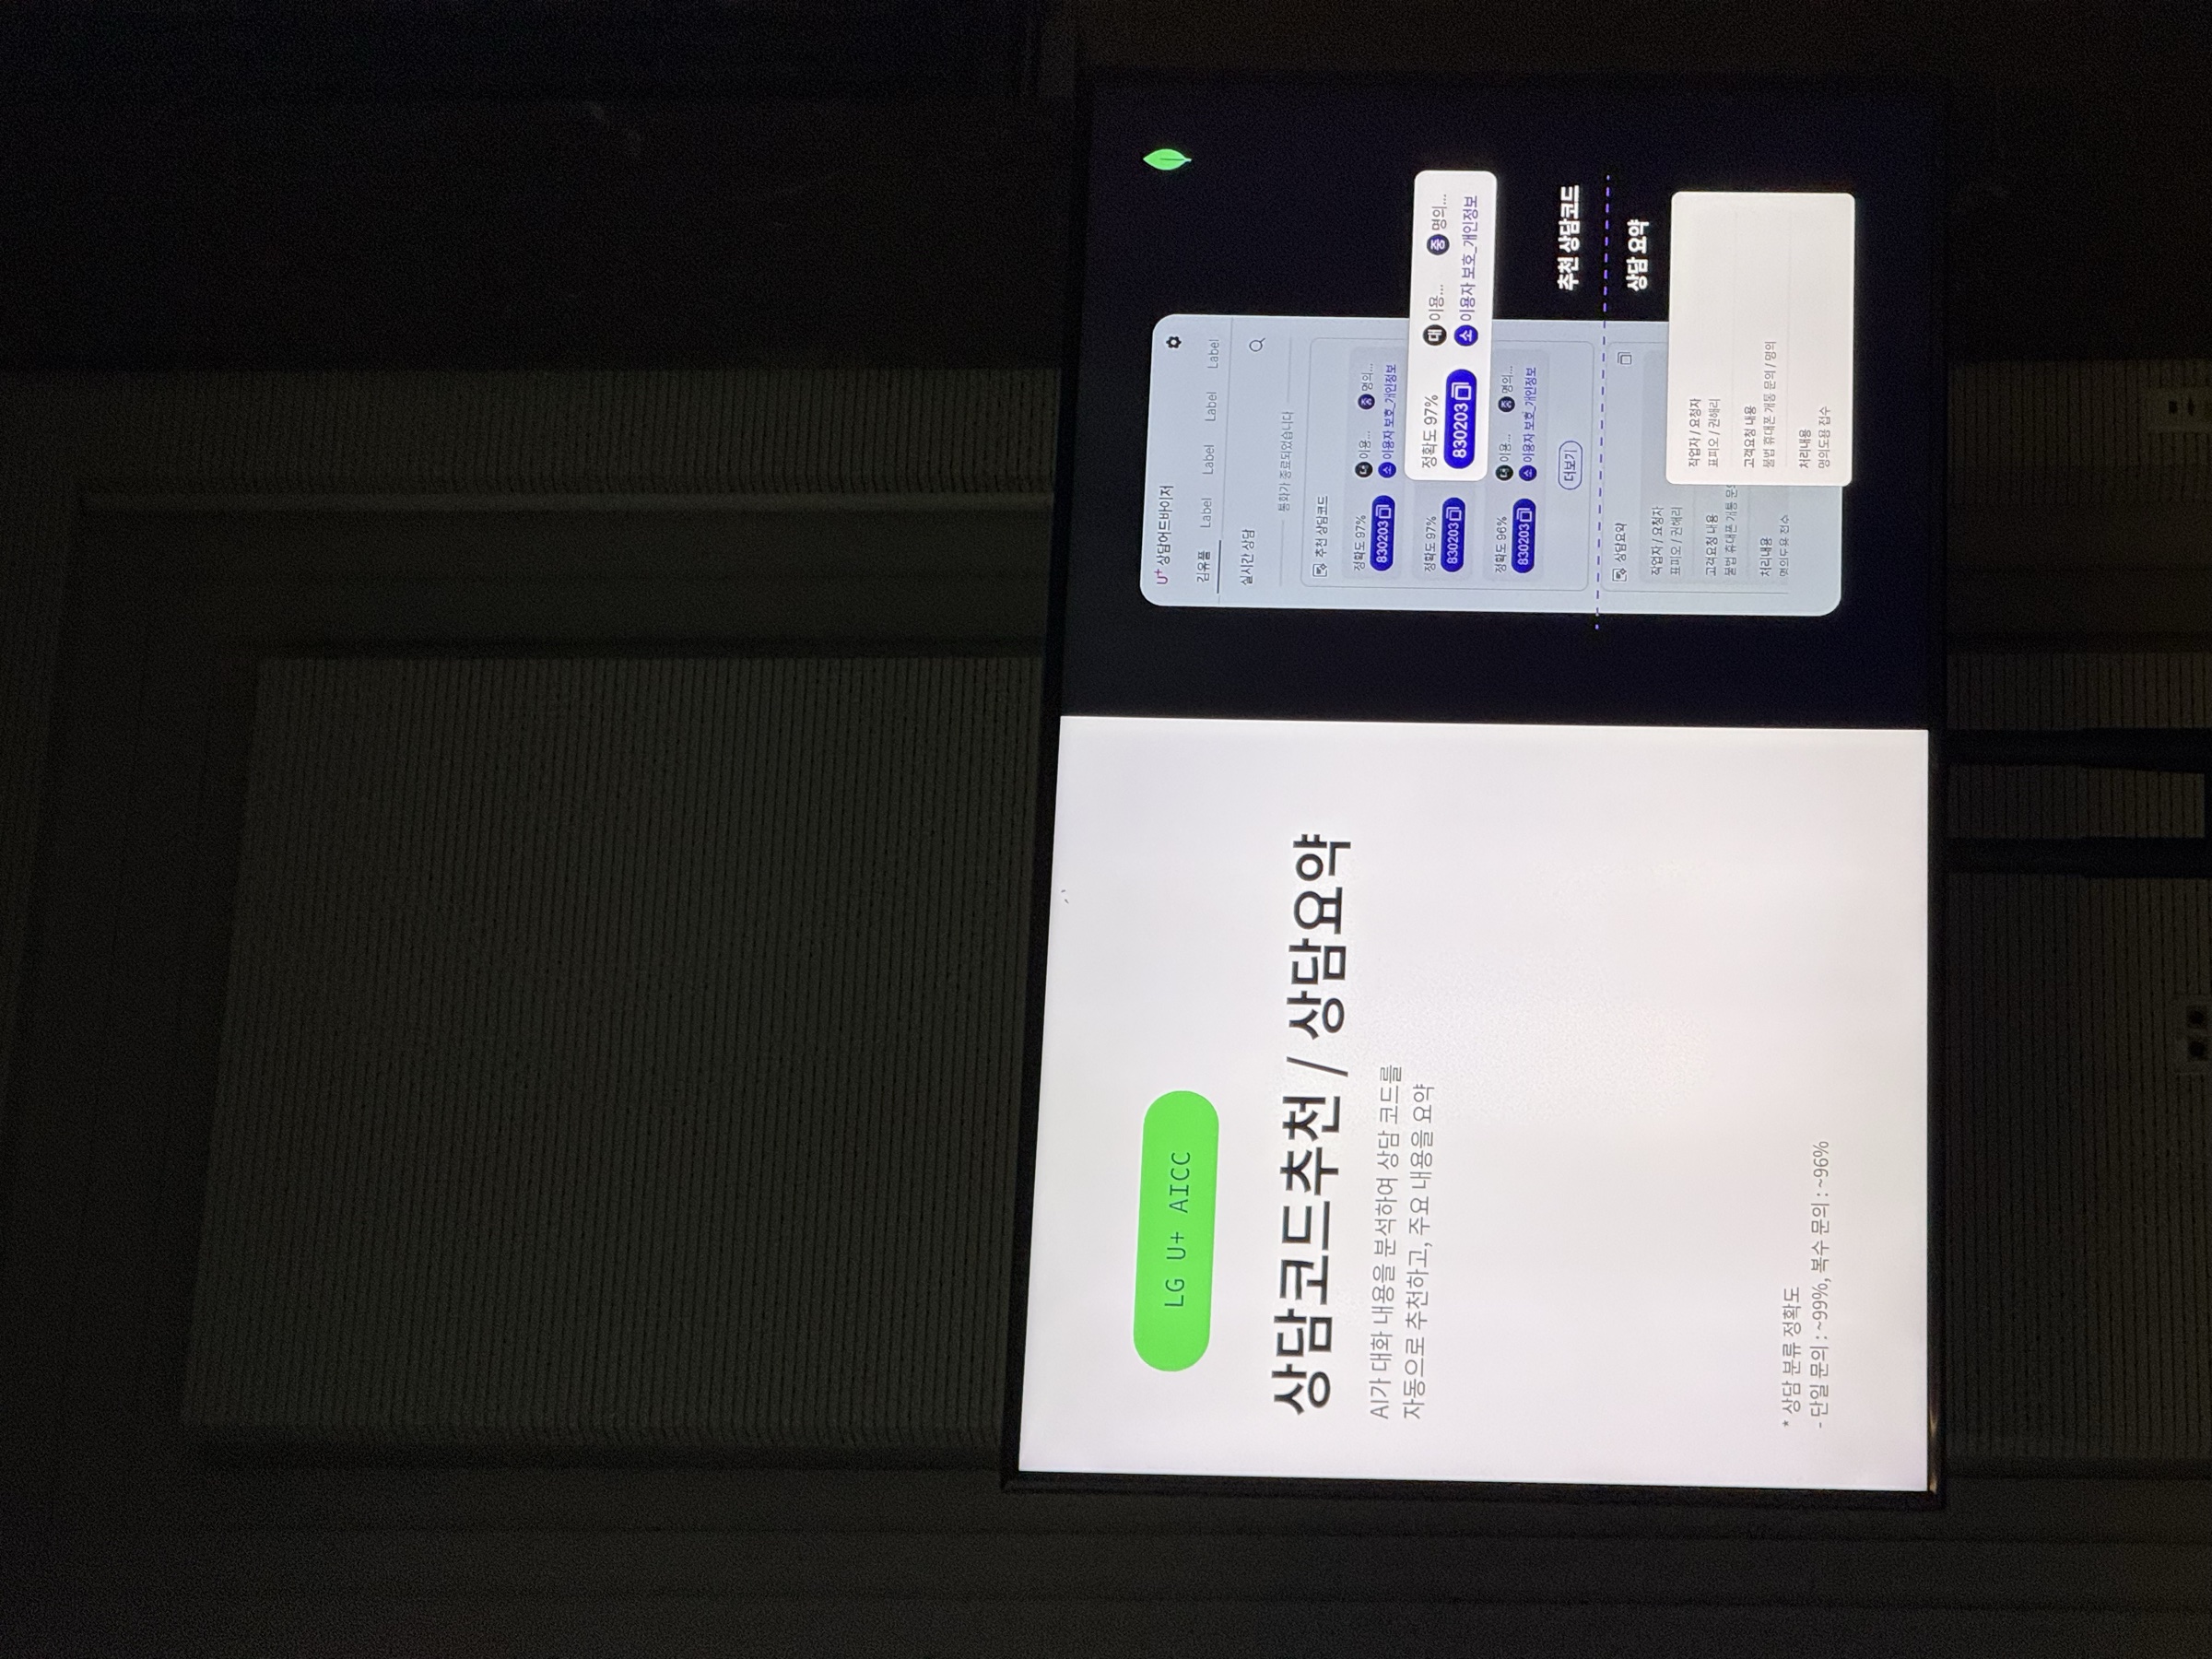
시스템의 작동 방식은 다음과 같다.
- 실시간 의도 파악: AI가 고객의 질문 의도를 즉시 파악한다.
- 고객 이력 조회: MongoDB에 저장된 고객의 과거 상담 내역, 사용 서비스 등 복잡한 데이터를 유연한 스키마를 활용해 신속하게 조회한다.
- 관련 정보 검색: Atlas Vector Search를 사용해 고객의 질문과 가장 관련성이 높은 매뉴얼과 FAQ 문서를 찾아낸다.
- 답변 가이드 생성: 고객 정보와 매뉴얼을 종합하여 상담원에게 추천 답변, 관련 정책, 다음 행동 제안 등을 실시간으로 제공한다.
TypeScript
이 시스템 도입 결과, 상담 콜당 평균 처리 시간이 7% 감소하고 자원 효율성은 30% 향상되었으며, 상담원 만족도 역시 크게 개선되었다고 한다.
MCP(Model Context Protocol) - AI와 DB의 직접 소통
MongoDB MCP Server의 혁명
Anthropic이 만든 MCP를 MongoDB가 지원한다는 발표가 있었다. 이게 왜 대단한가?
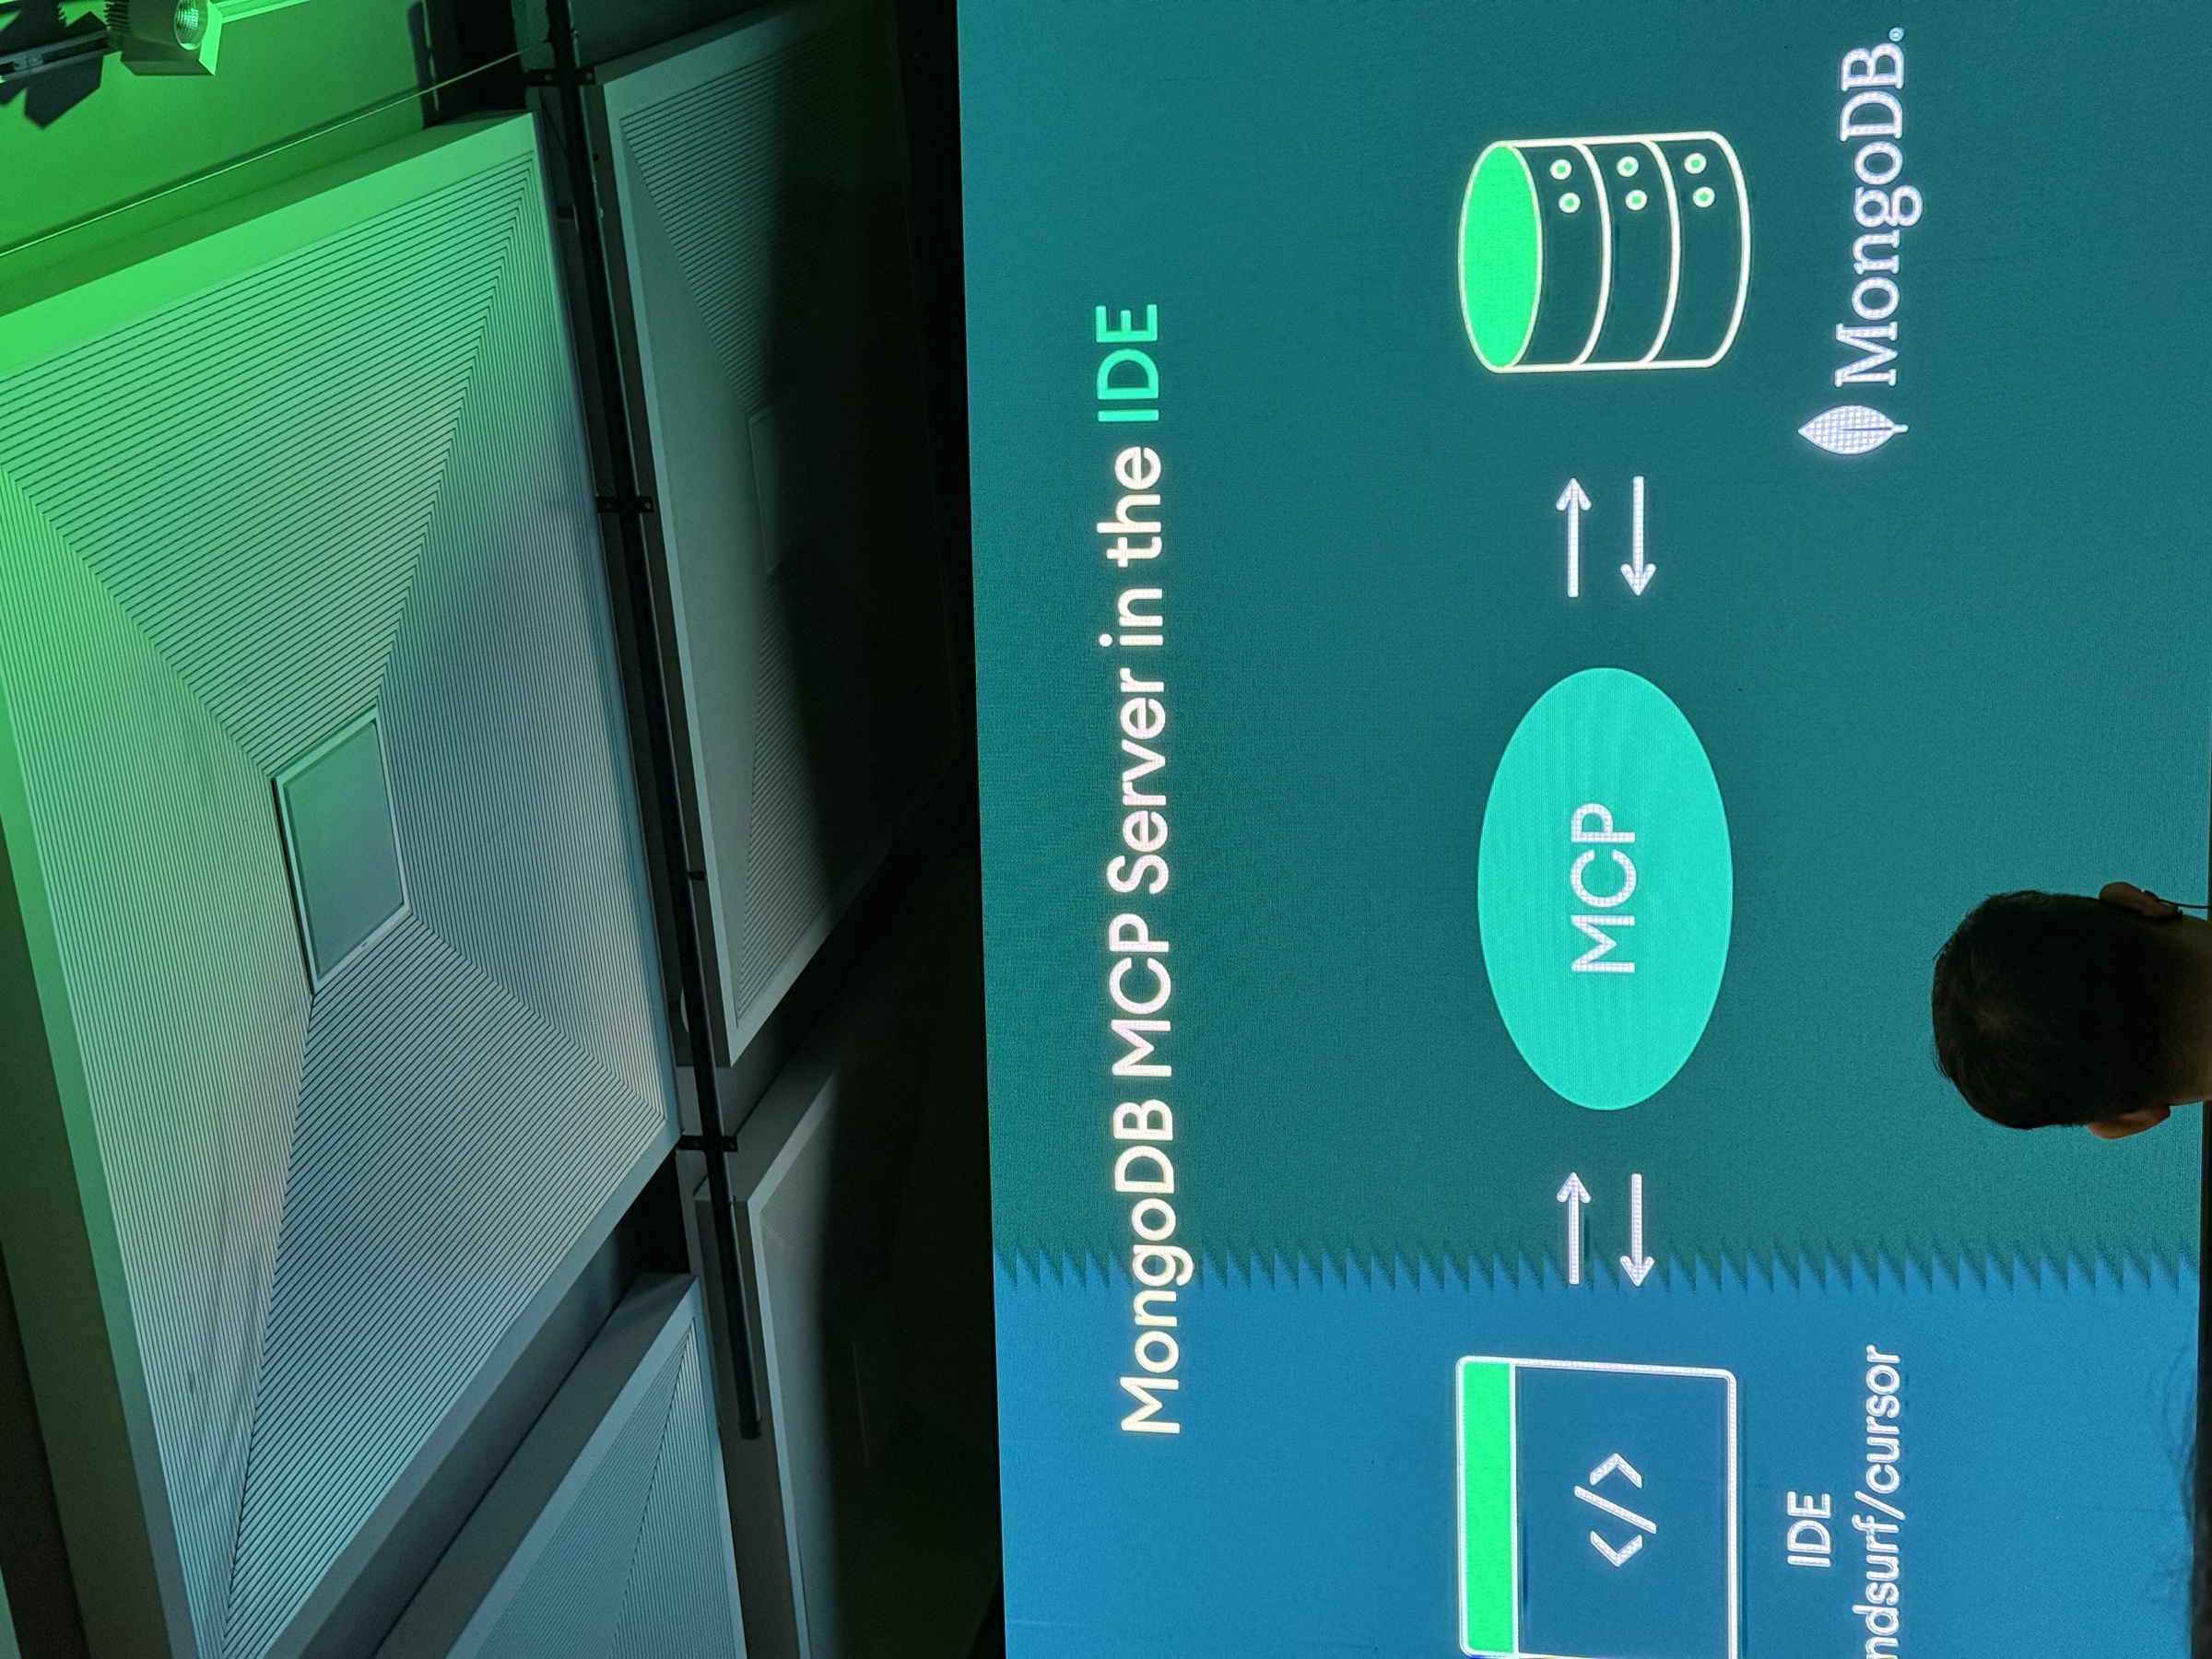
실제 데모가 인상적이었다. VS Code에서 Cursor AI를 통해,
TypeScript
AI가 컨텍스트를 이해하고, 스키마를 파악하고, 최적의 쿼리를 생성한다.
Test-Driven에서 Evaluation-Driven(EDD)으로
AI 시대의 개발 패러다임 변화
발표에서 가장 충격적이었던 부분이 “이제는 Test-Driven이 아니라 Evaluation-Driven이다”라는 메시지였다.
TypeScript
MongoDB의 미래 비전
AI-Native 데이터 플랫폼으로의 진화
컨퍼런스를 통해 본 MongoDB의 미래 방향성
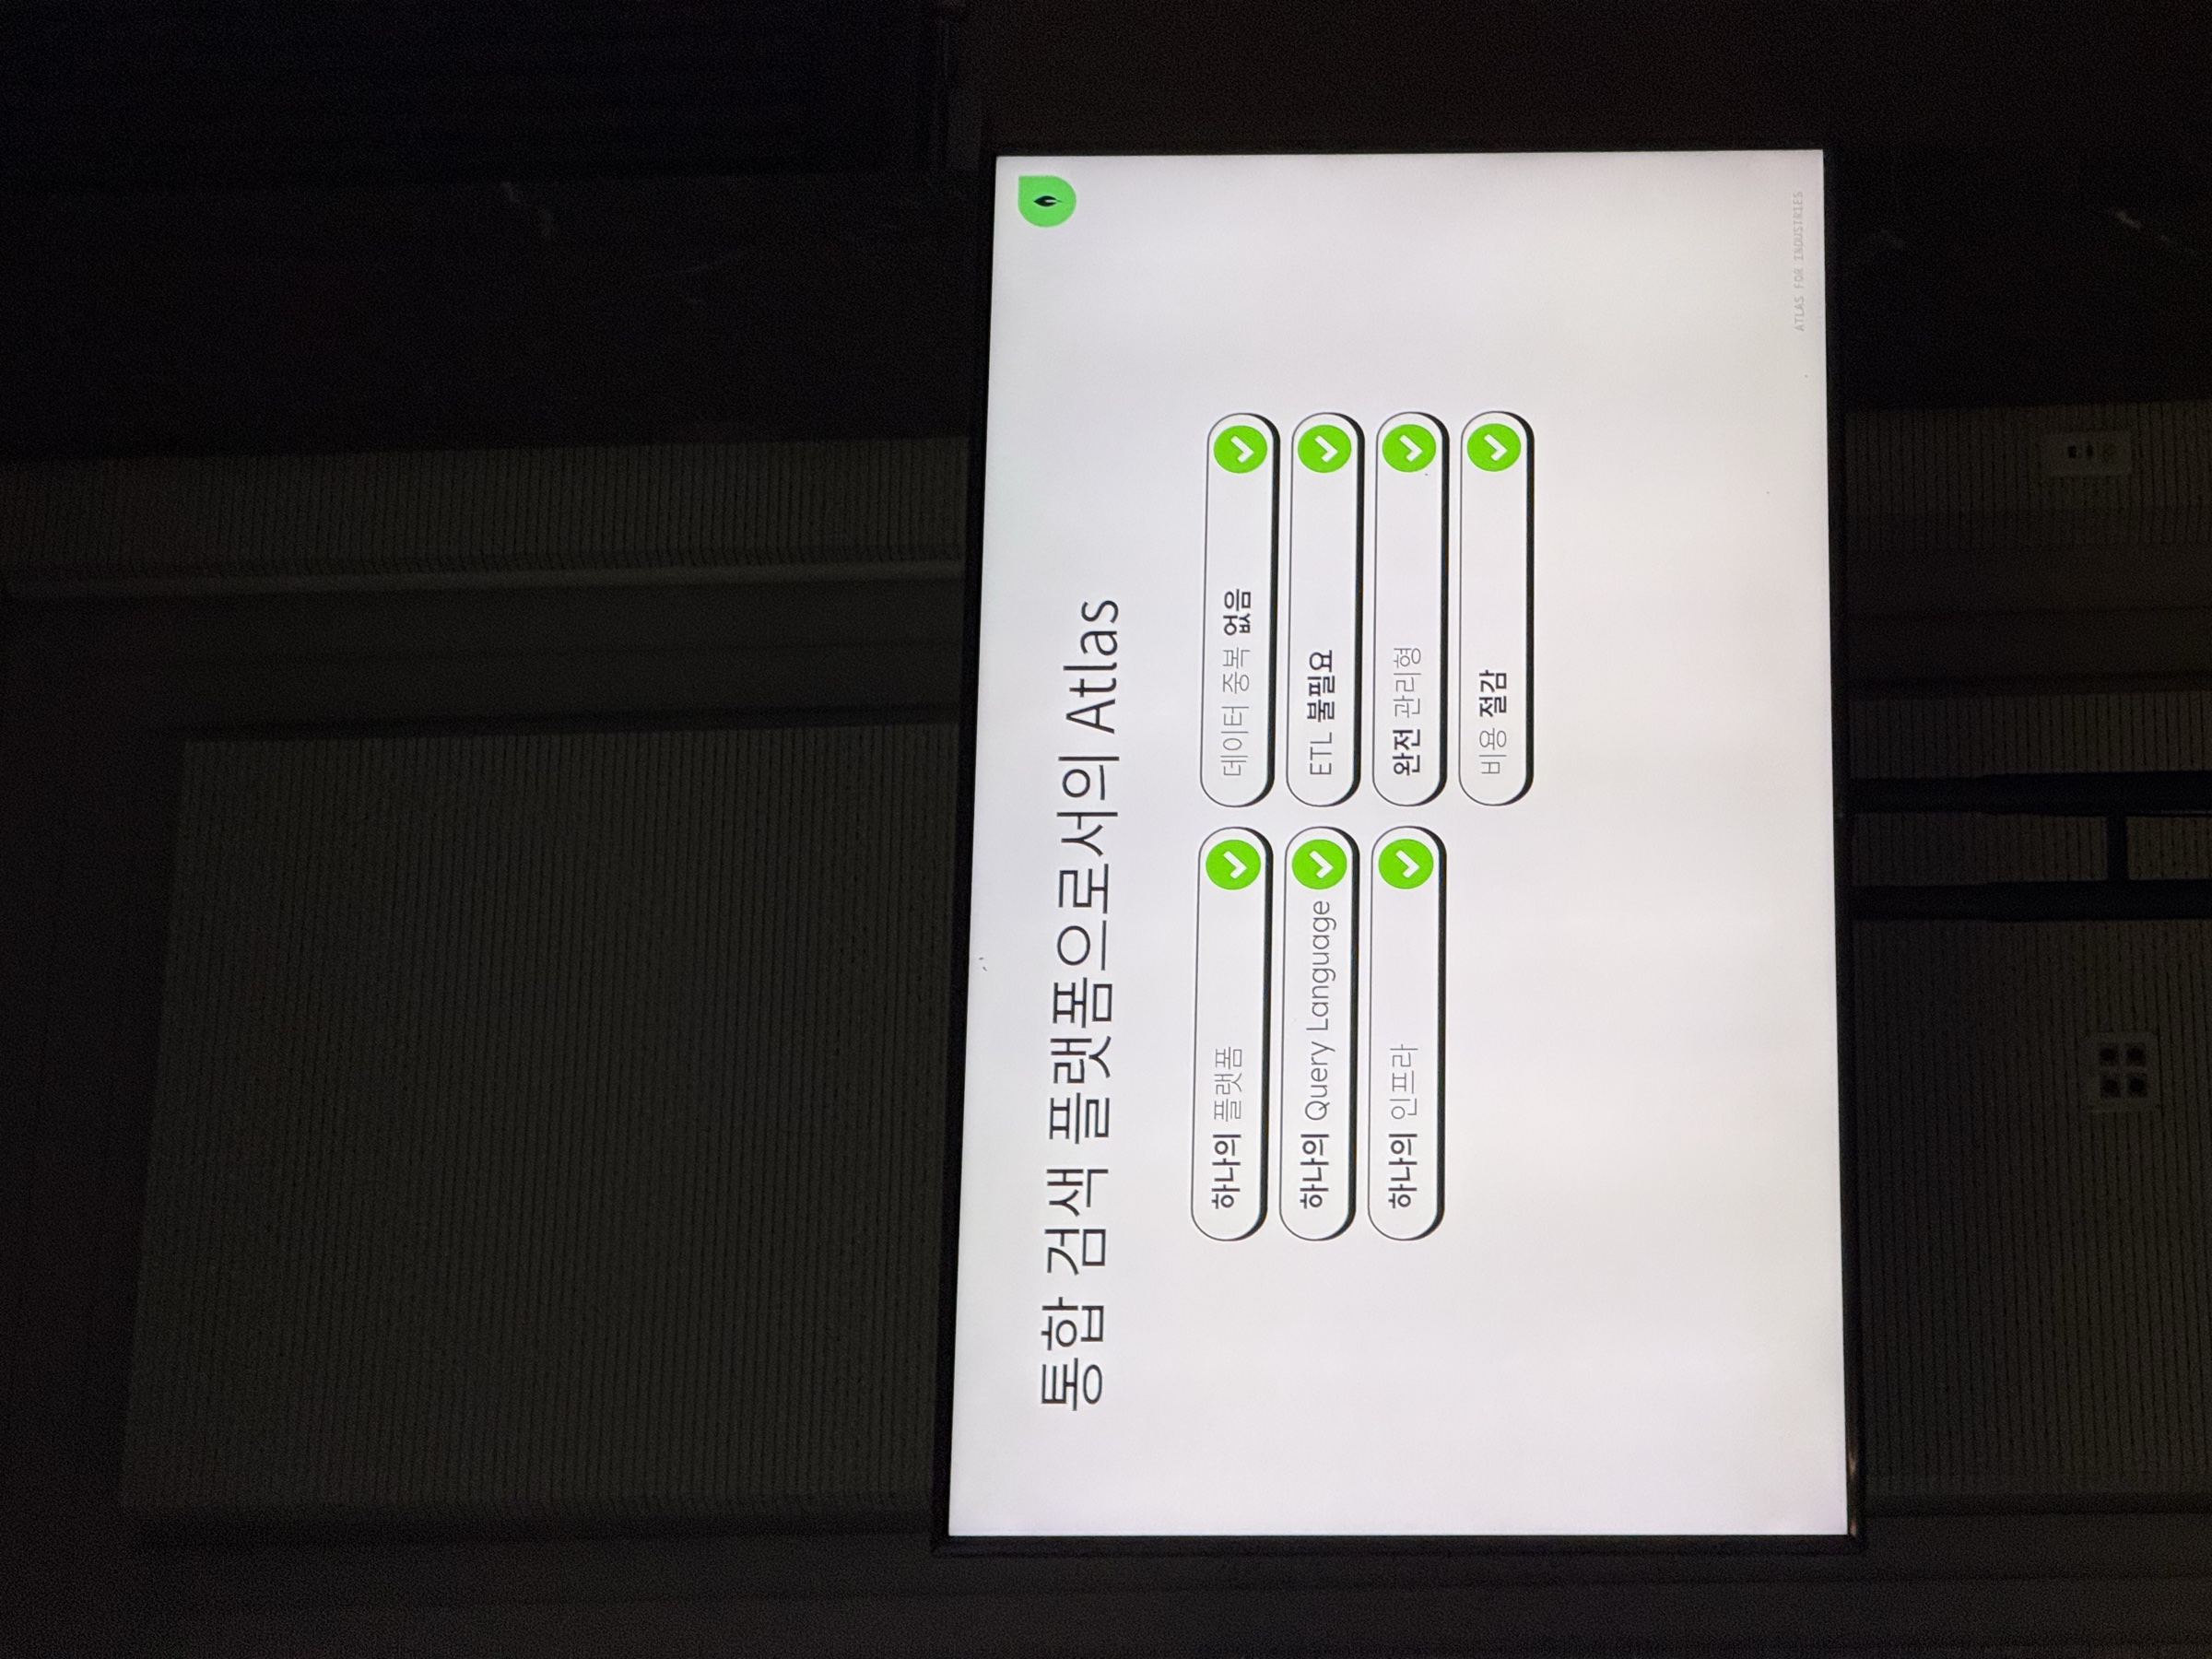
- 통합 플랫폼 전략: 별도의 검색 엔진, 벡터 DB, 스트림 처리 엔진 없이 MongoDB Atlas 하나로
- 개발자 중심 혁신: MCP, IDE 통합 등 개발자 경험 극대화
- AI First: 모든 기능이 AI 워크로드를 염두에 두고 설계
우리가 주목해야 할 트렌드
TypeScript
레거시 시스템 현대화 - 리프트 앤 시프트는 현대화가 아니다
진짜 문제는 데이터 모델
컨퍼런스에서 제시된 핵심 메시지는 “진정한 현대화는 데이터베이스의 종류를 바꾸는 것이 아니라, 데이터의 구조 자체를 재설계하는 것”이라는 점이다.
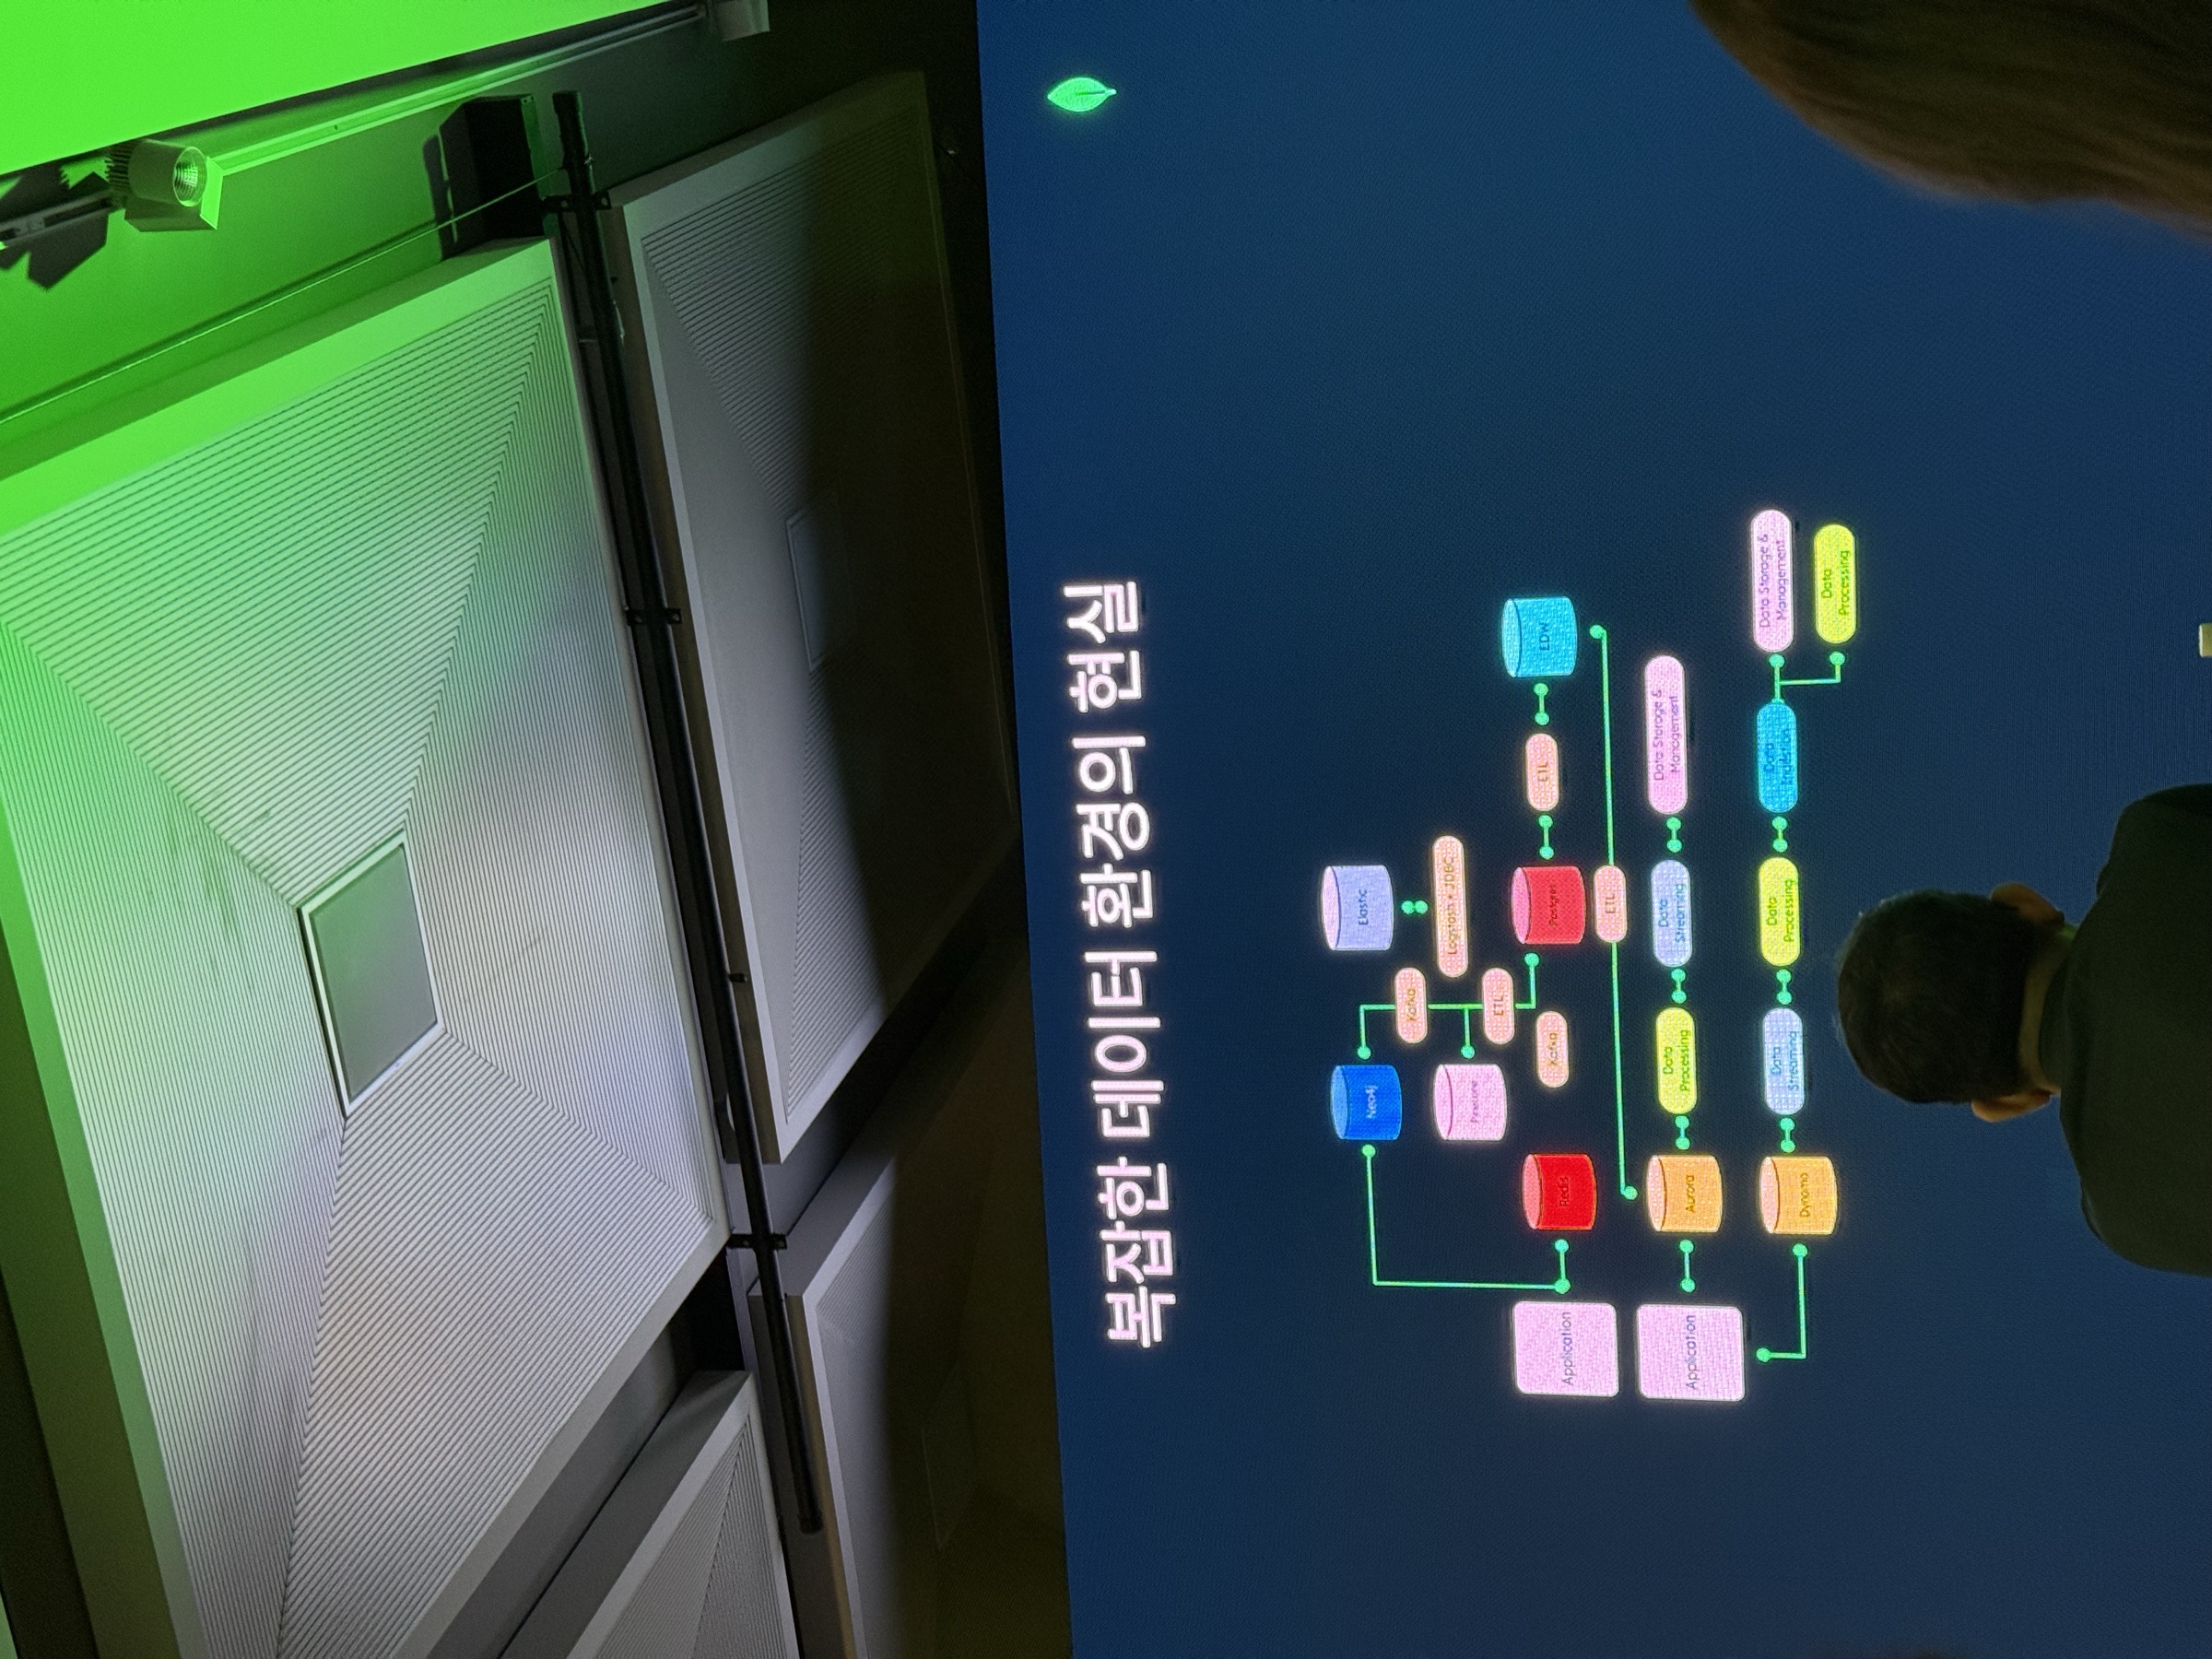
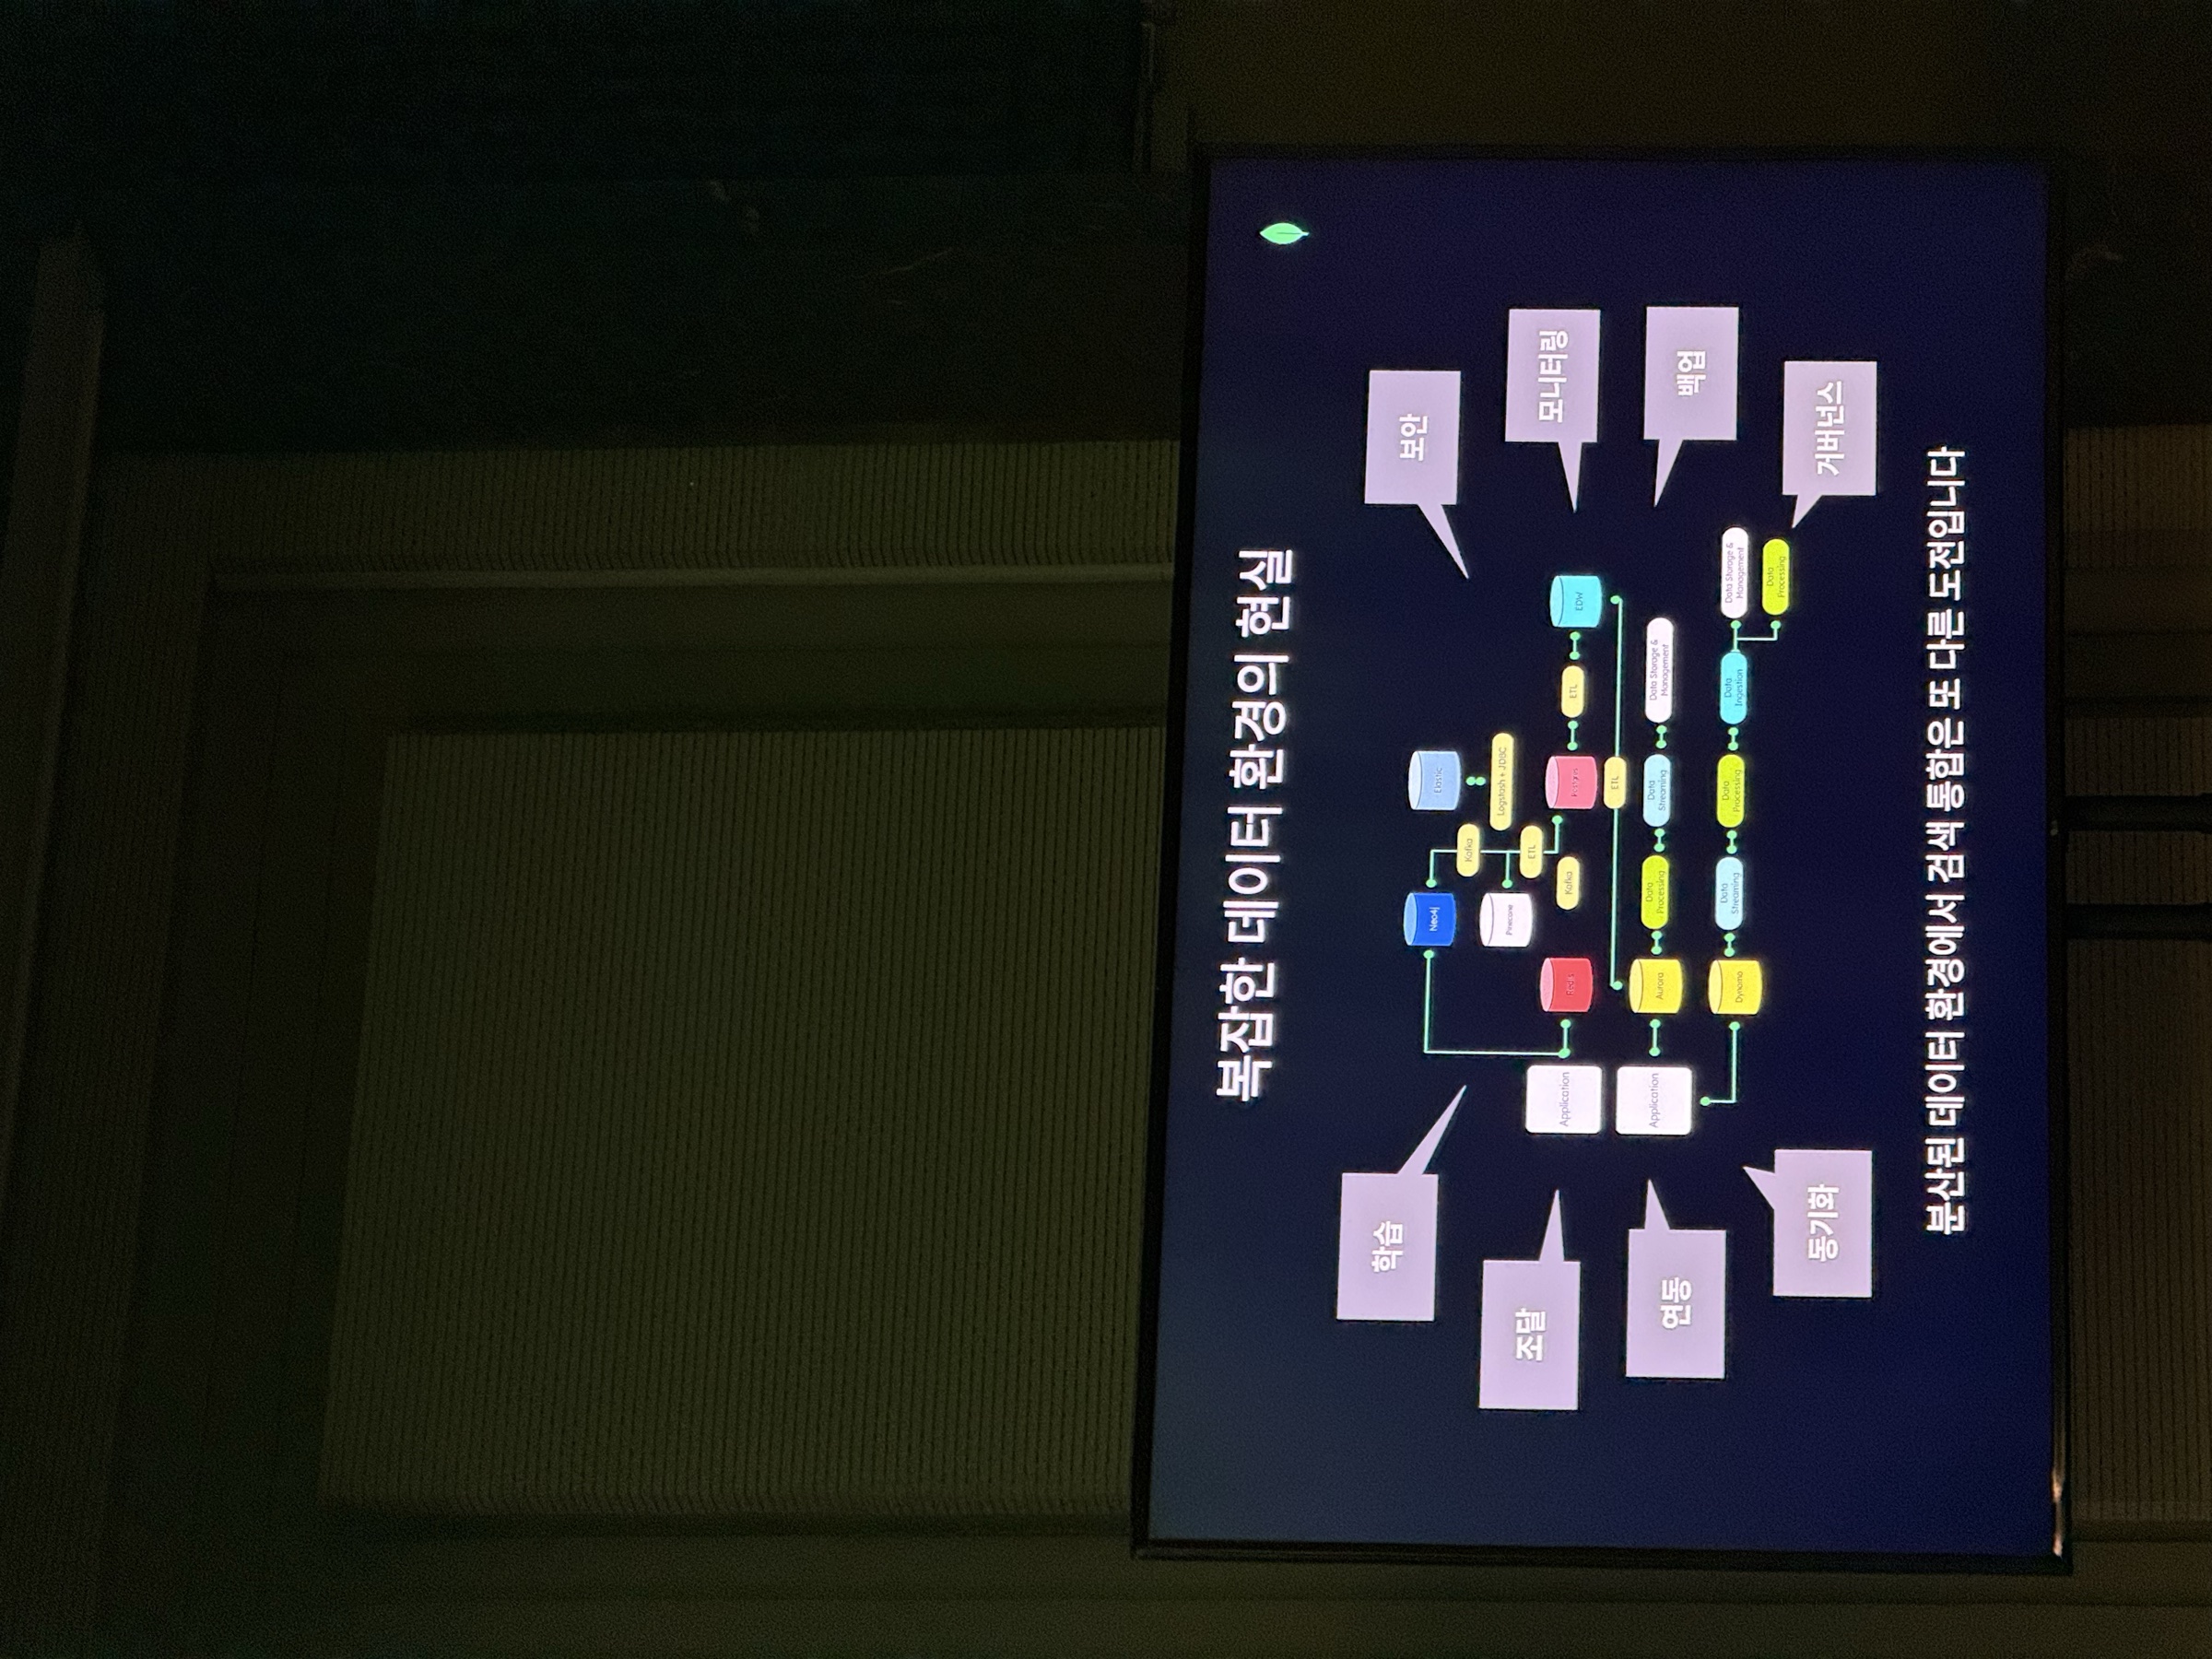
“오라클에서 PostgreSQL로 옮기는 건 현대화가 아니다. 그건 그냥 비용 절감일 뿐이다. 진정한 현대화는 데이터 모델을 완전히 재설계하는 것이다.”
- 리프트 앤 시프트(Lift and Shift)란, 기존 애플리케이션과 데이터를 거의 그대로 새로운 환경으로 ‘들어 올려 옮기는’ 방식을 말한다. 예를 들어, 자체 서버에서 운영하던 Oracle 데이터베이스를 클라우드의 PostgreSQL로 옮기는 것이다. 이는 마치 낡은 가구를 그대로 새집으로 옮기는 것과 같다. 집은 새로워졌지만, 가구의 불편함은 그대로 남아있는 것이다. 발표자는 이를 비용 절감일 뿐, 근본적인 문제 해결책이 아니라고 지적한다. 진정한 현대화는 현재 비즈니스 요구사항에 맞게 데이터 모델을 처음부터 다시 설계하는 것을 의미한다. 이는 새집의 구조에 맞춰 효율적인 새 가구를 짜는 것과 같다.
진짜 문제는 데이터 모델: 20번의 조인 vs 1번의 조회
10년 이상 된 레거시 시스템의 가장 큰 문제는 관계형 데이터베이스의 정규화(Normalization) 구조에 있다.
과거의 방식: 관계형 데이터베이스 (수많은 테이블)
과거에는 저장 공간이 비쌌기 때문에, 데이터의 중복을 최소화하는 것이 매우 중요했다. 이를 위해 ’주문’이라는 하나의 개념을 주문 기본 정보, 주문 상품, 상태 변경 이력, 결제 정보 등 20개 이상의 잘게 쪼개진 테이블에 나누어 저장했다.
- 문제점: 하나의 완전한 주문 정보를 보기 위해서는, 이 20개가 넘는 테이블을 모두 연결하는 JOIN 연산을 수행해야 한다. 이는 마치 하나의 보고서를 완성하기 위해 20개의 다른 서류 캐비닛을 일일이 열어 필요한 서류를 찾아 스테이플러로 찍는 것과 같다. 이 과정은 매우 복잡하고 느리며, 시스템에 큰 부하를 준다.
현대의 방식: MongoDB 문서 모델
MongoDB와 같은 문서 데이터베이스는 하나의 주문과 관련된 모든 정보를 하나의 ‘문서(Document)’ 안에 저장하는 임베딩(Embedding) 패턴을 사용한다.
- 장점: 주문과 관련된 모든 정보가 하나의 파일 폴더 안에 정리되어 있는 것과 같다. 주문 상품, 결제 내역, 배송 정보가 모두 한곳에 있으므로, 시스템은 단 한 번의 조회로 필요한 모든 정보를 가져올 수 있다. JOIN이 필요 없으므로 조회 속도가 극적으로 빨라지고, 개발자는 데이터를 훨씬 직관적으로 다룰 수 있다.
현대화의 4단계 접근법
발표자는 레거시 시스템을 성공적으로 현대화하기 위한 4단계 접근법을 제시했다.
1단계: 분석 (Analysis)
“우리 시스템의 사용 설명서를 역으로 만들기”
이 단계의 목표는 현재 시스템이 ’어떻게 사용되고 있는지’를 완벽하게 파악하는 것이다. 데이터베이스 스키마만 보는 것이 아니라, 실제 애플리케이션이 데이터를 어떻게 읽고 쓰는지를 분석한다.
- 주요 활동:
- 어떤 테이블들이 항상 함께 조회되는가? (예:
orders와order_items는 거의 항상 같이 쓰인다.) - 시스템에서 가장 자주 실행되고 성능에 영향을 미치는 쿼리는 무엇인가?
- 어떤 데이터가 함께 생성되고 업데이트되는 경향이 있는가? 이 분석을 통해 어떤 데이터를 하나의 MongoDB 문서로 묶어야 할지에 대한 명확한 청사진을 그릴 수 있다.
- 어떤 테이블들이 항상 함께 조회되는가? (예:
2단계: 테스트 (Testing)
“새로운 설계도로 모형 집 지어보기”
분석 단계에서 설계한 새로운 데이터 모델이 실제로 잘 작동하는지 검증하는 단계다. 전체 시스템을 바꾸기 전에, 핵심 기능에 대해 개념 증명(POC, Proof of Concept)을 진행한다.
- 주요 활동:
- 새로운 MongoDB 데이터 모델을 기반으로 작은 규모의 테스트용 애플리케이션을 구축한다.
- 기존 시스템과 동일한 조건에서 성능을 비교하고 벤치마크한다.
- 새로운 모델이 모든 비즈니스 규칙과 기능을 문제없이 처리할 수 있는지 검증한다. 이 단계를 통해 새로운 설계의 문제점을 미리 발견하고 위험을 최소화할 수 있다.
3단계: 변환 (Transformation)
“오래된 데이터를 새로운 그릇에 옮겨 담기”
기존 관계형 데이터베이스의 여러 테이블에 흩어져 있는 데이터를 새로운 MongoDB 문서 구조에 맞게 변환하고 옮기는 단계다. 보통 ETL(Extract, Transform, Load) 파이프라인을 구축하여 이 작업을 수행한다.
- 주요 활동:
- Extract (추출): 기존의 20개 테이블에서 데이터를 추출한다.
- Transform (변환): 추출된 데이터를 조합하여 새로운 단일 문서 모델의 형태로 재가공한다. (예: 여러 테이블의 주문 관련 정보를 하나의 JSON 문서로 합친다.)
- Load (적재): 변환된 데이터를 MongoDB에 적재한다. 이 단계는 현대화 과정에서 기술적으로 가장 복잡하고 시간이 많이 소요될 수 있다.
4단계: 마이그레이션 (Migration)
“안전하게 이사하기”
실제 운영 환경의 트래픽을 기존 시스템에서 새로운 시스템으로 전환하는, 가장 중요하고 위험도가 높은 단계다. 서비스 중단 없이 안전하게 전환하기 위한 전략이 필수적이다.
- 주요 전략:
- 듀얼 라이트 (Dual Write): 전환 기간 동안 모든 새로운 데이터를 기존 시스템과 신규 시스템 양쪽 모두에 동시에 기록한다. 이를 통해 데이터 정합성을 유지하고, 문제가 발생했을 때 즉시 기존 시스템으로 돌아갈 수 있는 안전장치를 마련한다.
- 단계적 전환: 전체 사용자를 한 번에 전환하는 대신, 1%의 사용자부터 시작하여 점진적으로 트래픽을 늘려나간다.
- 롤백 계획 (Rollback Plan): 전환 과정에서 심각한 문제가 발생할 경우, 즉시 모든 트래픽을 다시 기존 시스템으로 되돌릴 수 있는 명확한 비상 계획을 수립한다.
MongoDB 스키마 설계
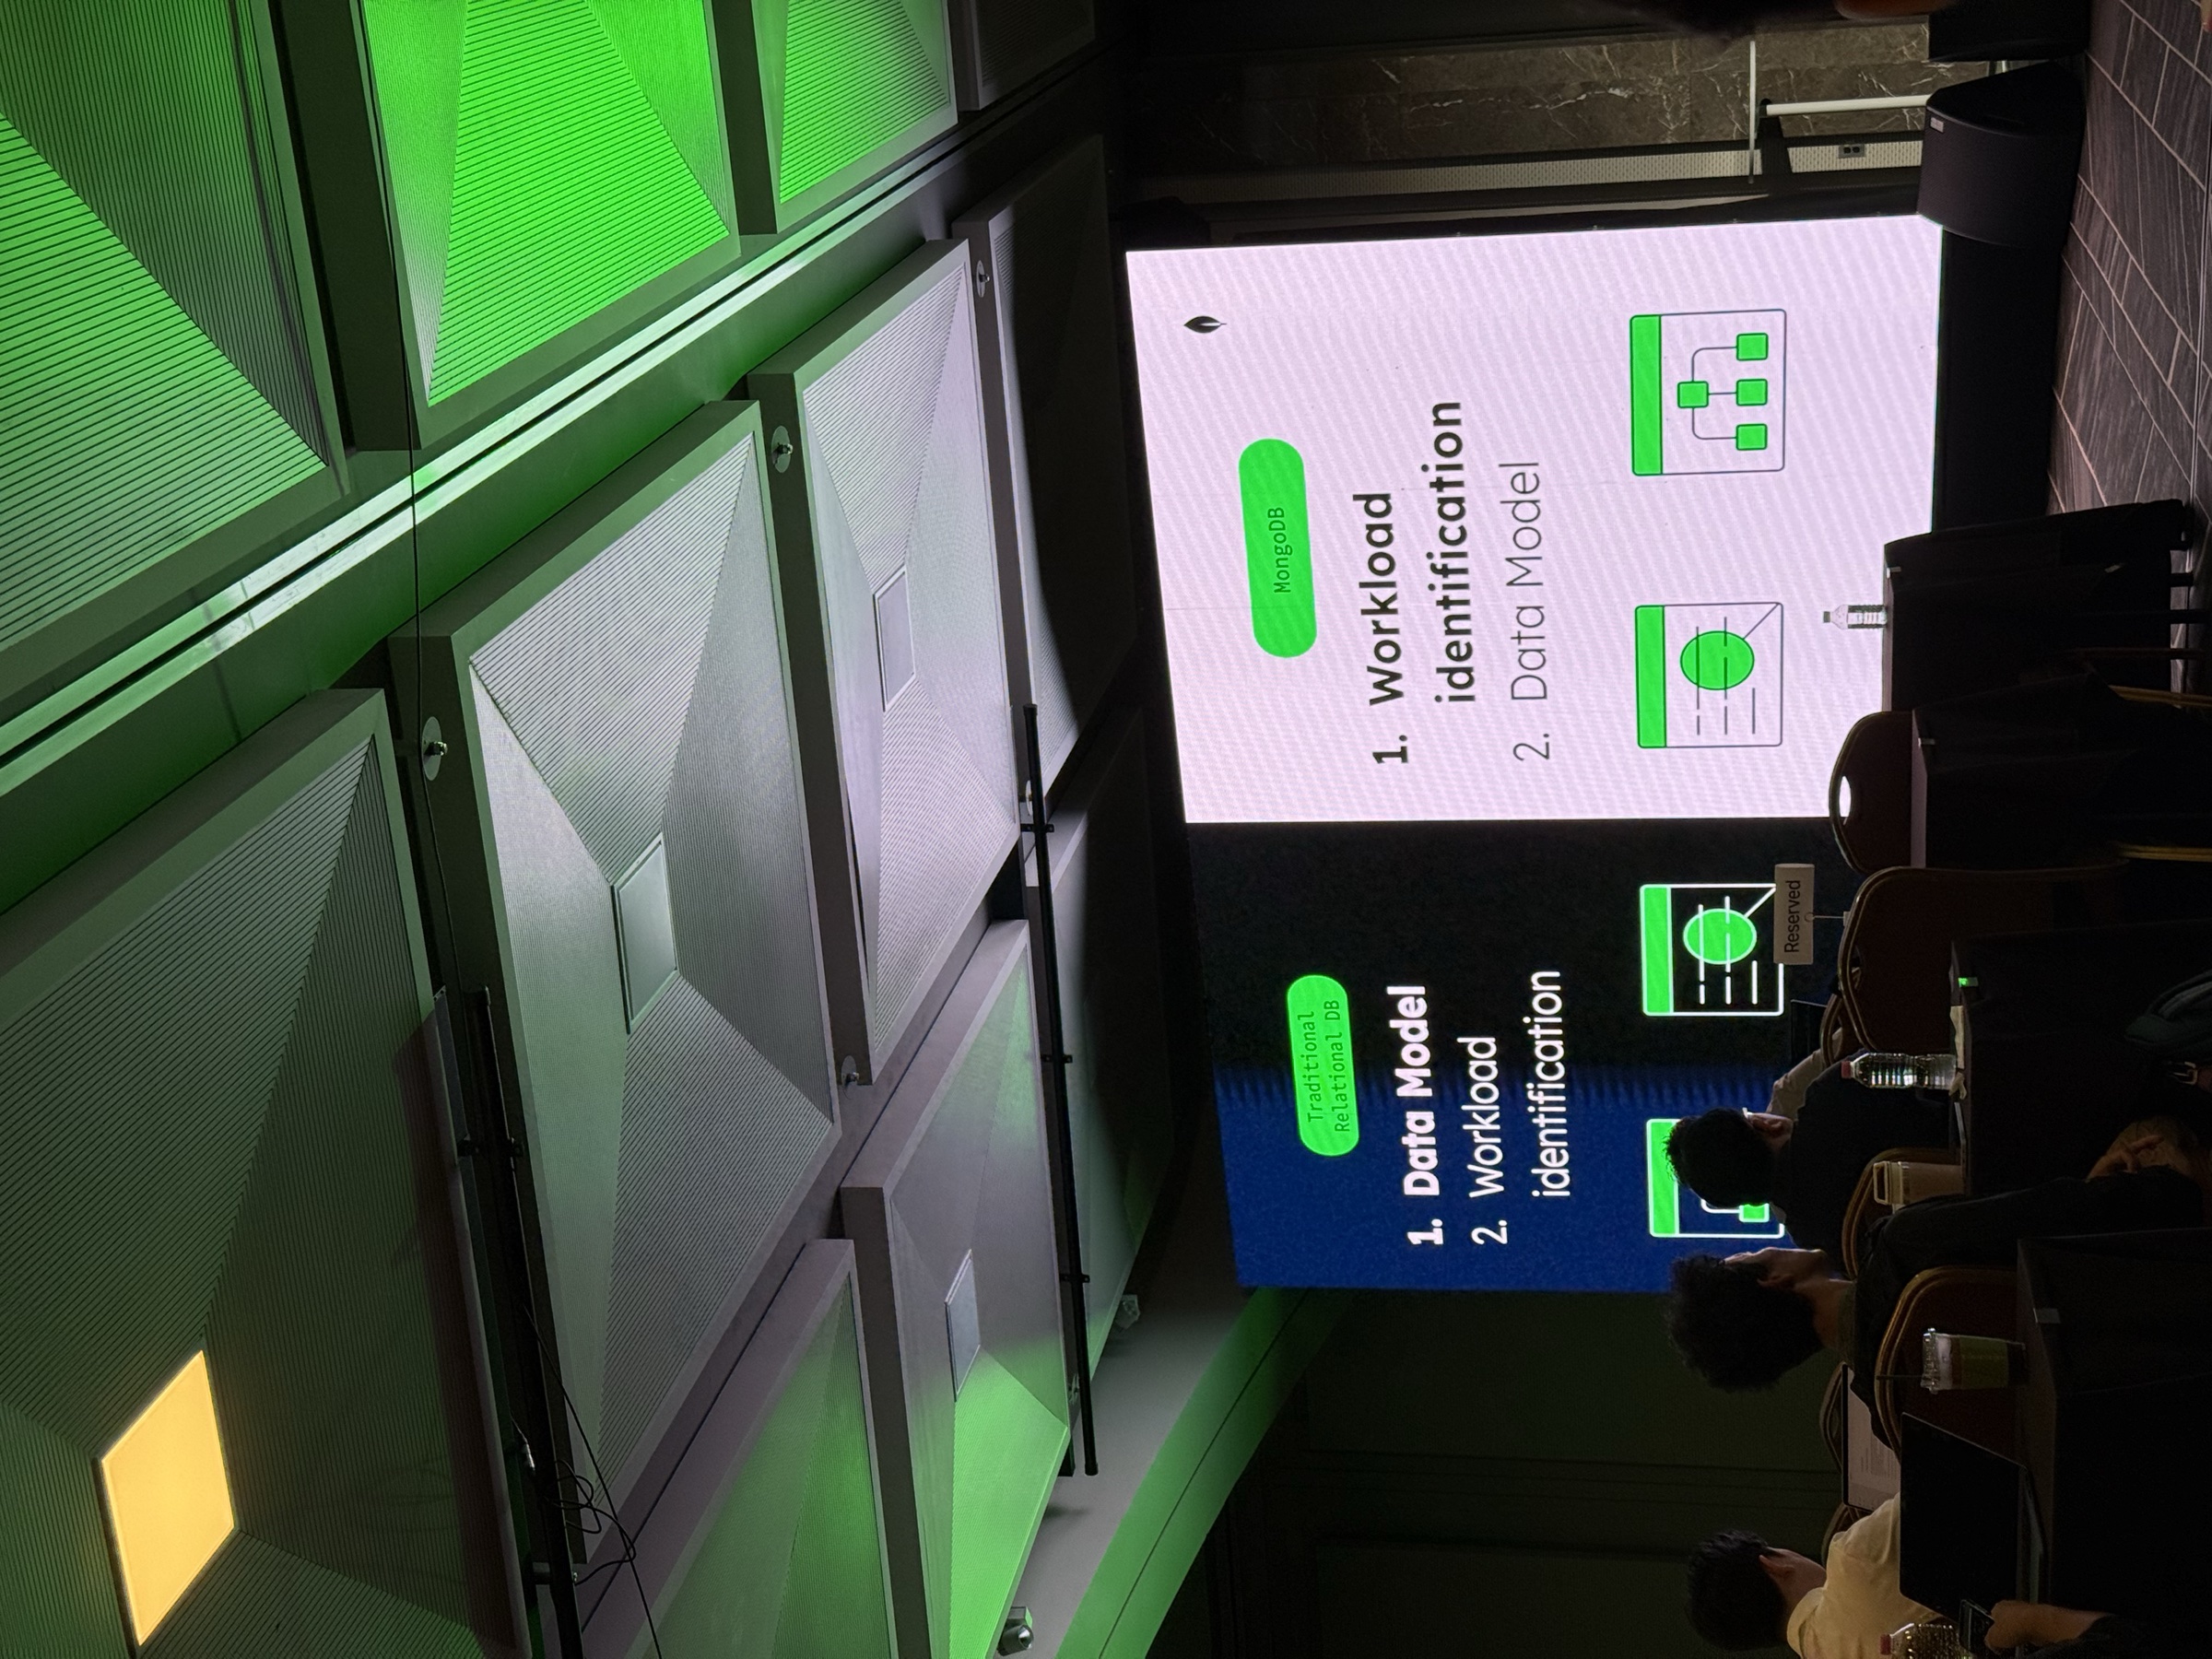
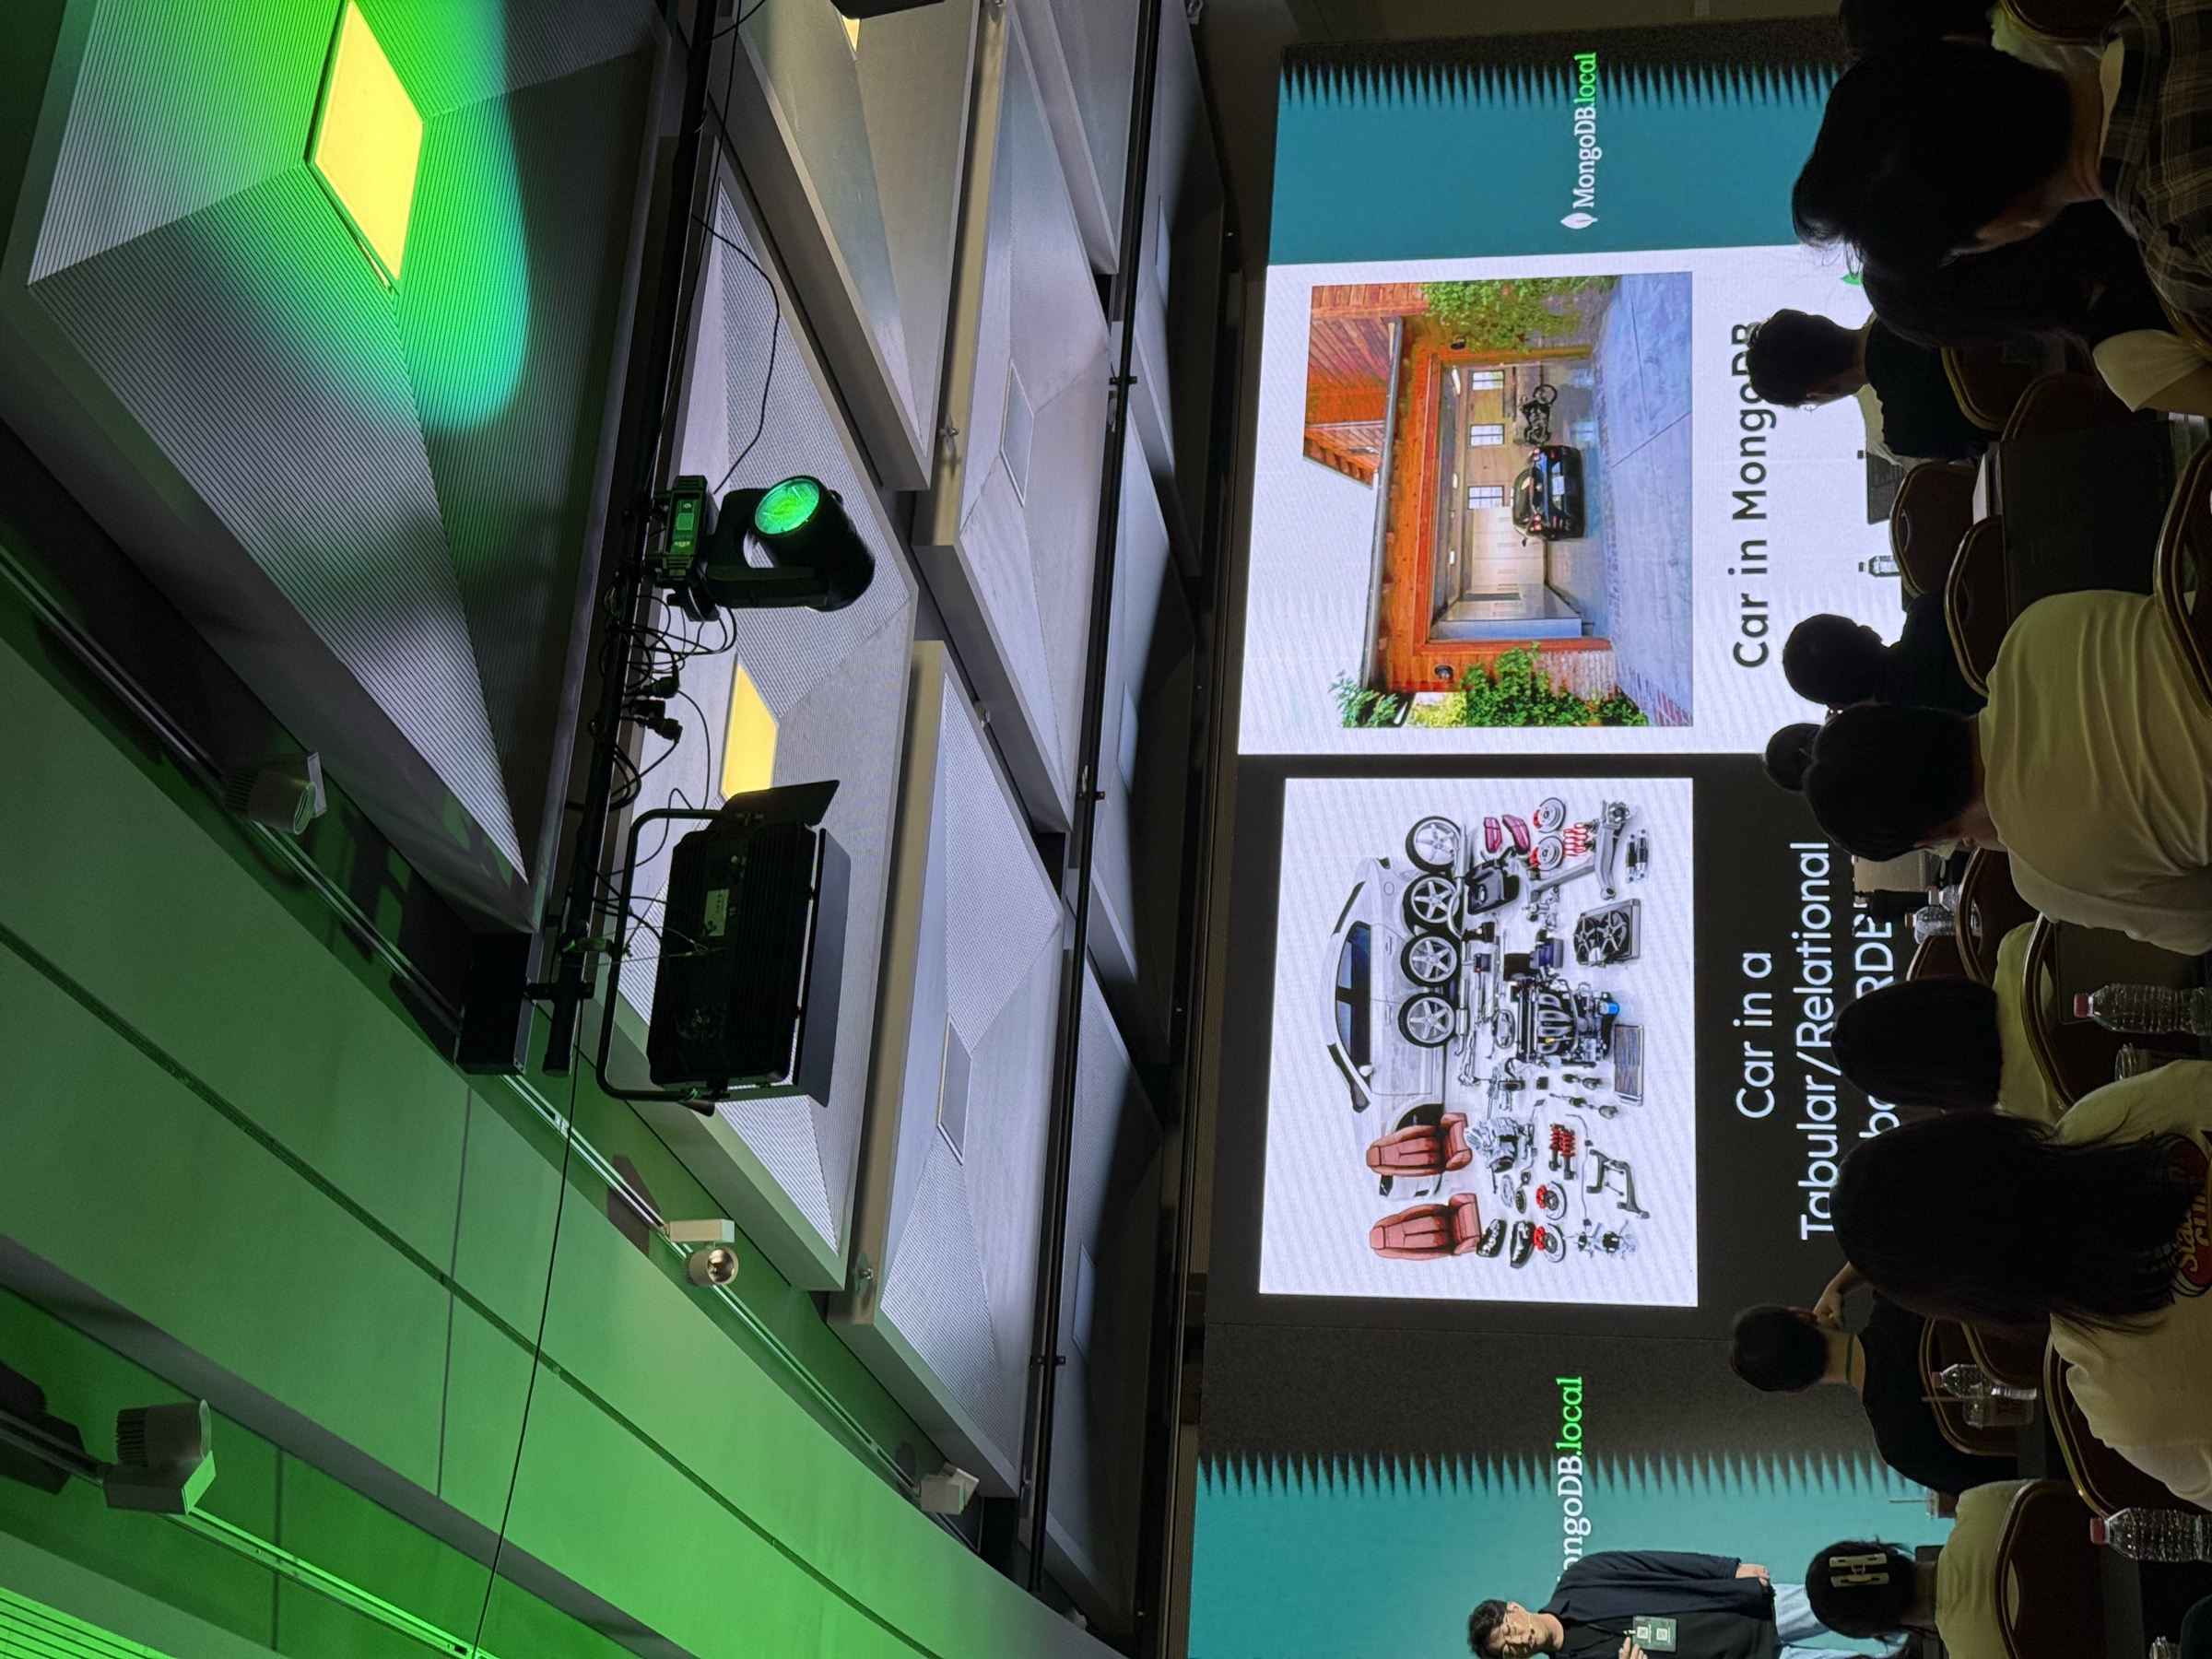
MongoDB 스키마 설계의 핵심: 완성된 자동차 vs. 부품 카탈로그
MongoDB 스키마 설계를 이해하는 가장 좋은 방법은 자동차에 비유하는 것이다.
- 일반적인 SQL (관계형 DB): 자동차 부품 카탈로그와 같다. 완성된 자동차(데이터)를 얻기 위해서는, 수많은 부품(테이블)을 개발자가 직접 찾아 일일이 조립(JOIN)해야 하는 복잡한 과정이다.
- MongoDB (문서형 DB): 이미 완성된 자동차와 같다. 데이터는 처음부터 완성된 형태(문서)로 제공되며, 개발자는 필요에 따라 이 완성품을 즉시 사용하는 개념이다.
이러한 차이 때문에 MongoDB의 스키마 설계는 ’어떻게 데이터를 효율적인 완성품으로 만들 것인가’에서 출발하며, 이 판단의 가장 중요한 기준이 바로 워크로드이다.
- 일반적인 SQL (관계형 DB): 자동차 부품 카탈로그와 같다. 완성된 자동차(데이터)를 얻기 위해서는, 카탈로그에 나열된 수많은 부품(테이블)을 개발자가 직접 찾아 일일이 조립(JOIN)해야 하는 복잡한 과정이다.
- MongoDB (문서형 DB): 이미 완성된 자동차와 같다. 데이터는 처음부터 완성된 형태(문서)로 제공되며, 개발자는 필요에 따라 이 완성품을 즉시 사용하거나 일부를 수정하는 개념이다. 이러한 근본적인 차이 때문에 MongoDB의 스키마 설계는 ’어떻게 데이터를 효율적인 완성품으로 만들 것인가’에서 출발하며, 이 판단의 가장 중요한 기준이 바로 워크로드이다.
아래 이미지가 이 MongoDB라는 것을 가장 직관적으로 표현한 것이 아닐까라는 생각을 한다.
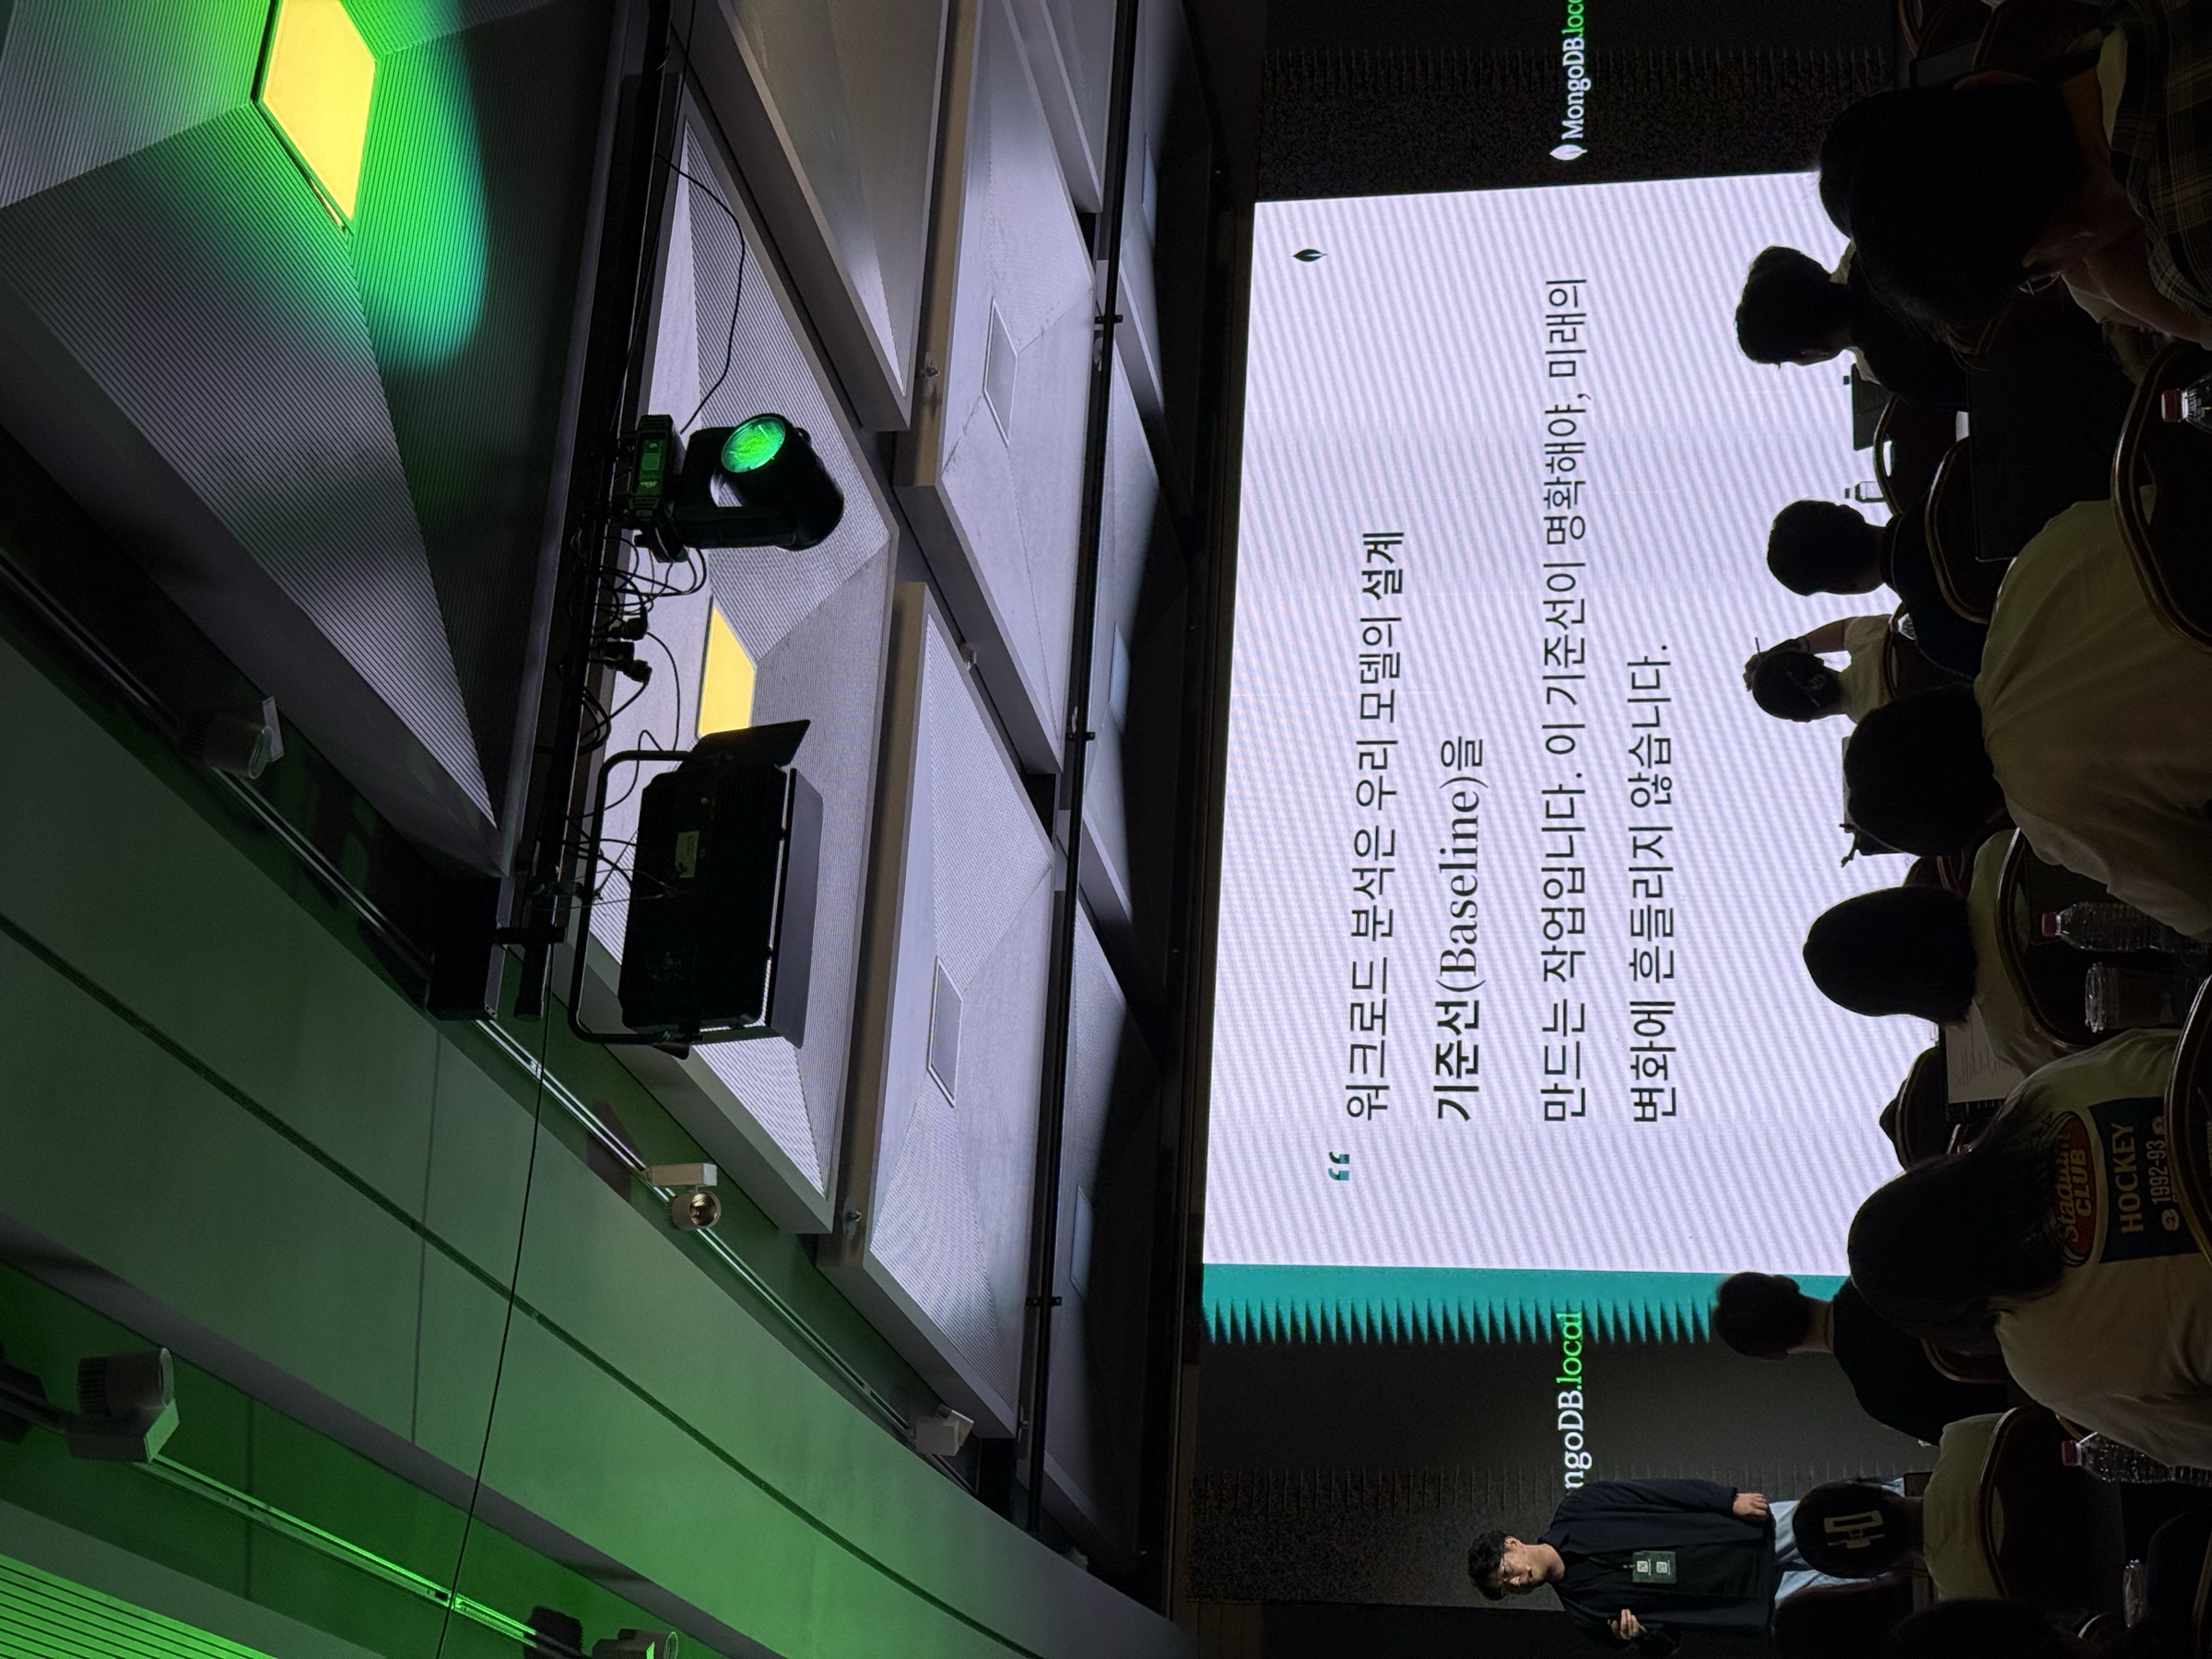
스키마 설계의 기준선, 워크로드(Workload)
워크로드란 애플리케이션이 데이터를 어떻게, 얼마나 자주 읽고 쓰는지에 대한 총체적인 분석이다. 이는 단순히 데이터의 관계를 넘어, 실제 비즈니스 로직과 사용자 행동이 데이터베이스에 어떤 영향을 미치는지를 파악하는 과정이다.
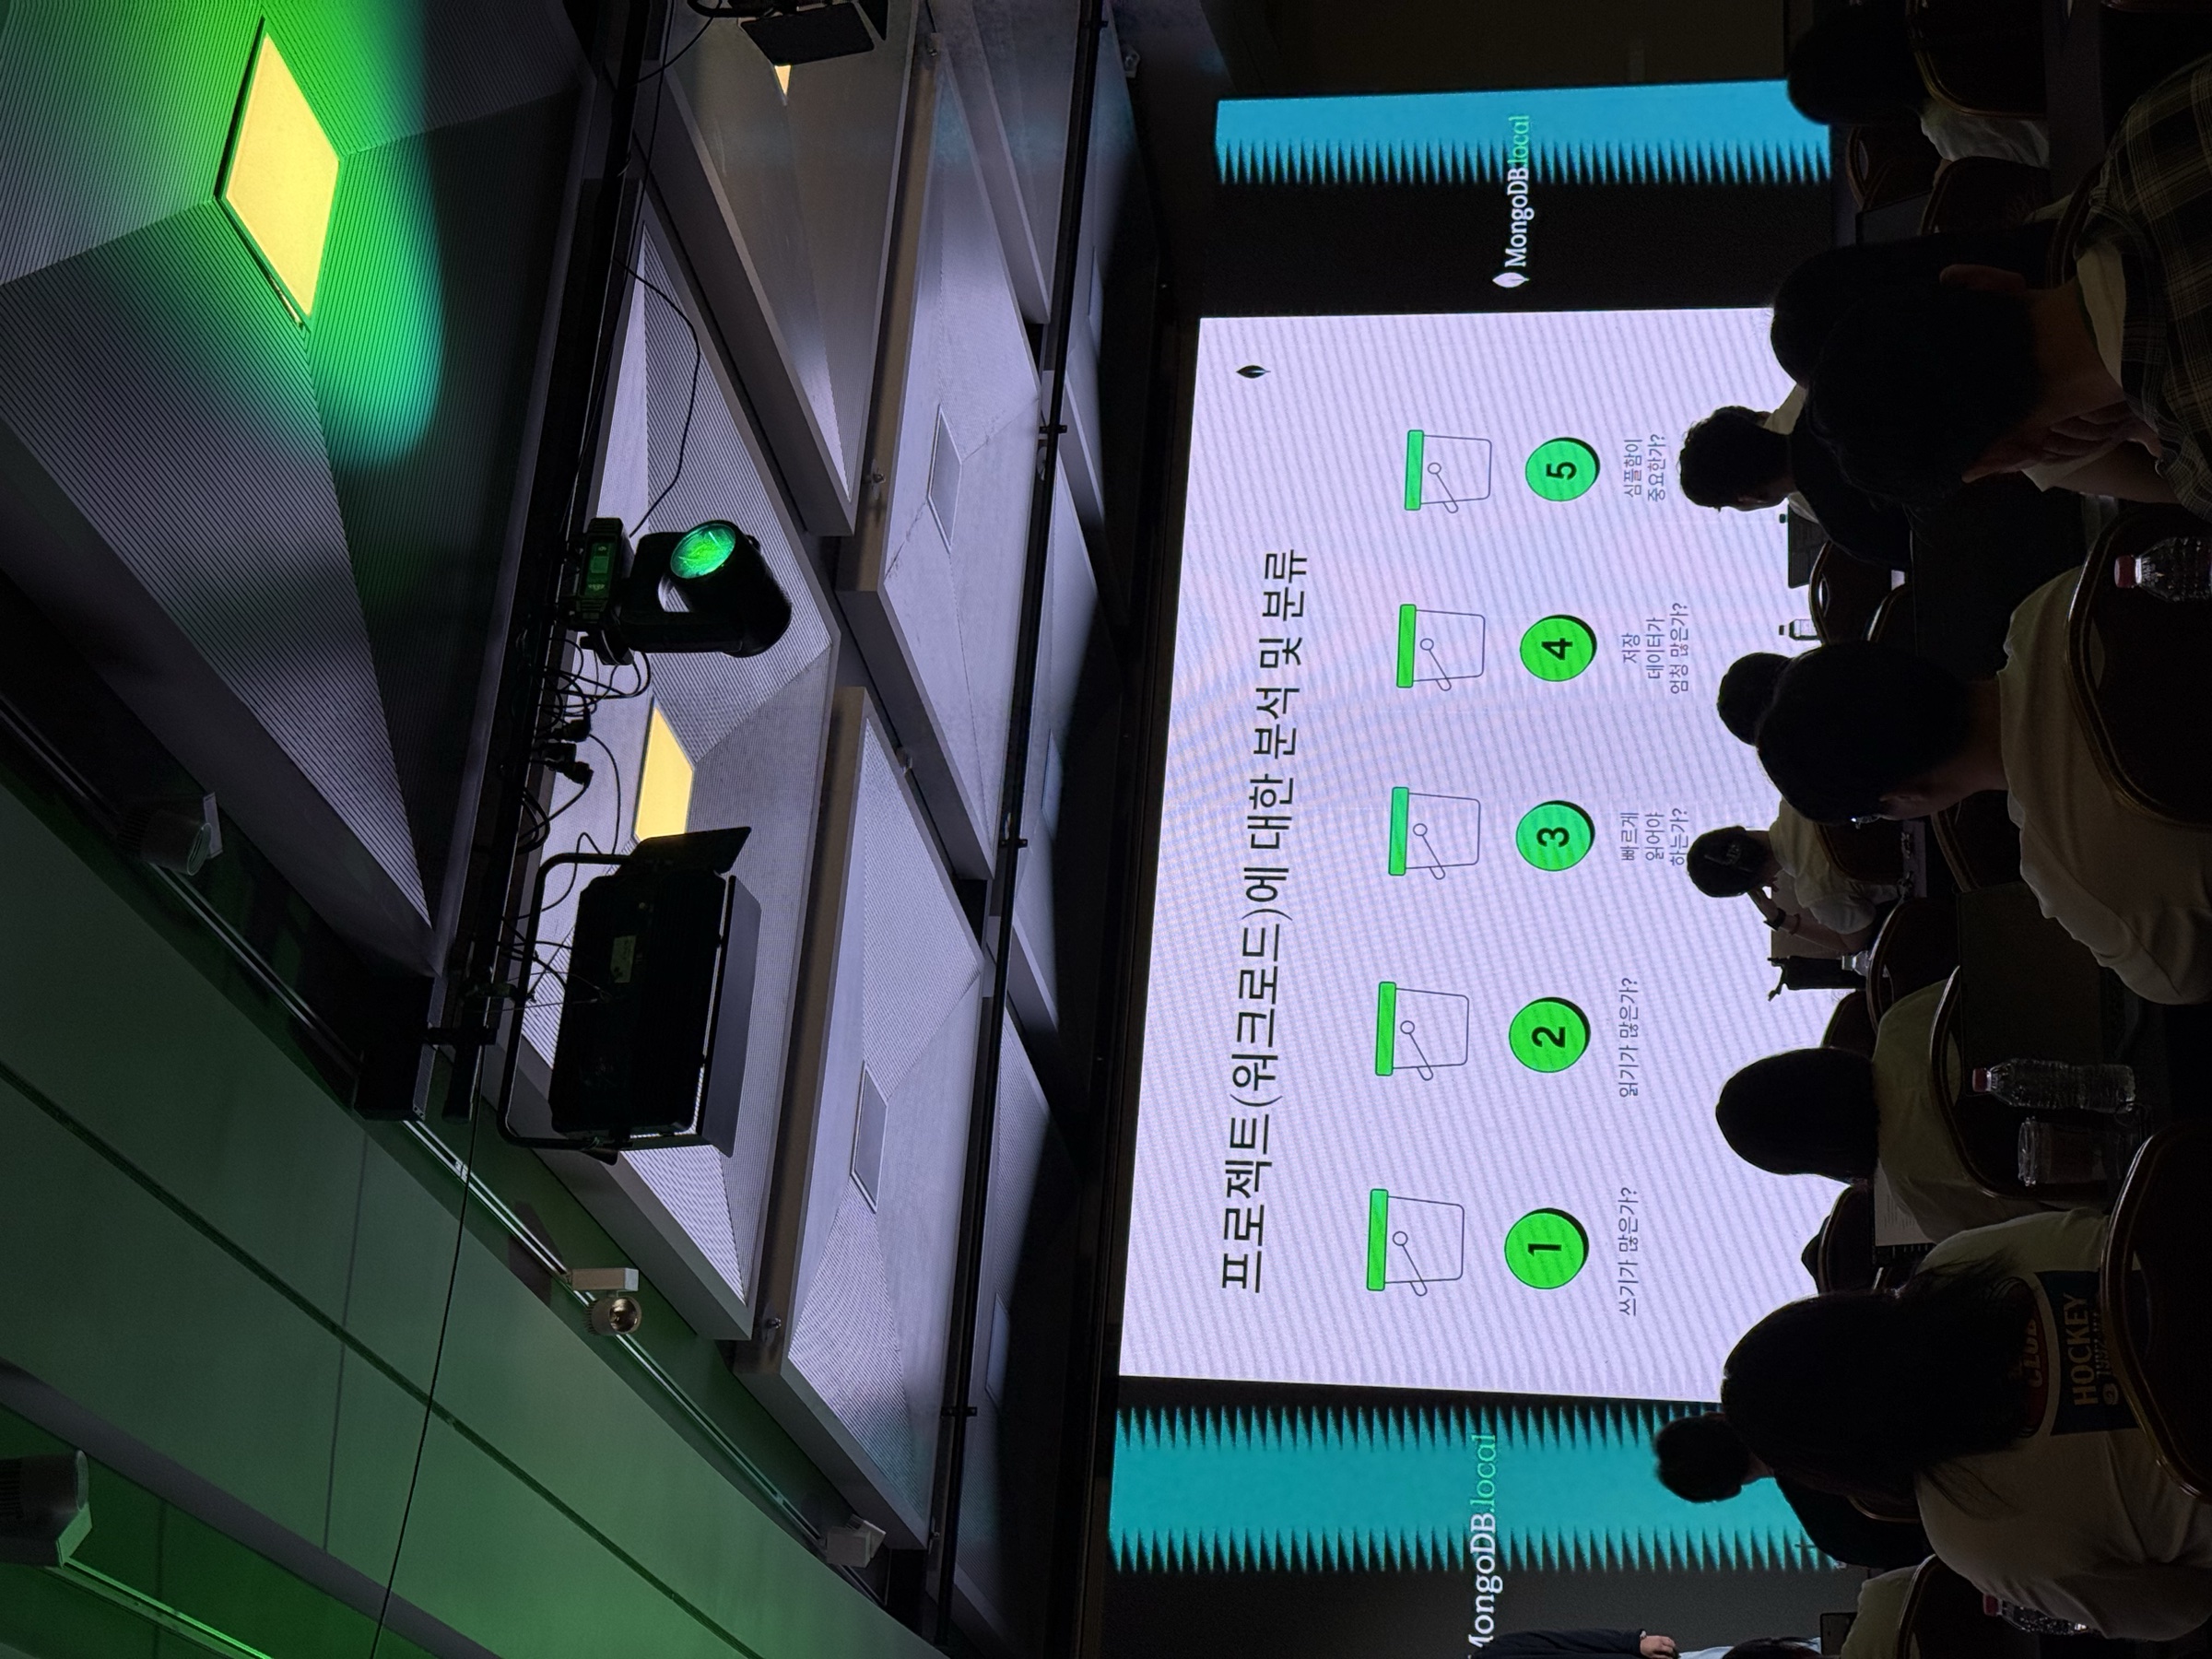
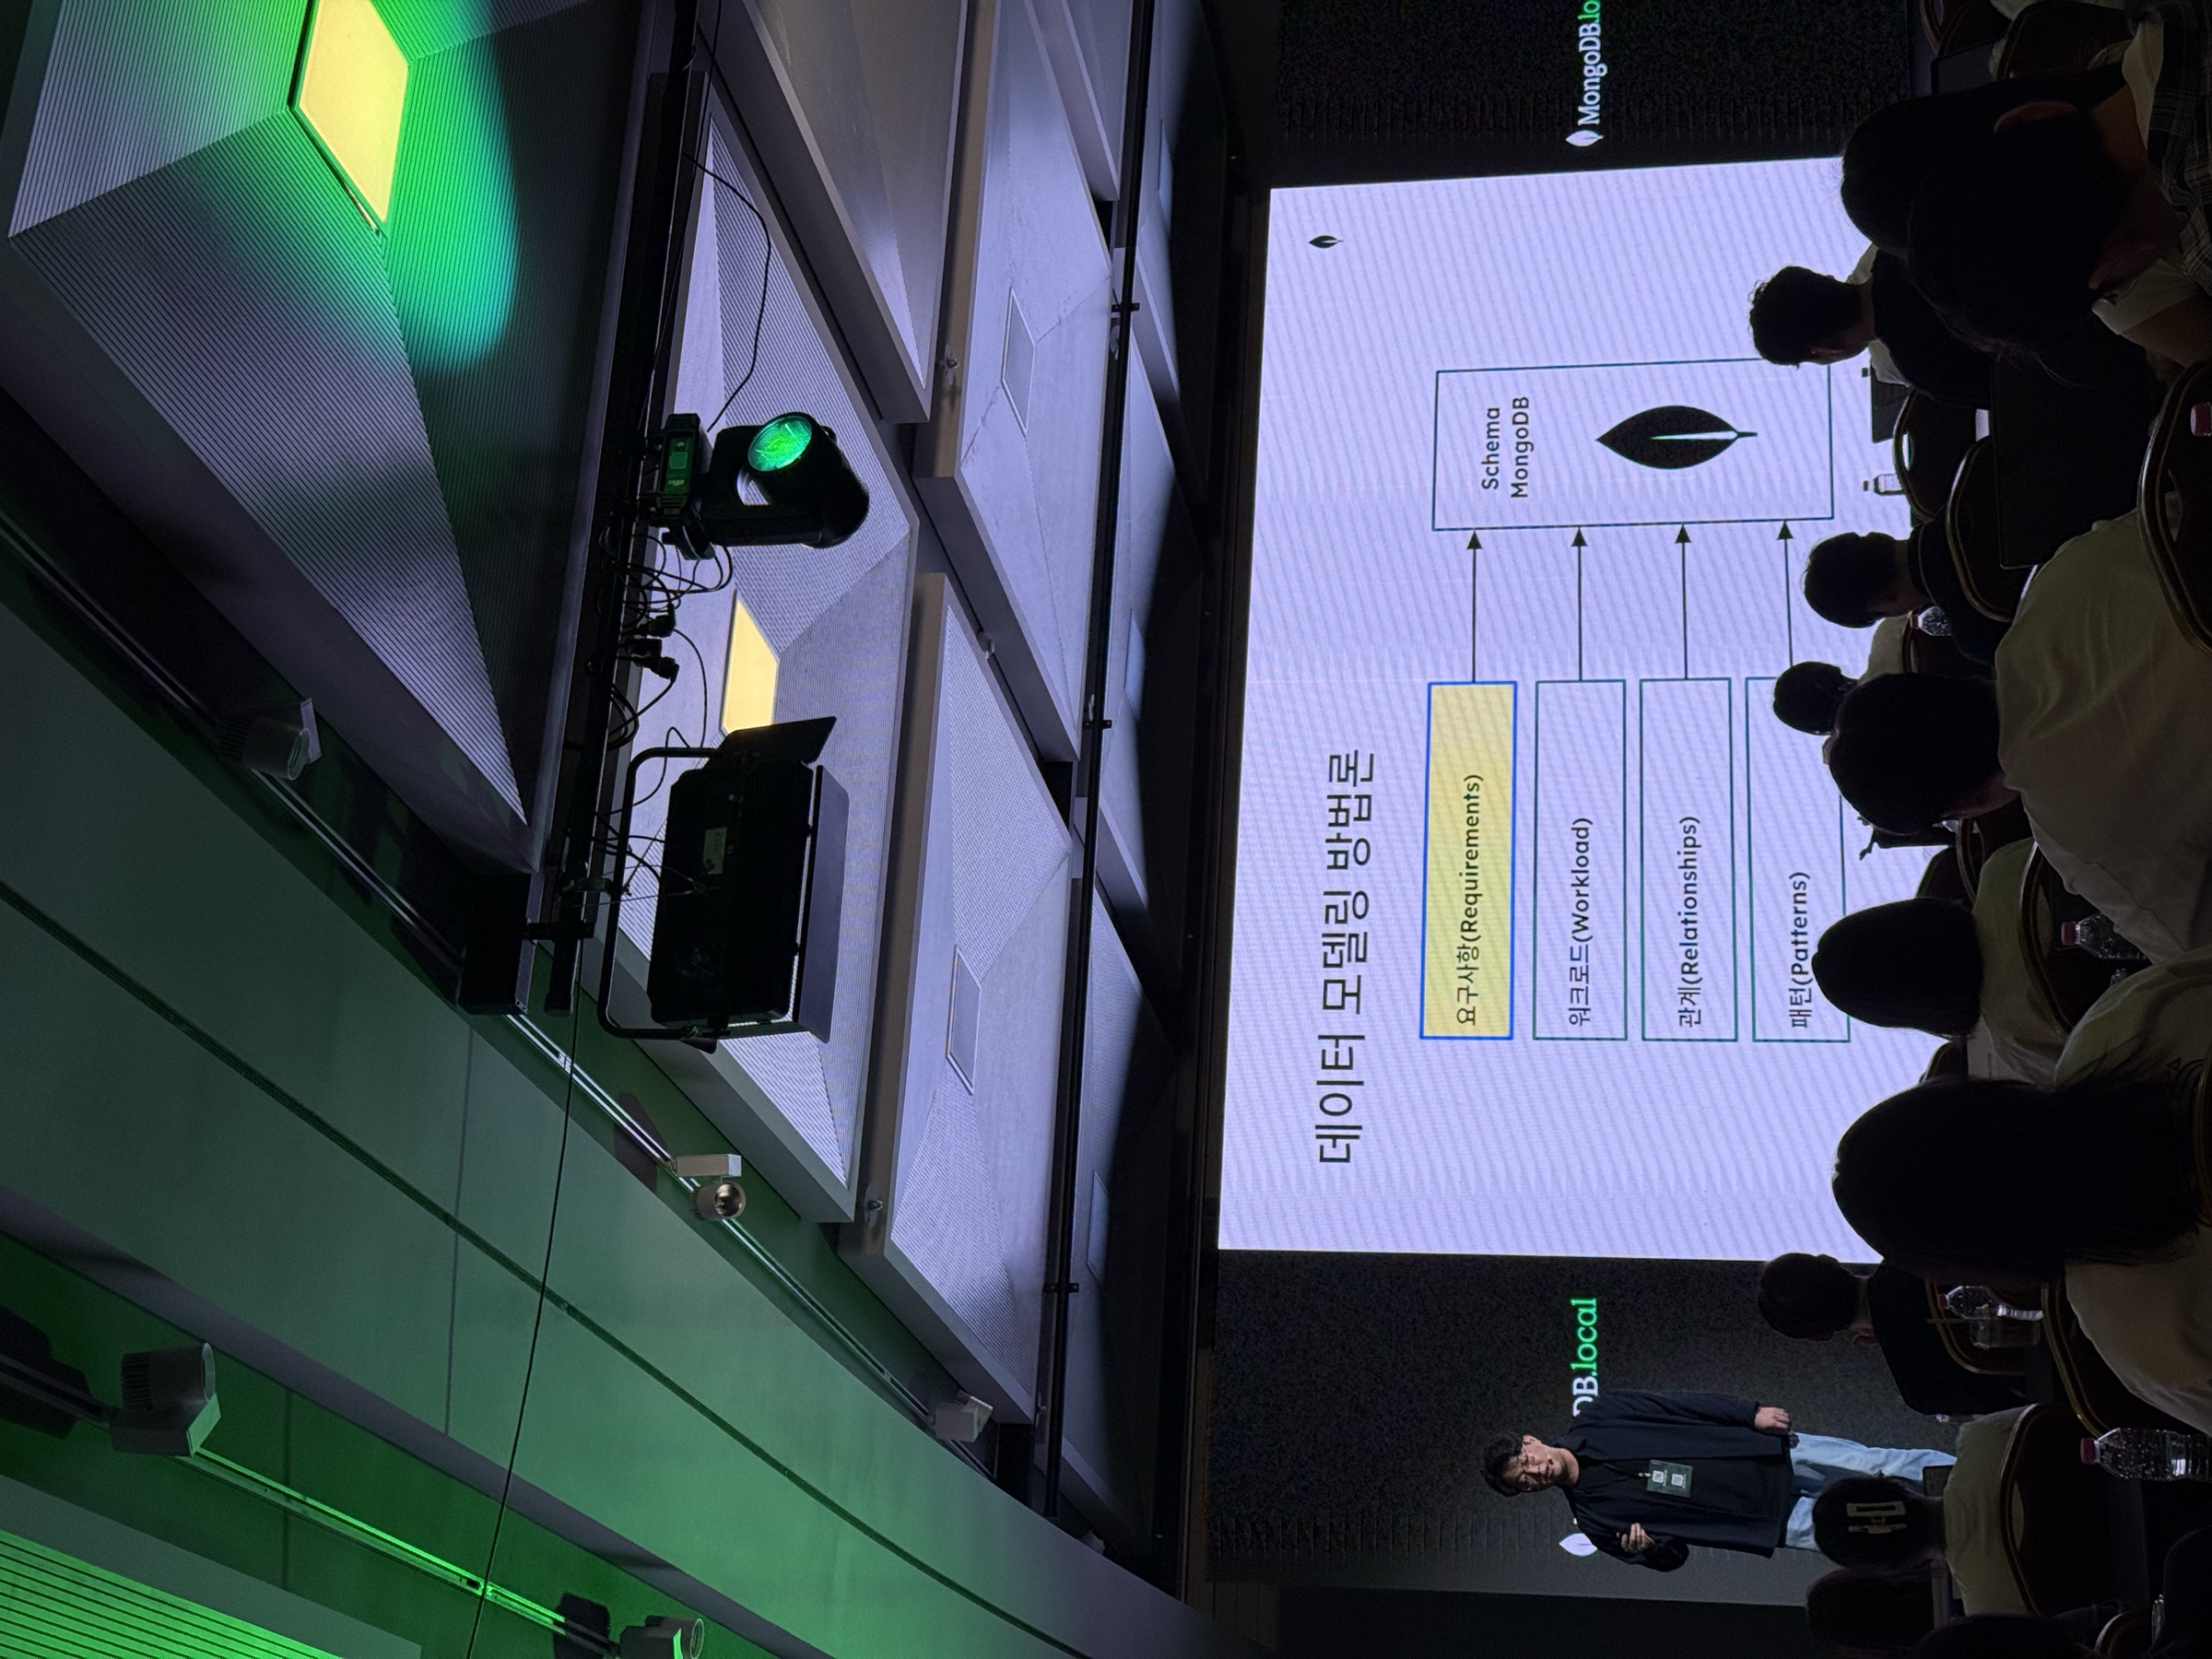
훌륭한 셰프가 만들 요리(워크로드)를 먼저 고려하여 주방을 설계하듯, MongoDB 스키마는 애플리케이션의 고유한 워크로드에 맞춰 최적화되어야 한다. 이를 위해 비즈니스 요구사항 분석, 데이터 관계도(DRD) 작성 후, 예상되는 부하와 데이터 사용 패턴을 포함한 상세한 워크로드 분석이 선행되어야 한다.
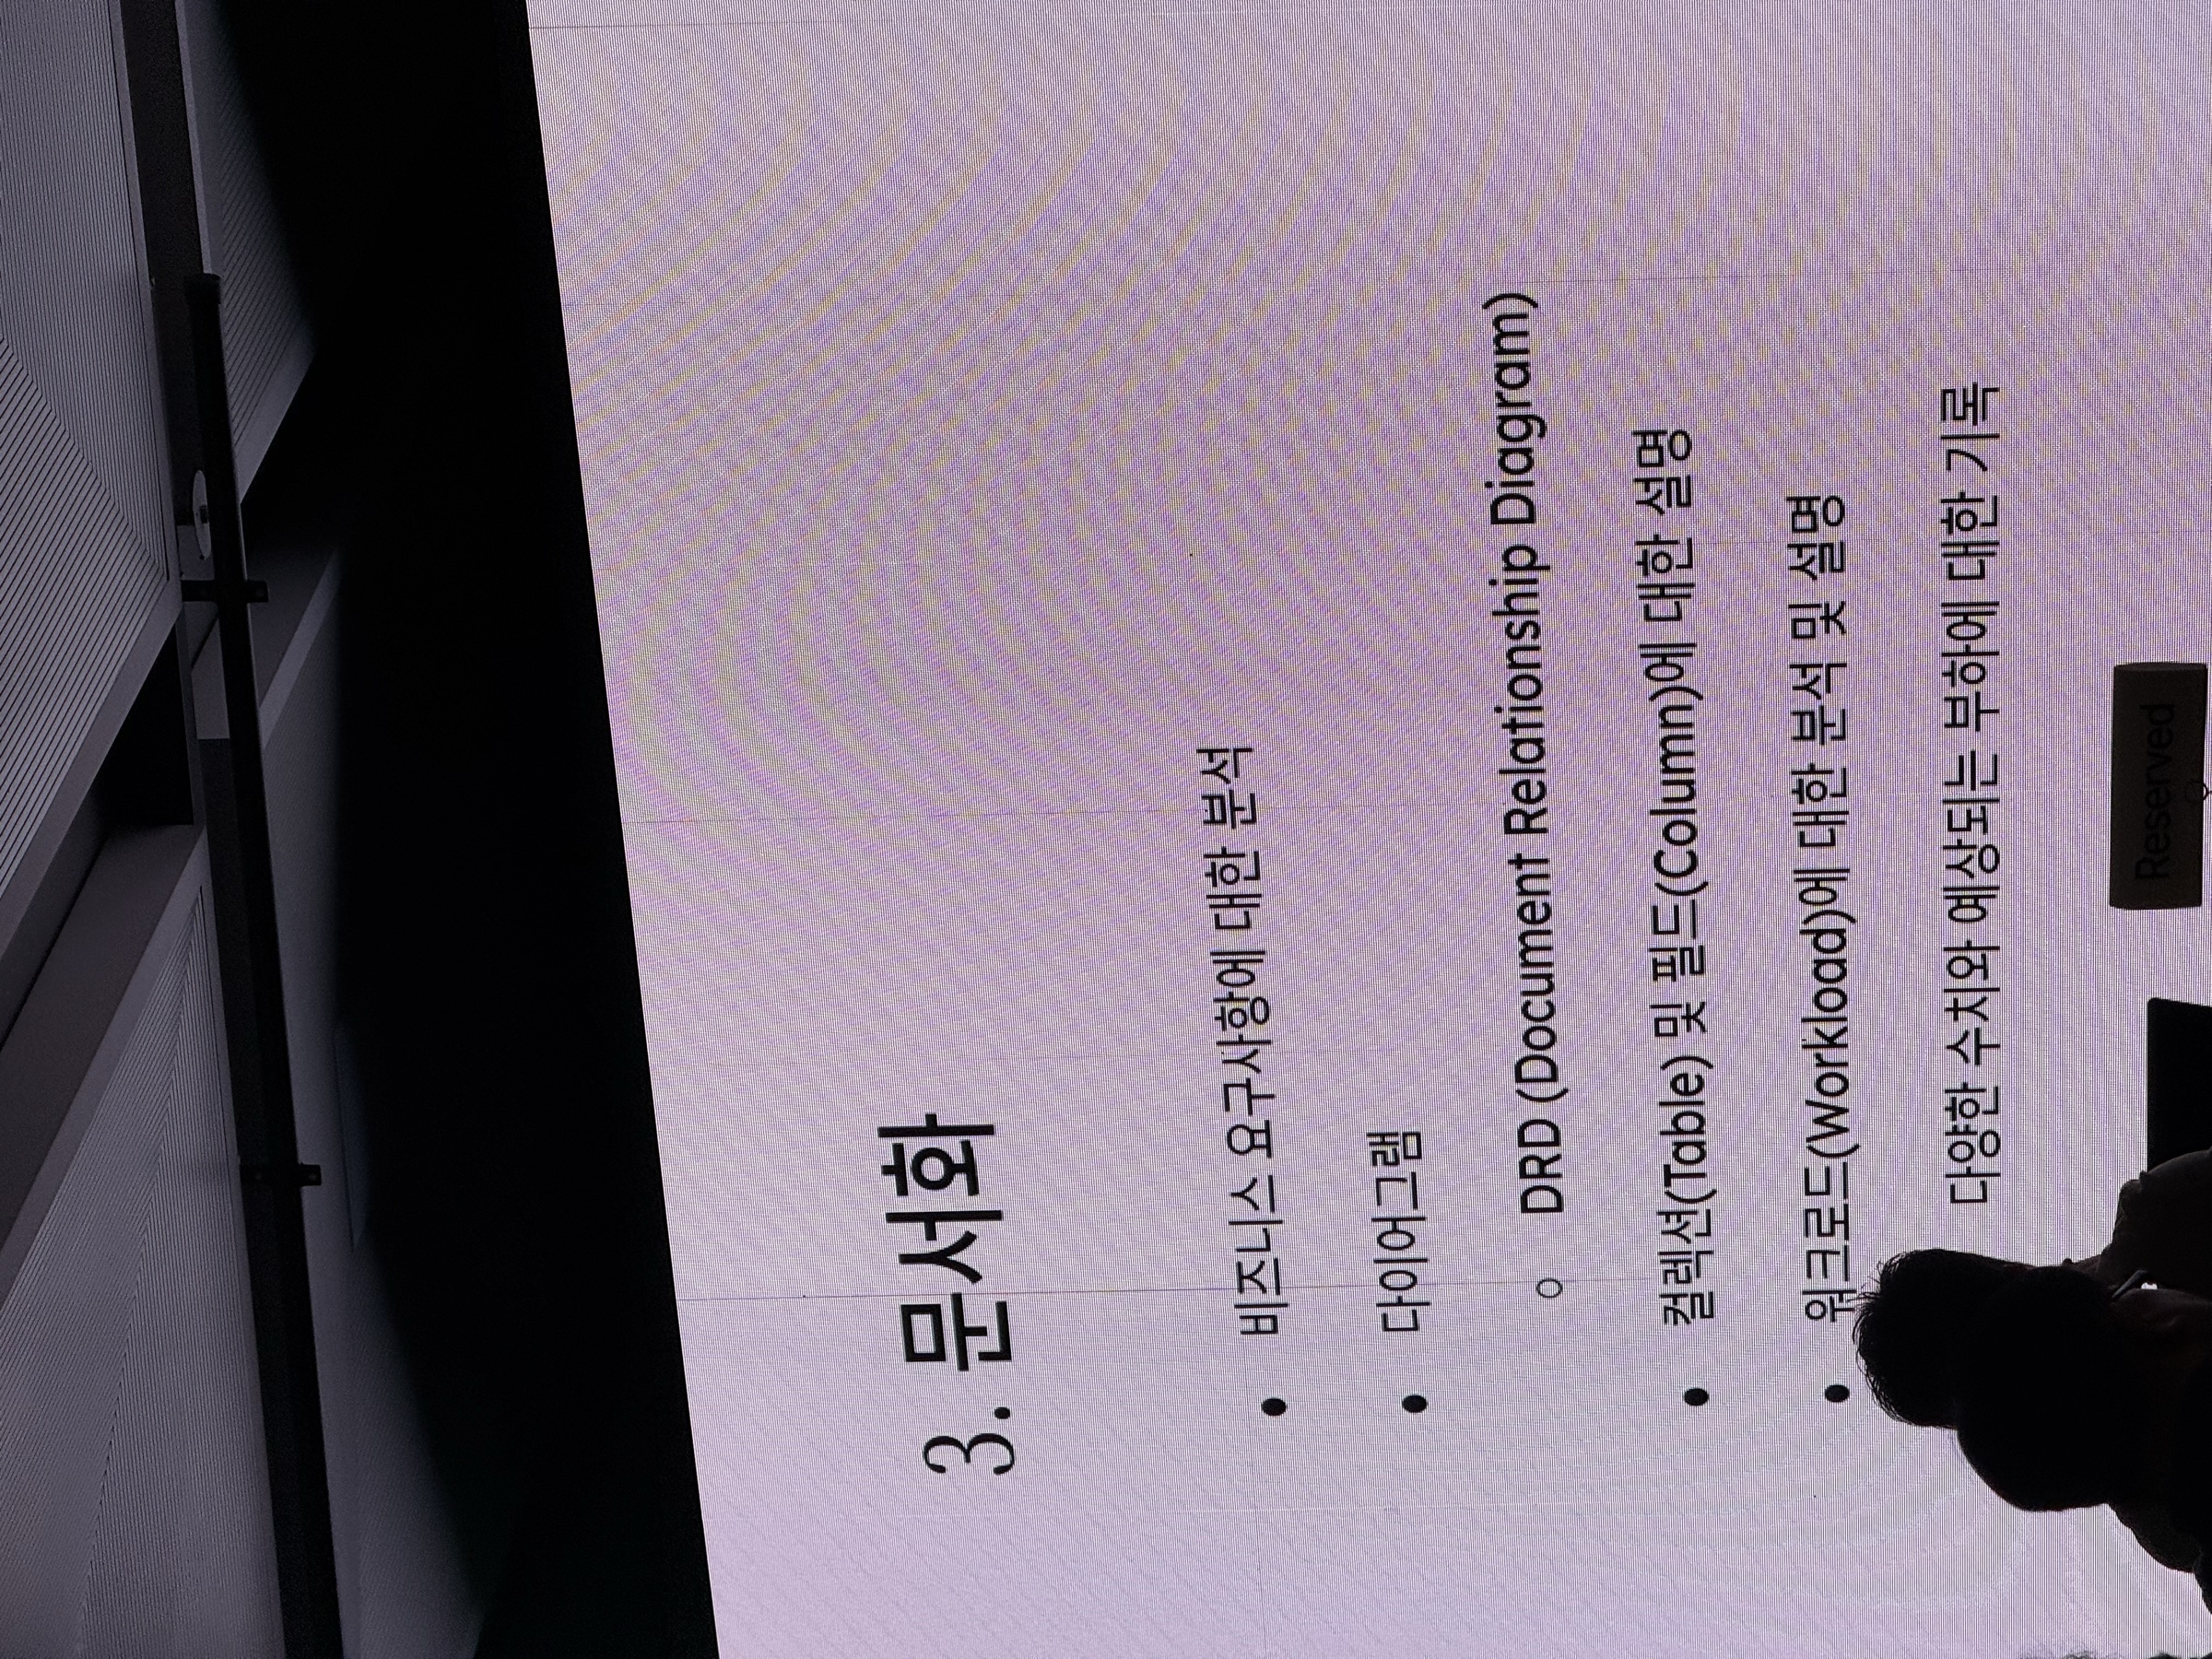
워크로드 분석: 스키마 설계를 위한 체크리스트
워크로드를 분석할 때는 아래와 같은 구체적인 질문들을 통해 데이터의 특성을 다각도로 파악해야 한다. 이 질문들에 대한 답이 모여 임베딩과 레퍼런싱을 결정하는 중요한 근거가 된다.
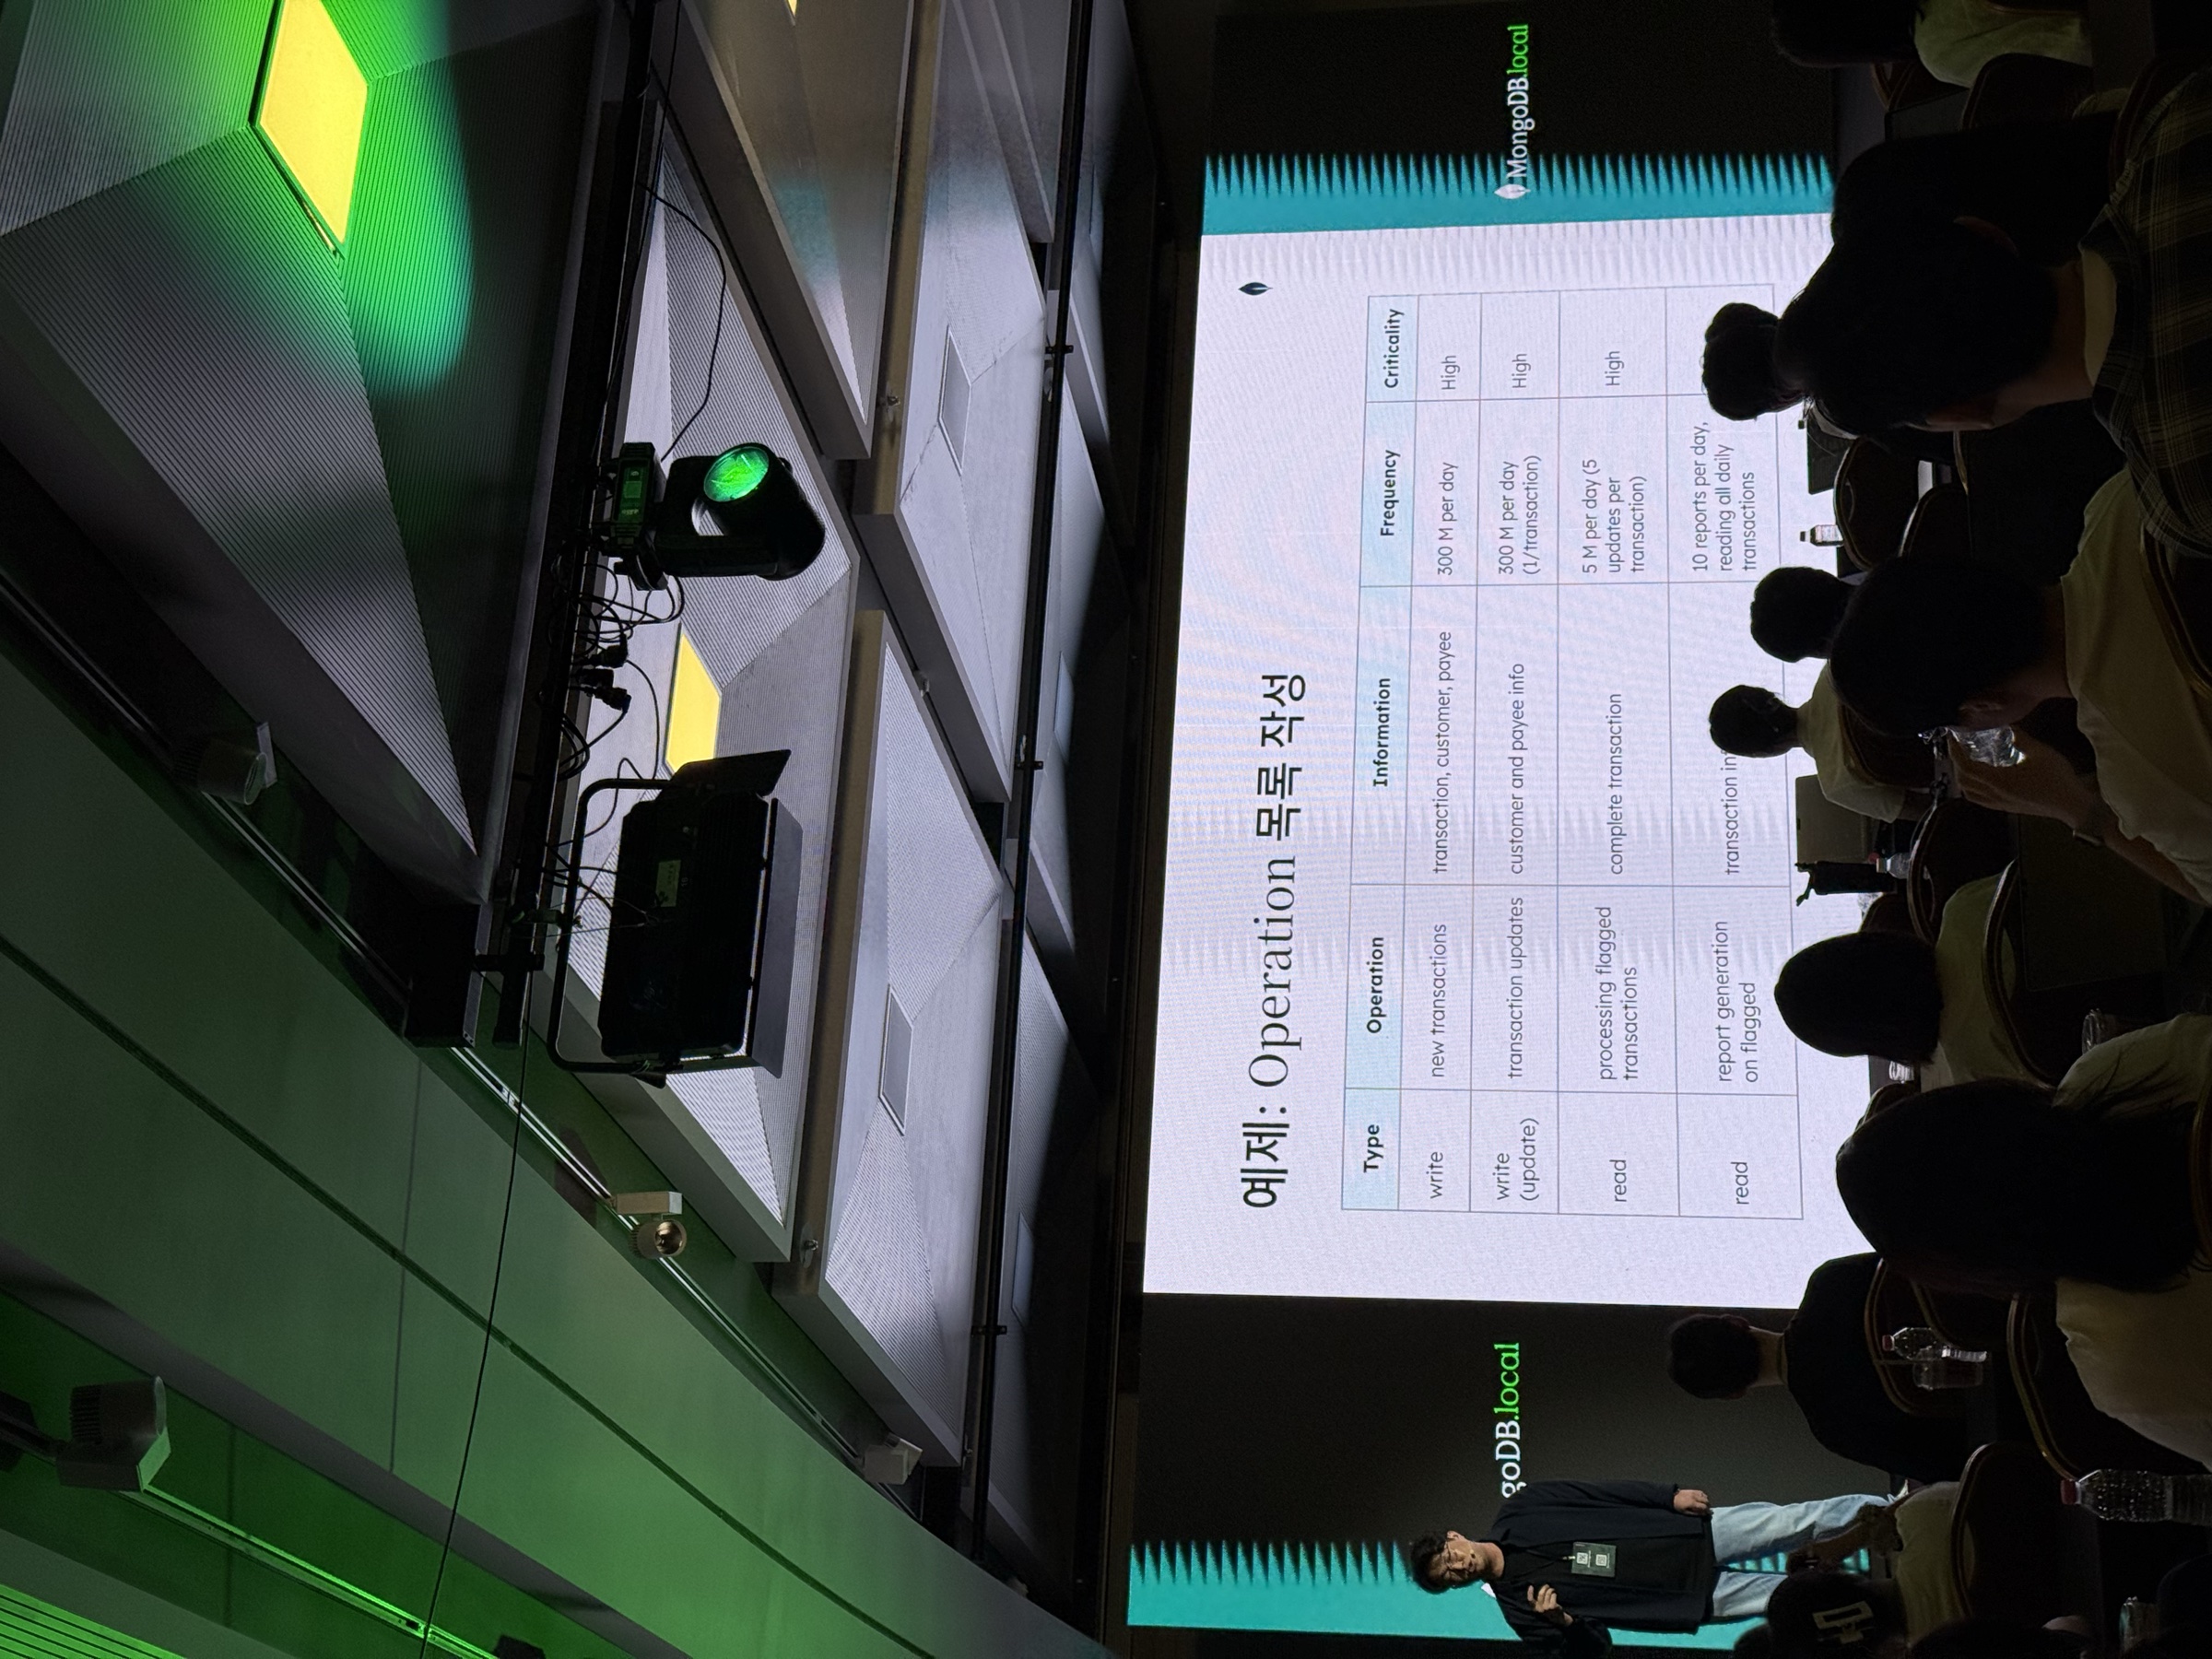
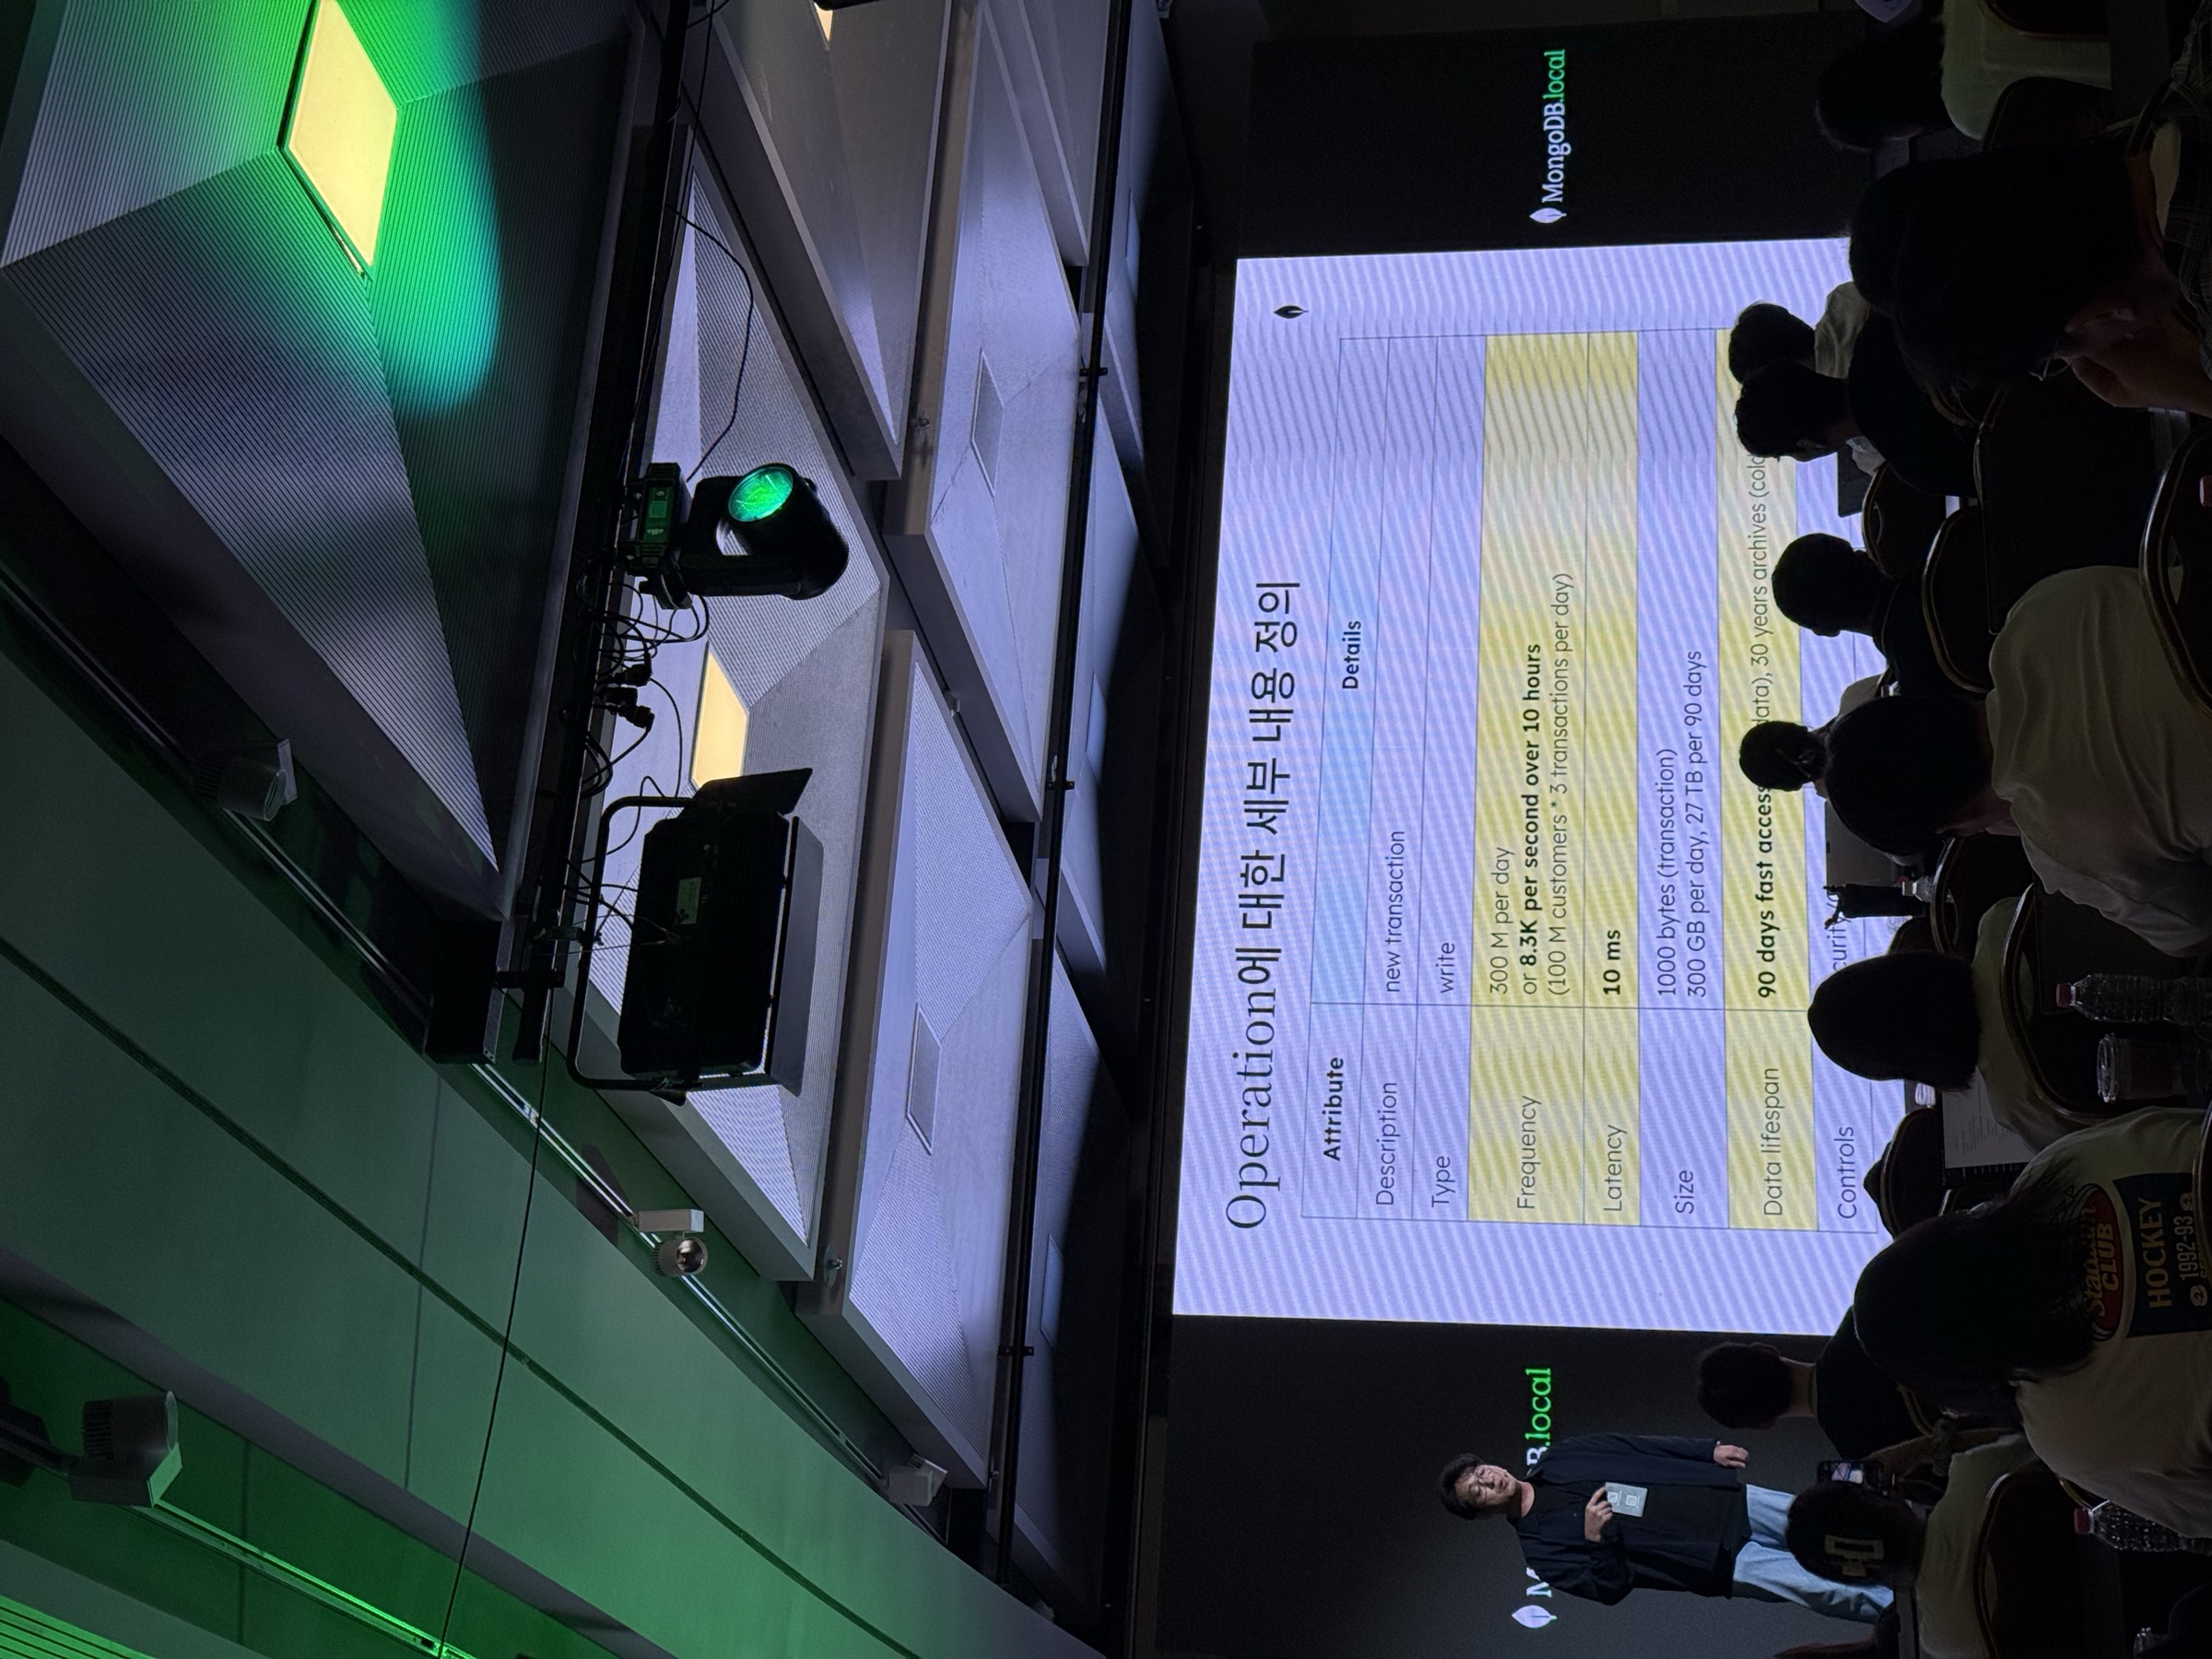
1. 데이터의 관계와 접근 패턴
데이터가 애플리케이션 내에서 어떻게 함께 사용되는지를 분석한다.
- 연관성 (Go Together) 및 조회 원자성 (Query Atomicity): 데이터들이 “블로그 게시물이 댓글을 가진다”와 같이 논리적으로 강하게 연결되어 있으며, 조회할 때 항상 함께 가져와야 하는가? → 그렇다면 임베딩이 유리하다.
- 단순성 (Simplicity): 데이터를 함께 묶어두는 것이 애플리케이션 코드와 데이터 모델을 더 단순하고 직관적으로 만드는가?
- 업데이트 복잡성 (Update Complexity): 관련된 정보들이 동시에 함께 업데이트되는 경향이 있는가? → 그렇다면 하나의 문서로 묶어 한 번의 작업으로 처리하는 것이 효율적이다.
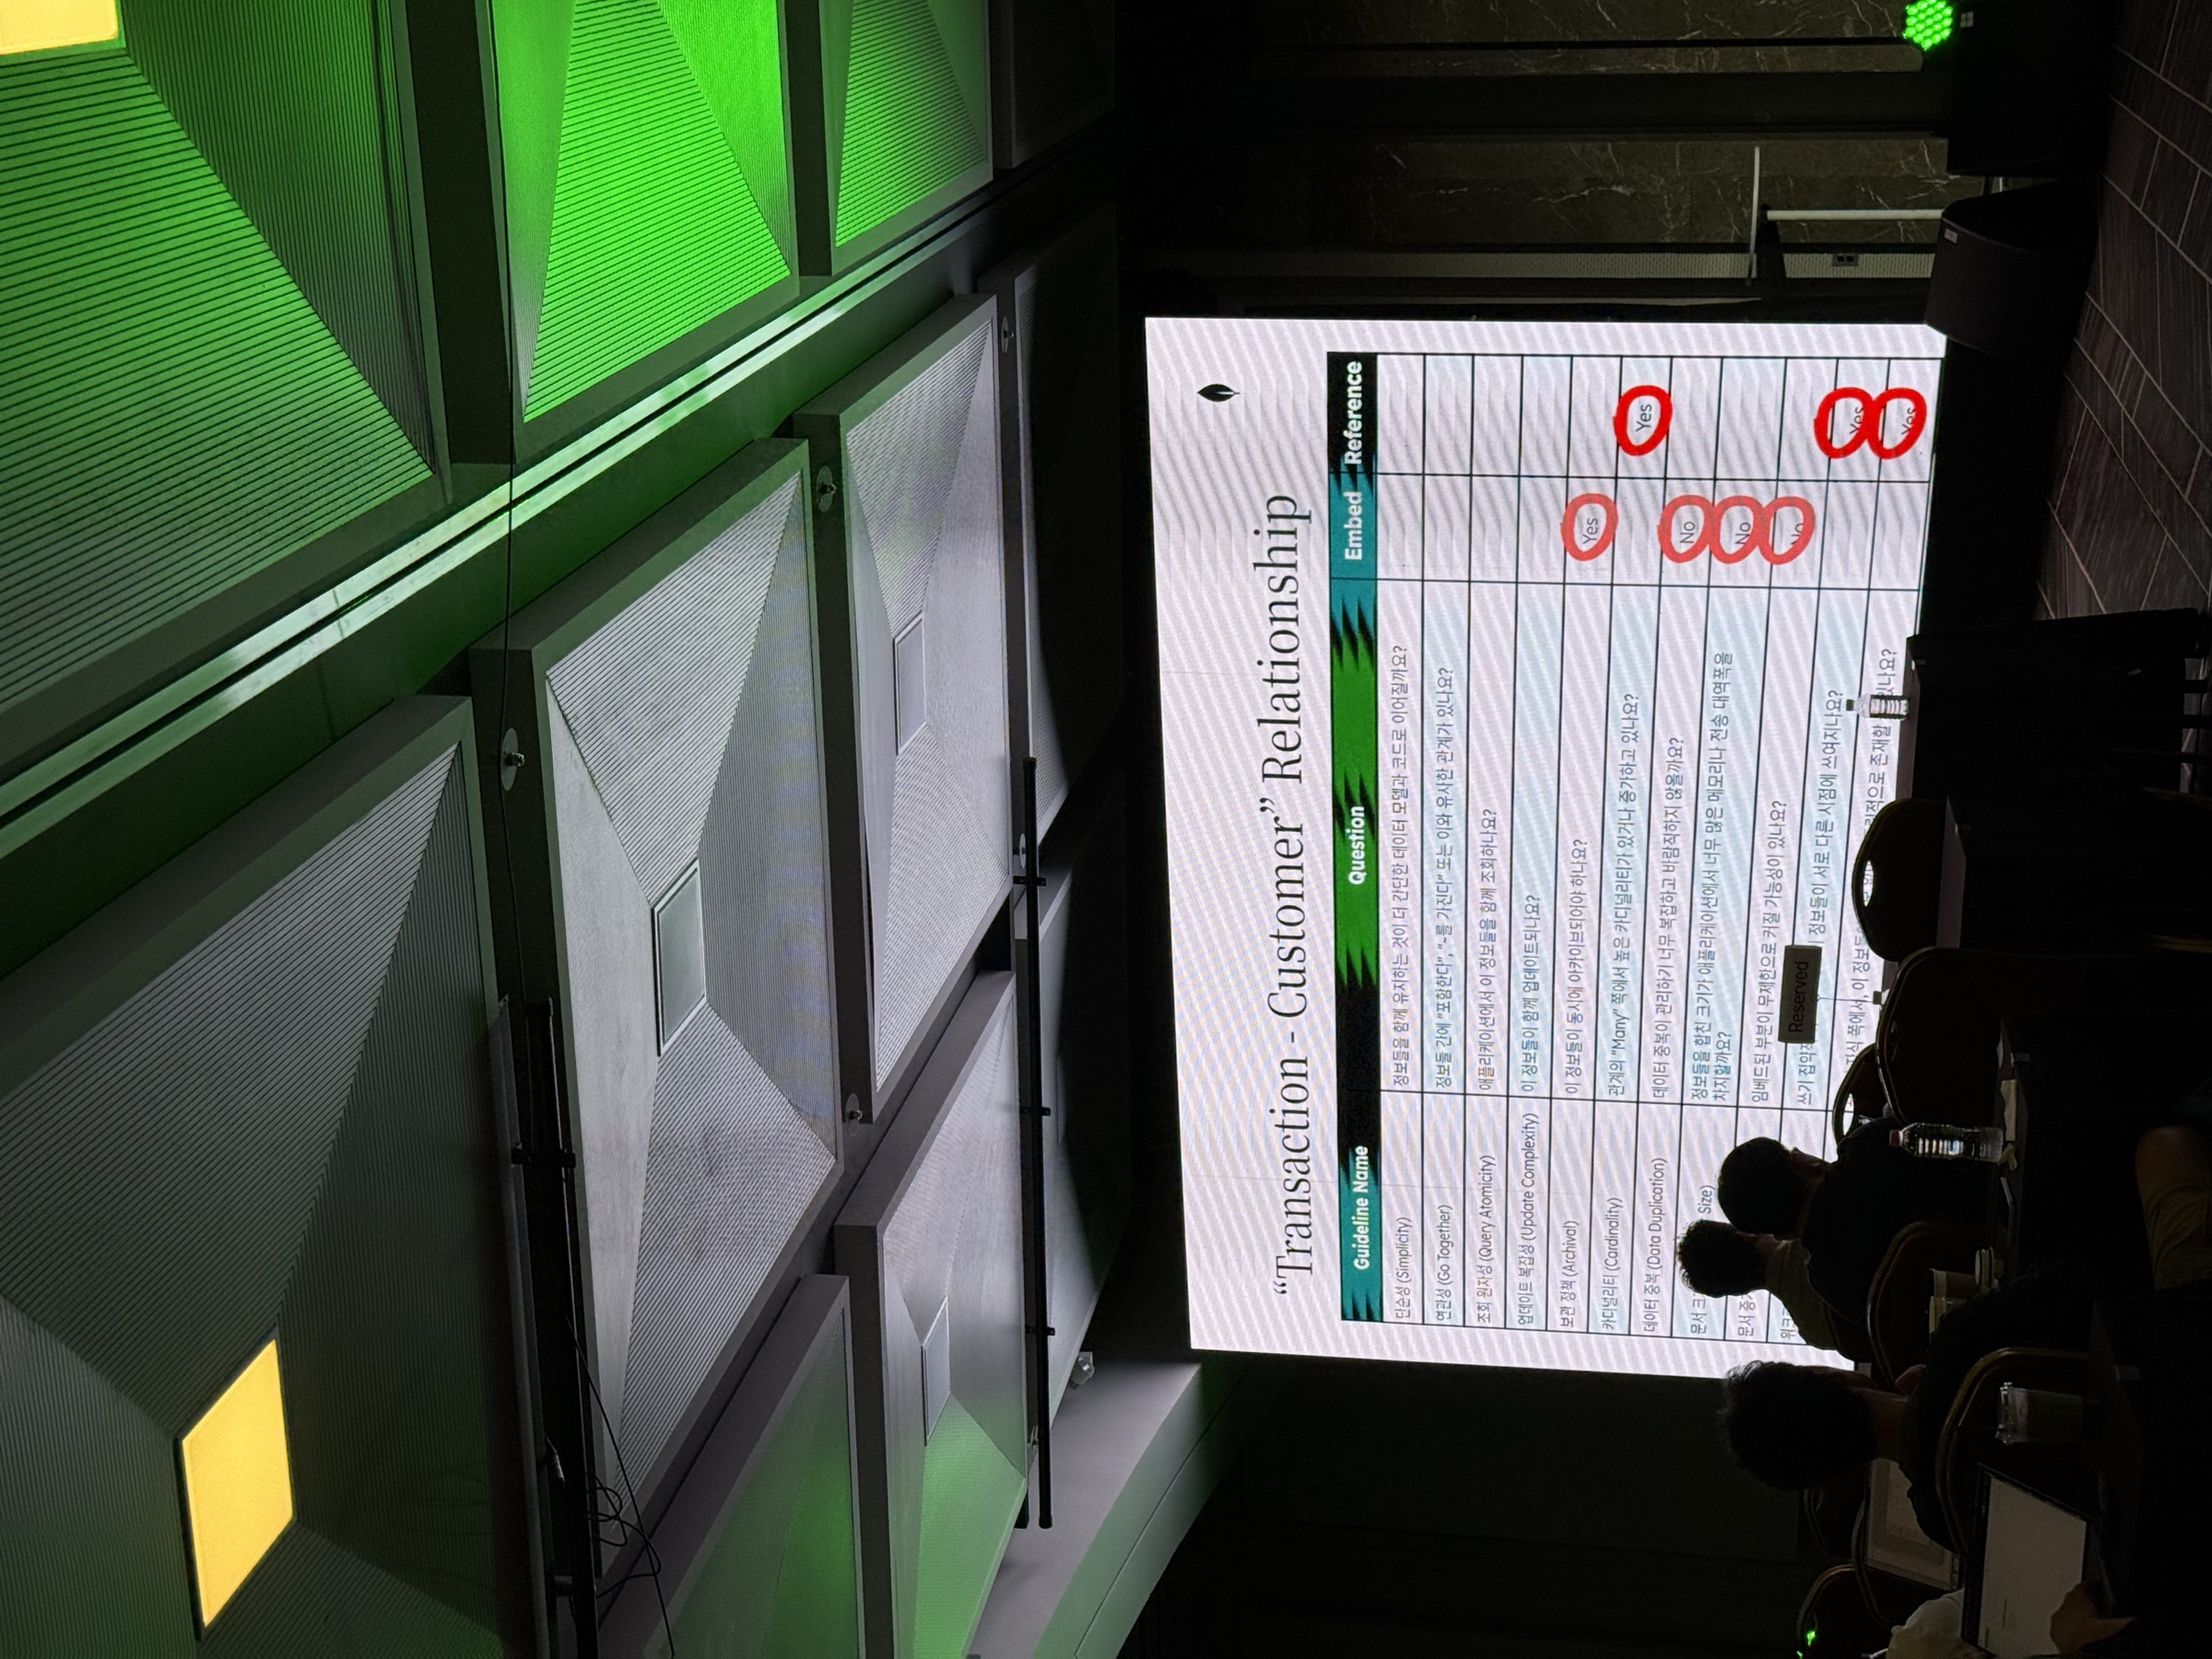
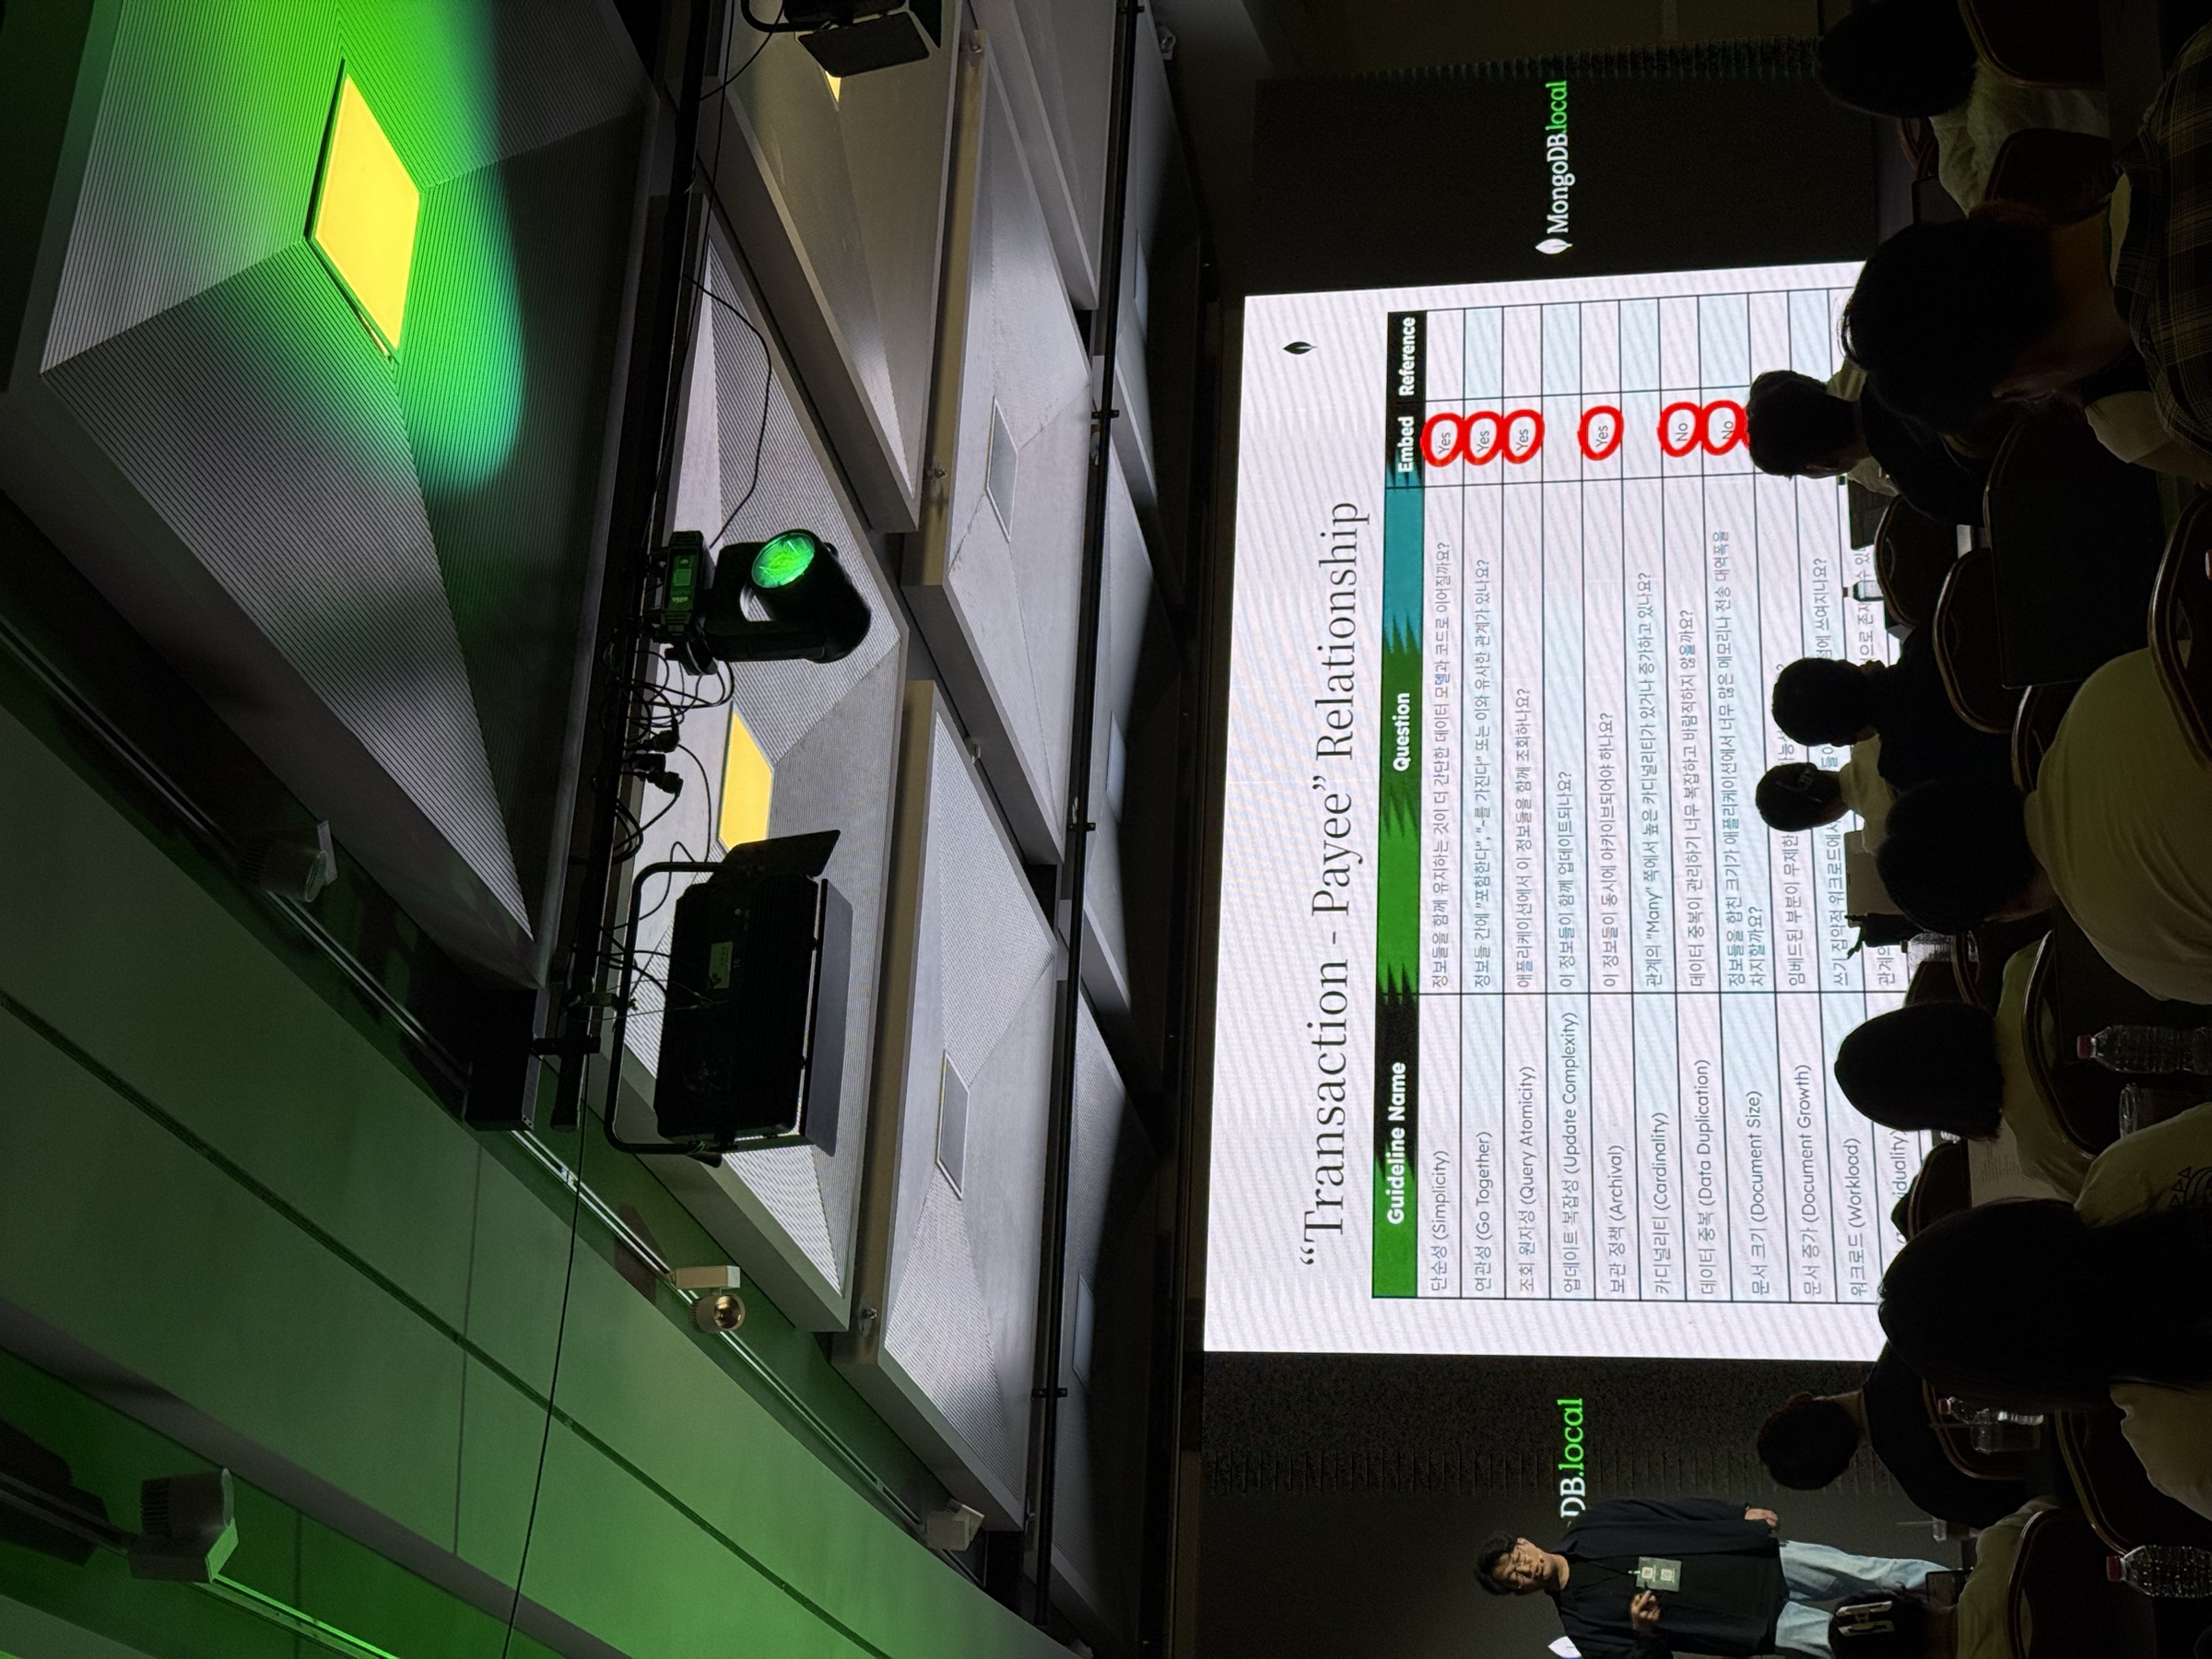
2. 데이터의 규모와 성장성
데이터의 크기와 앞으로 어떻게 변할지를 예측한다.
- 카디널리티 (Cardinality): 1:N 관계에서 ’N’에 해당하는 데이터의 수가 매우 많거나(1:Tons), 무제한으로 증가하는가? → (예: 하나의 상품과 수만 개의 리뷰). 이 경우 레퍼런싱이 거의 항상 올바른 선택이다.
- 문서 크기 및 증가 (Document Size & Growth): 임베딩 시 문서의 크기가 16MB 제한에 가까워지는가? 또는, 문서의 특정 부분(예: 로그 배열)이 계속해서 커져 문서 전체의 성능에 영향을 미치는가? →이 또한 레퍼런싱을 고려해야 할 신호이다.
- 데이터 중복 (Data Duplication): 임베딩으로 인해 수정이 번거로운 데이터 중복이 과도하게 발생하는가?
3. 데이터 관리 및 정책
데이터의 생명주기나 비즈니스 규칙을 고려한다.
- 보관 정책 (Archival): 데이터가 시간이 지남에 따라 접근 빈도가 달라지며, 특정 시점 이후에는 아카이브(보관)되어야 하는가?
- 쓰기 워크로드 (Write Workload): 읽기보다 쓰기가 훨씬 더 빈번한가? 임베딩된 문서가 커지면 쓰기 작업 시 더 많은 리소스를 사용하므로, 쓰기 집약적인 환경에서는 작은 문서를 유지하는 레퍼ენ싱이 유리할 수 있다.
4. 판단기준 최적화
효과적인 스키마 설계를 위한다면 아래 질문들을 통해 워크로드와 데이터의 특성을 파악할 수 있을 것이다.
- 관계 및 접근: 데이터들이 논리적으로 강하게 연결되어 있으며, 항상 함께 조회되는가? (→ 임베딩 고려)
- 규모 및 성장: 1:N 관계에서 N의 수가 매우 많거나(1:Tons) 무한히 증가하는가? (→ 레퍼런싱 고려)
- 독립성 및 중복: 데이터가 독립적으로 관리되어야 하거나, 임베딩 시 데이터 중복이 과도하게 발생하는가? (→ 레퍼런싱 고려)
- 데이터 생명주기: 데이터의 접근 빈도가 시간에 따라 변하며, 별도의 보관 정책이 필요한가? (→ 고급 패턴 고려)
스키마 설계의 판단 기준: 언제 임베딩하고 언제 레퍼런싱할까?
따라서 위의 질문들을 통해 워크로드와 데이터의 특성을 파악하고 최적의 패턴을 선택할 수 있다.
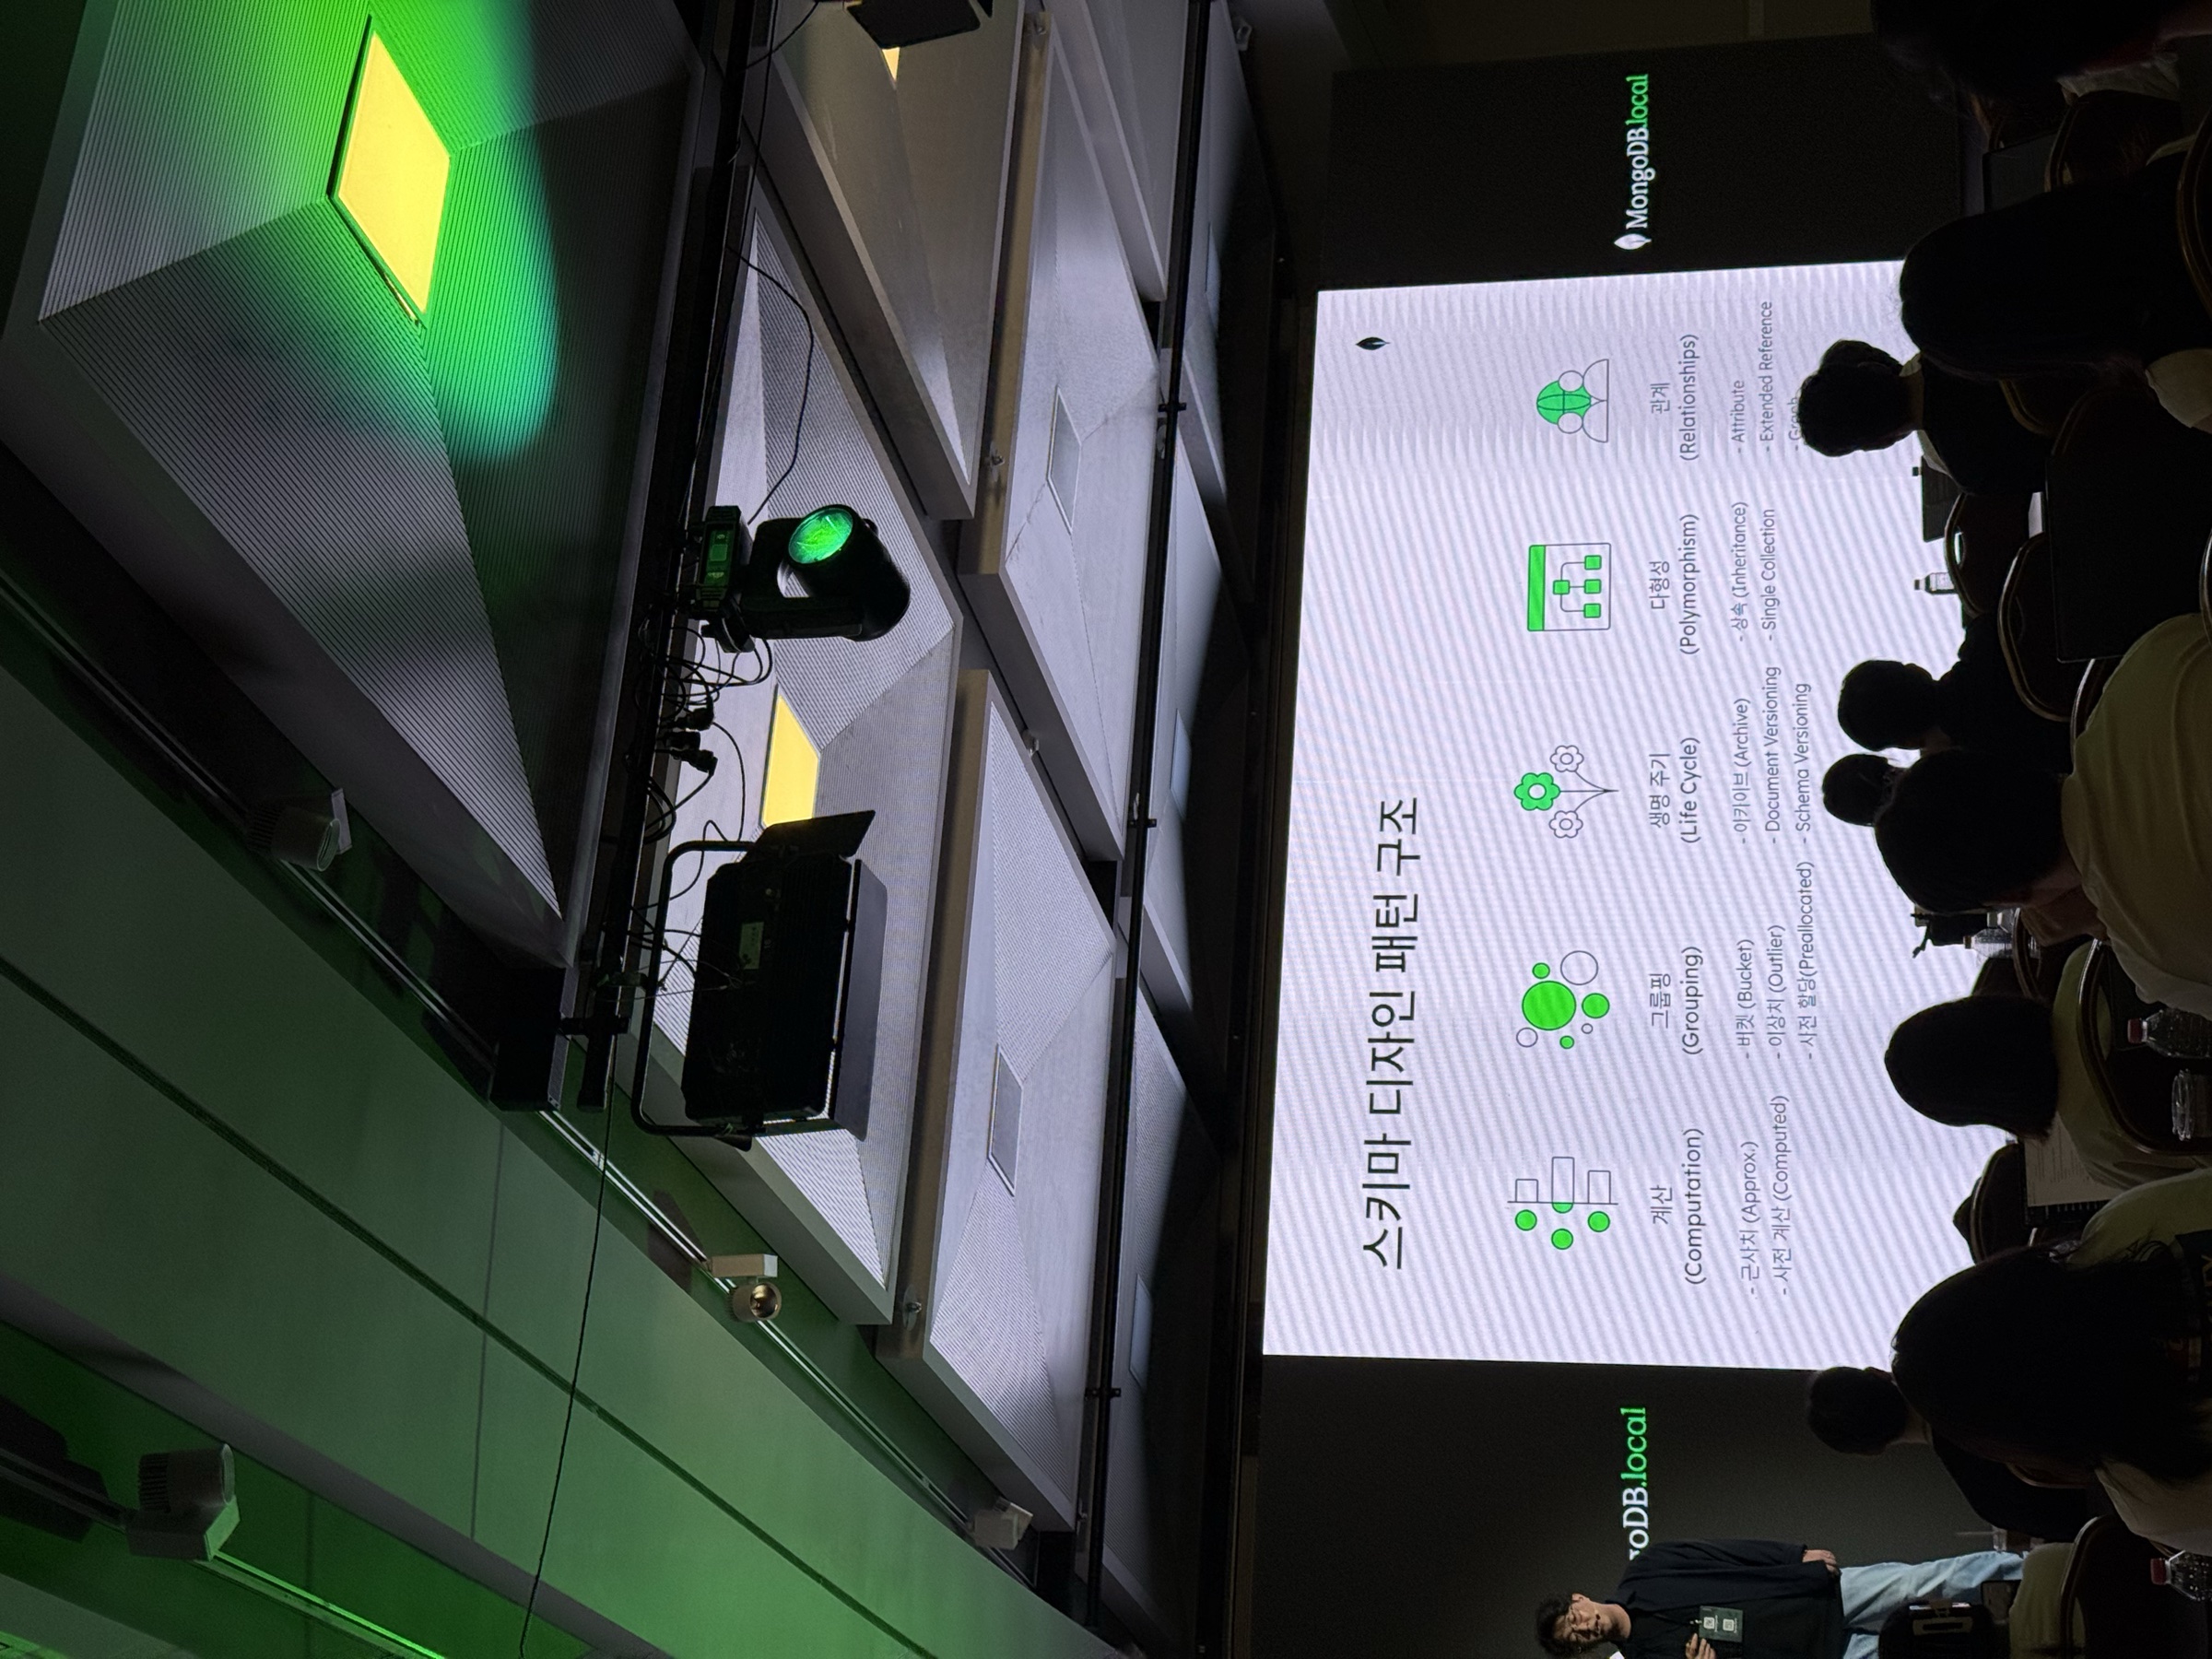
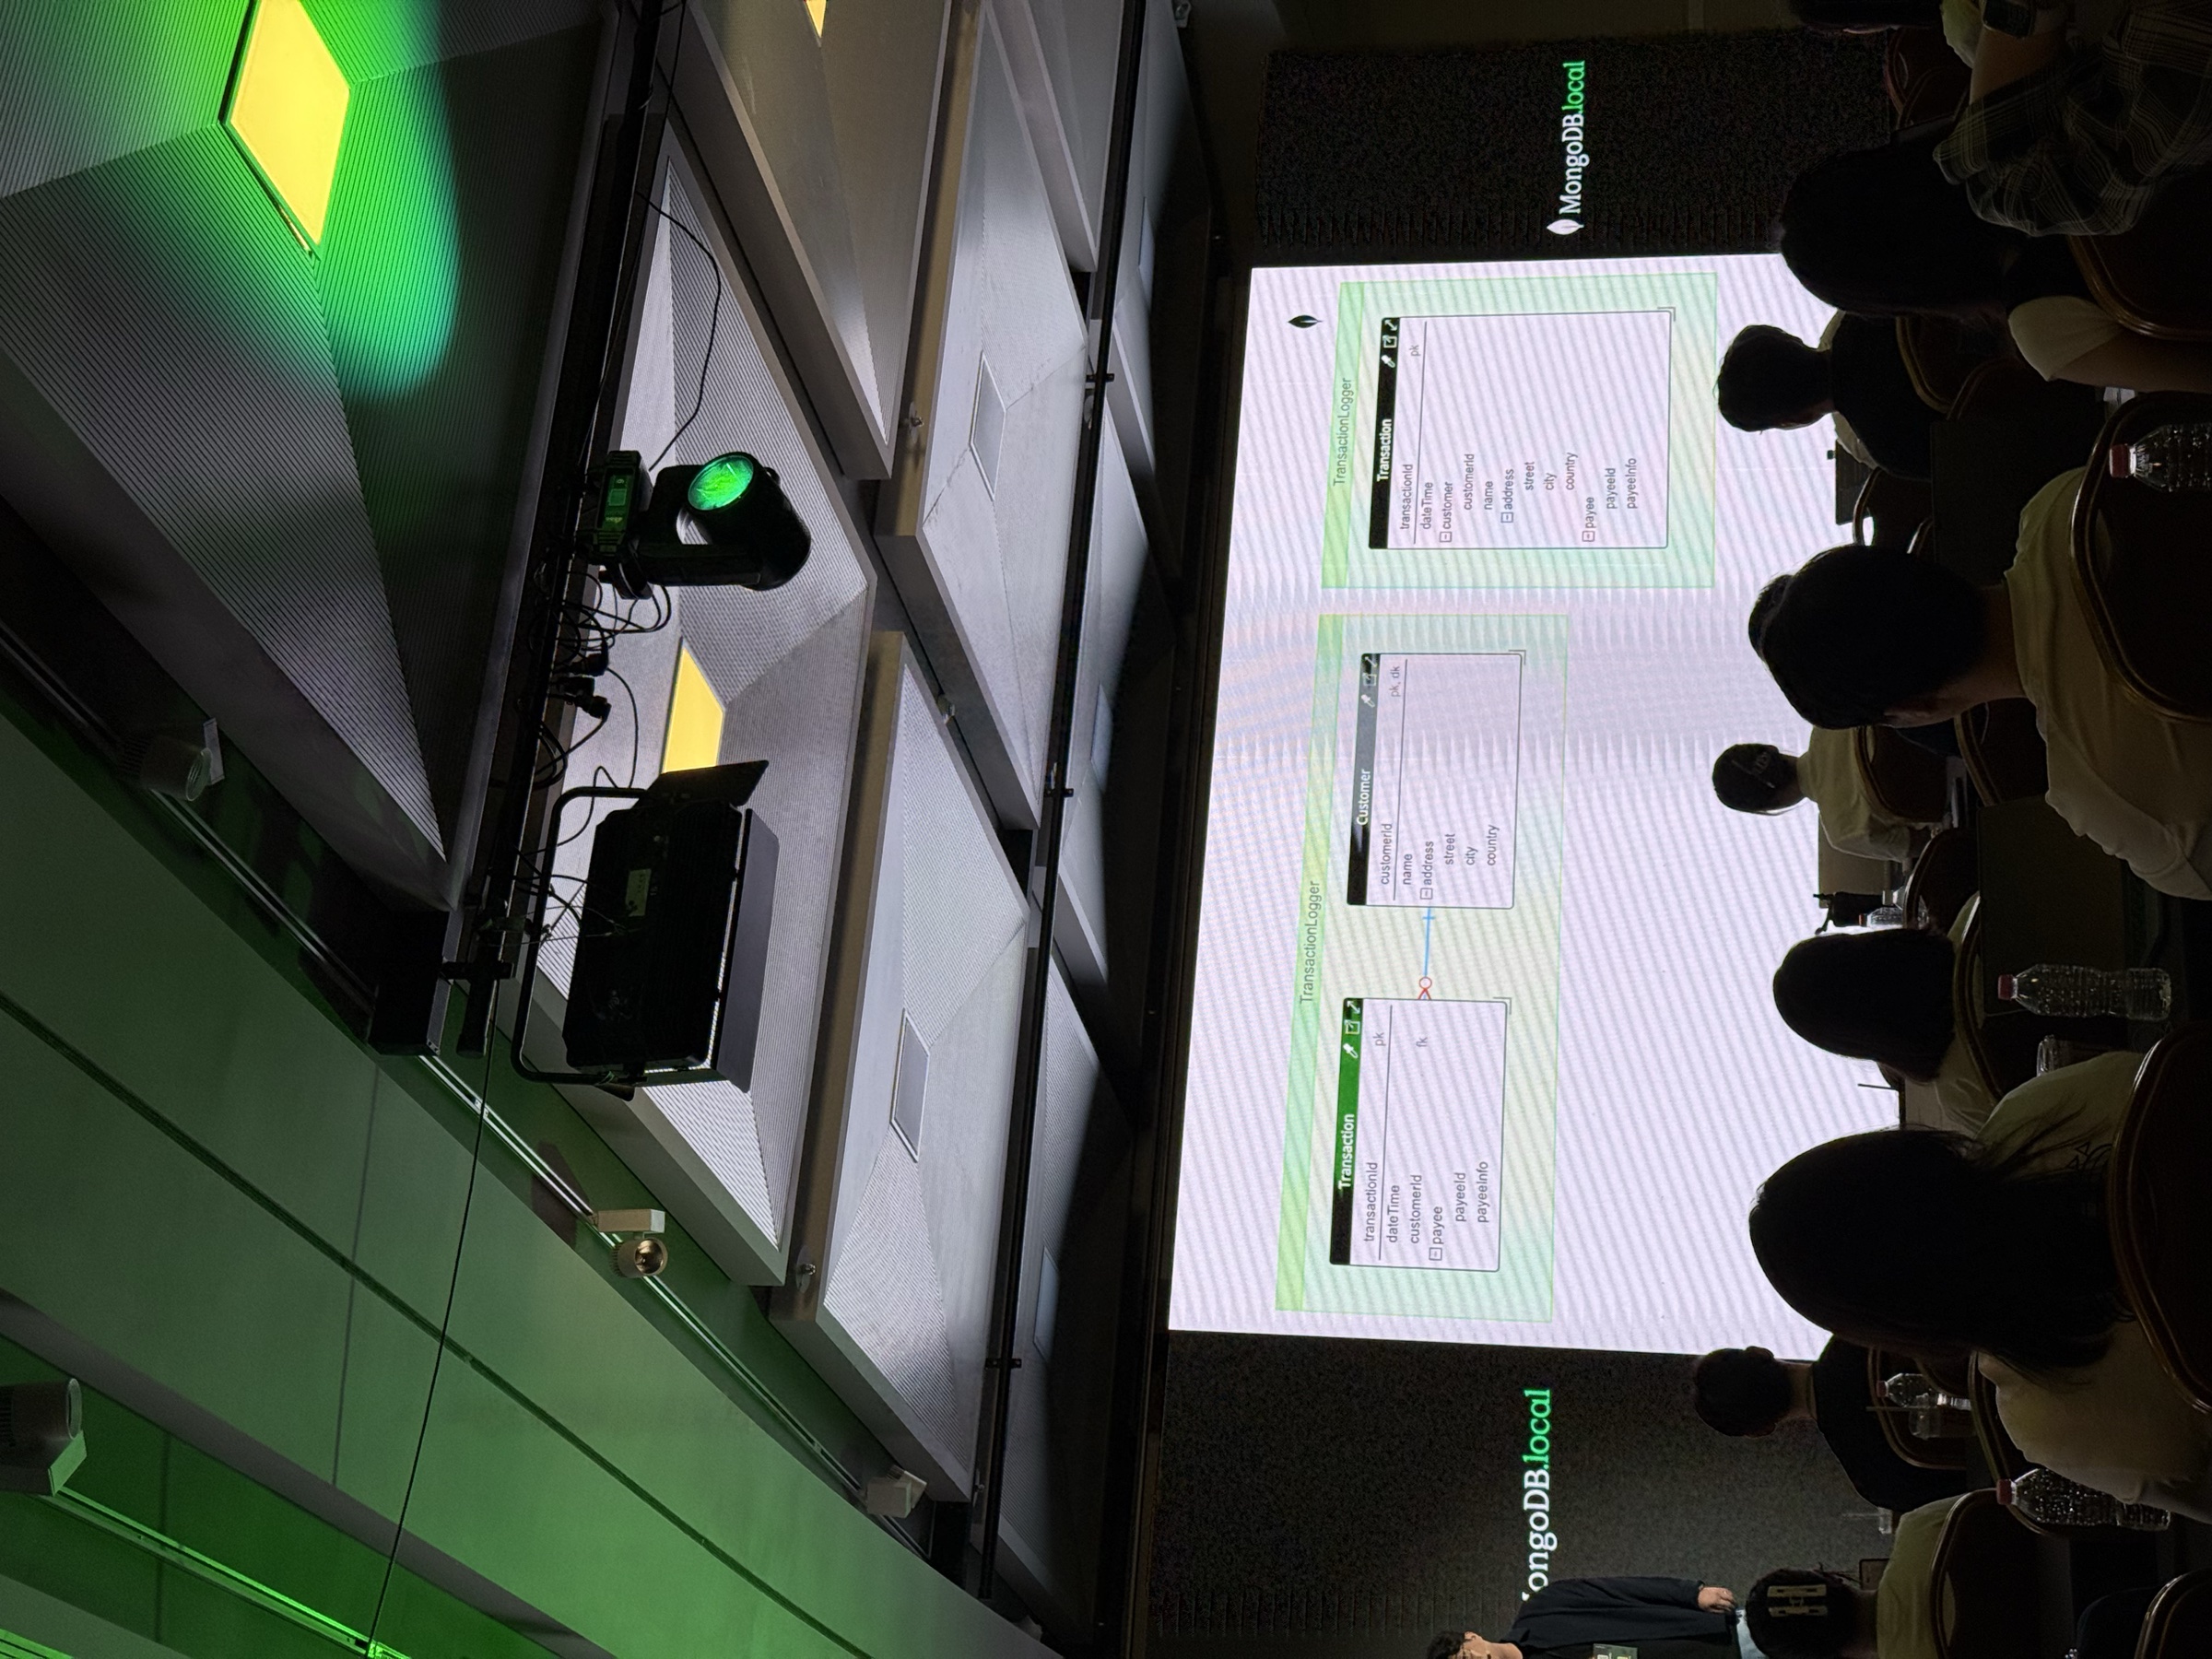
임베딩(Embedding)을 고려해야 하는 경우
데이터를 하나의 문서 안에 포함시키는 방식으로, 데이터 간의 관계가 명확하고 함께 사용될 때 적합하다.
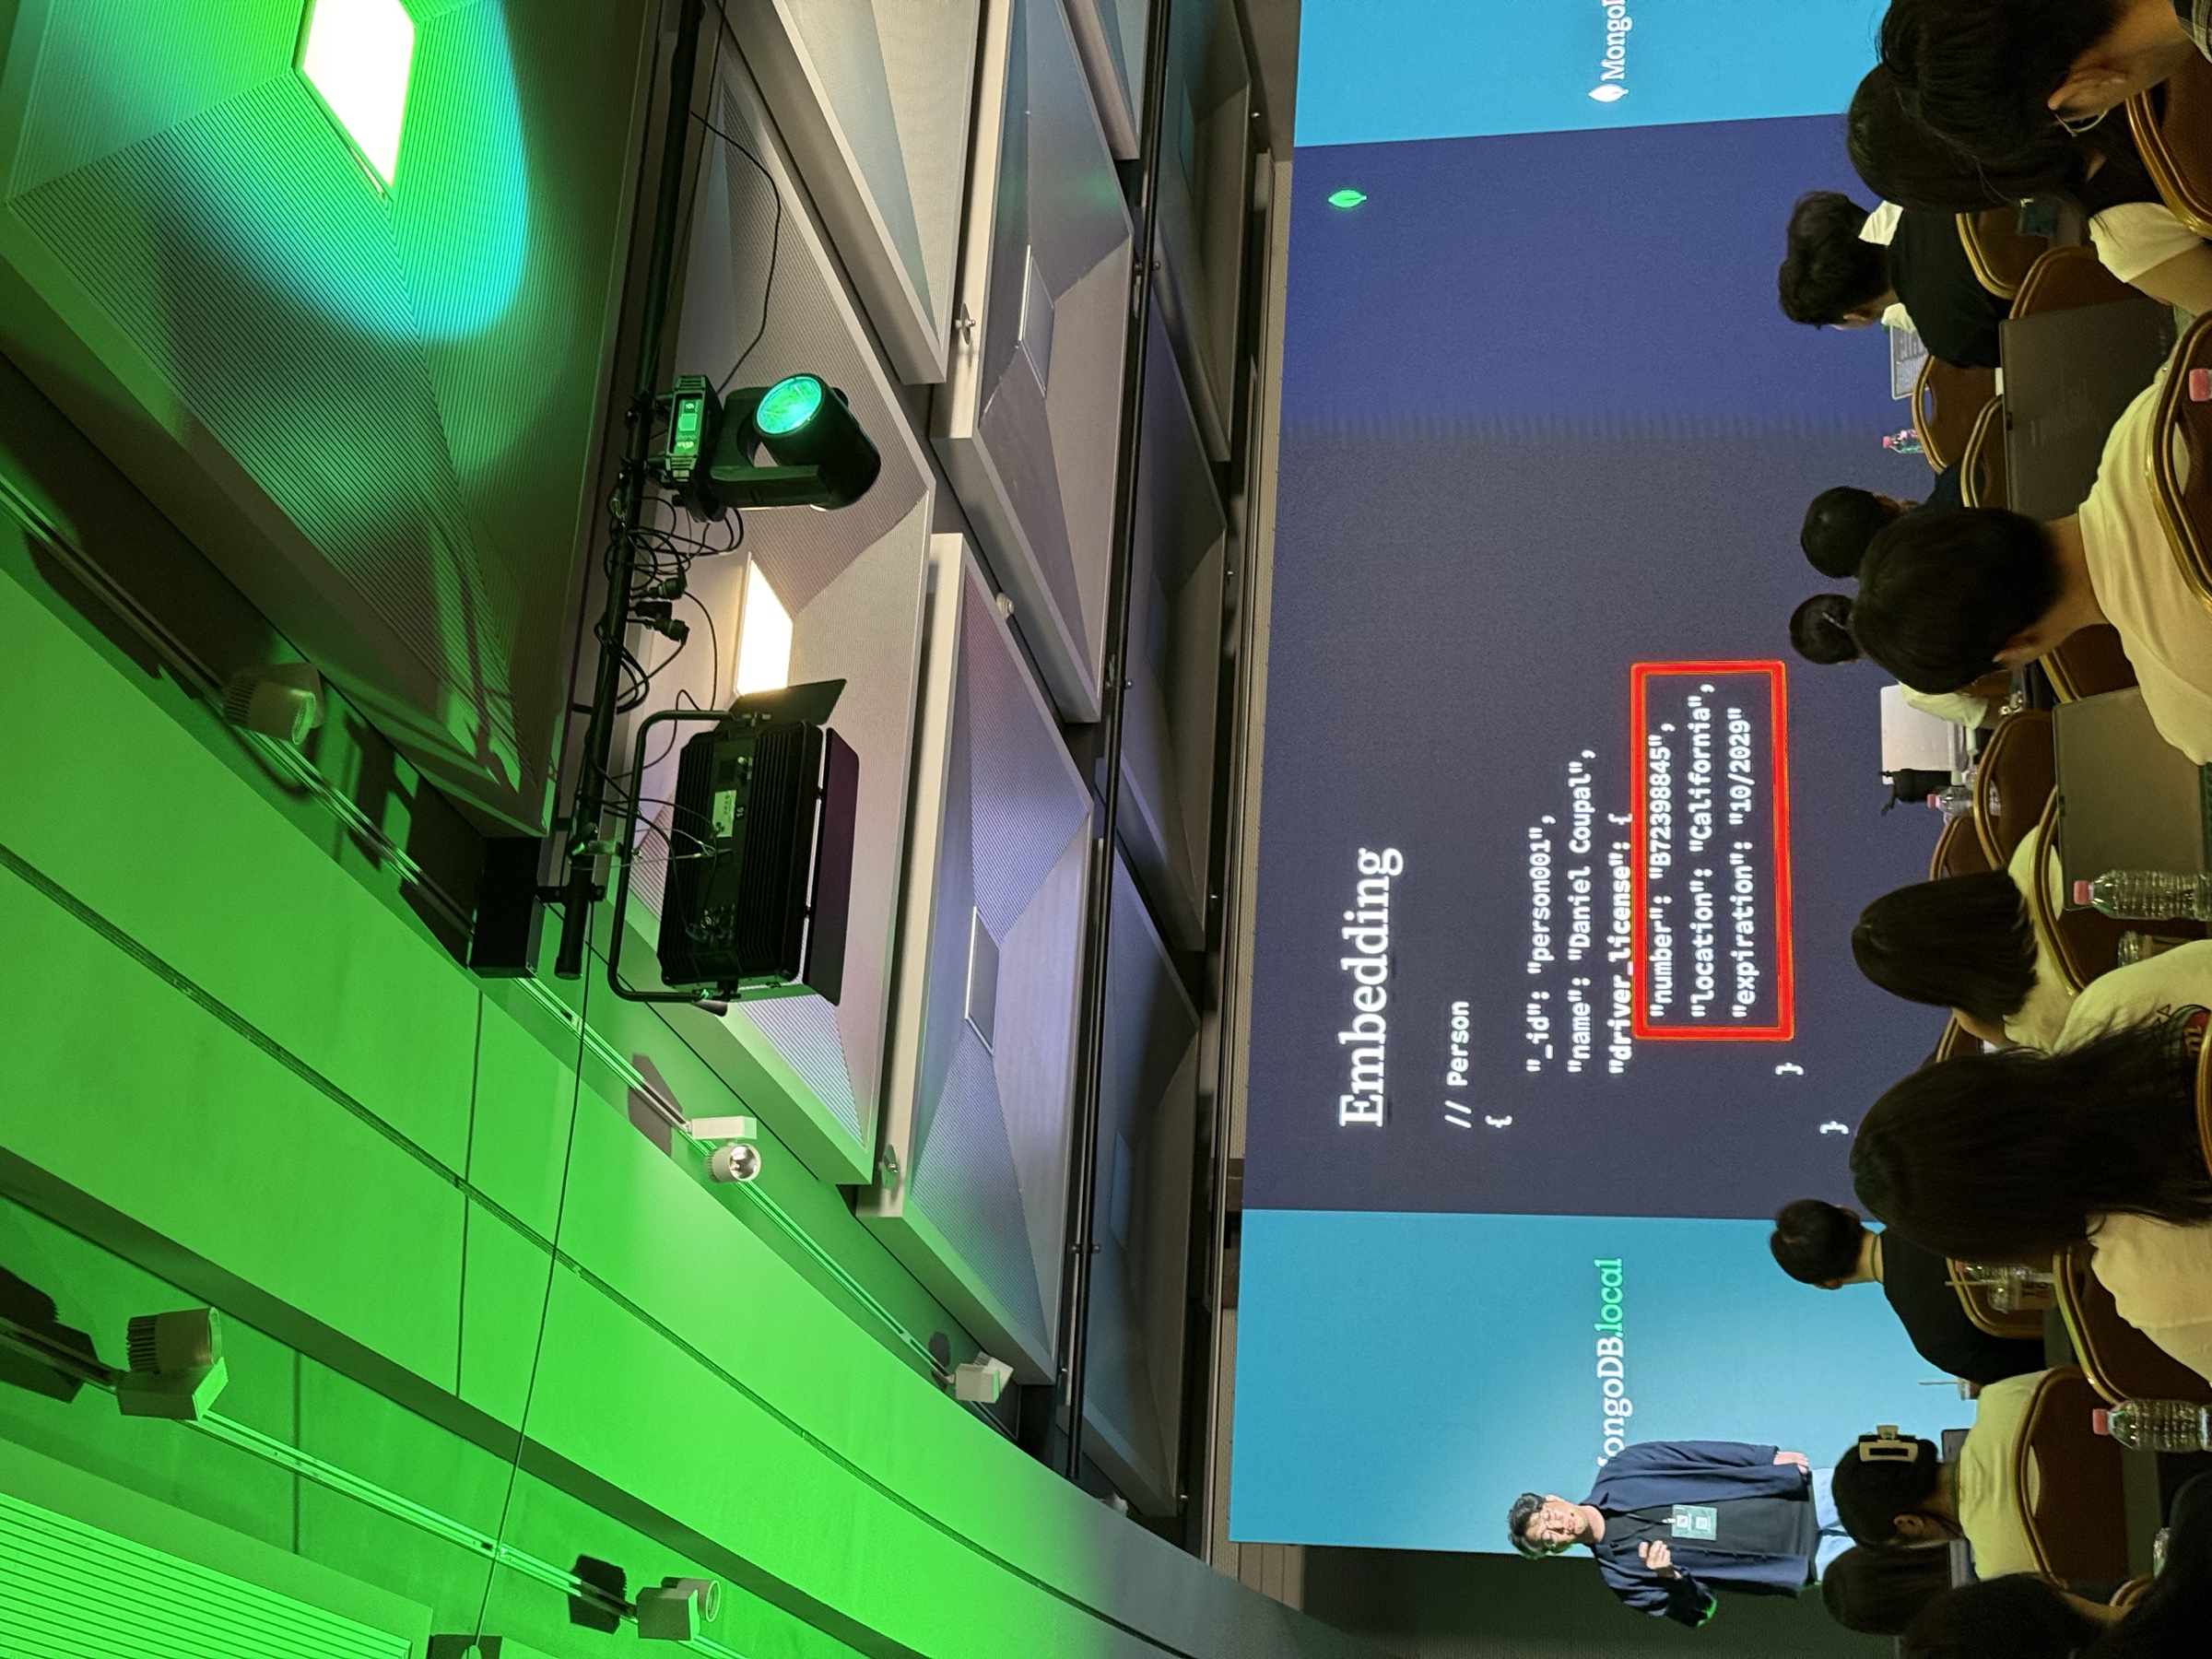
- 연관성 및 조회 원자성: 데이터들이 “포함한다” 또는 “갖는다” 와 같은 1:Few(일대소) 관계이며, 애플리케이션에서 항상 함께 조회되는가? (예: 블로그 게시물과 그에 달린 댓글들)
- 단순성: 데이터를 함께 두는 것이 코드와 데이터 모델을 더 단순하게 만드는가?
- 업데이트: 관련된 데이터들이 함께 업데이트되는 경우가 많은가?
TypeScript
레퍼런싱(Referencing)을 고려해야 하는 경우
문서에 데이터 전체가 아닌, 다른 문서의 ID값만 저장하여 연결하는 방식이다.
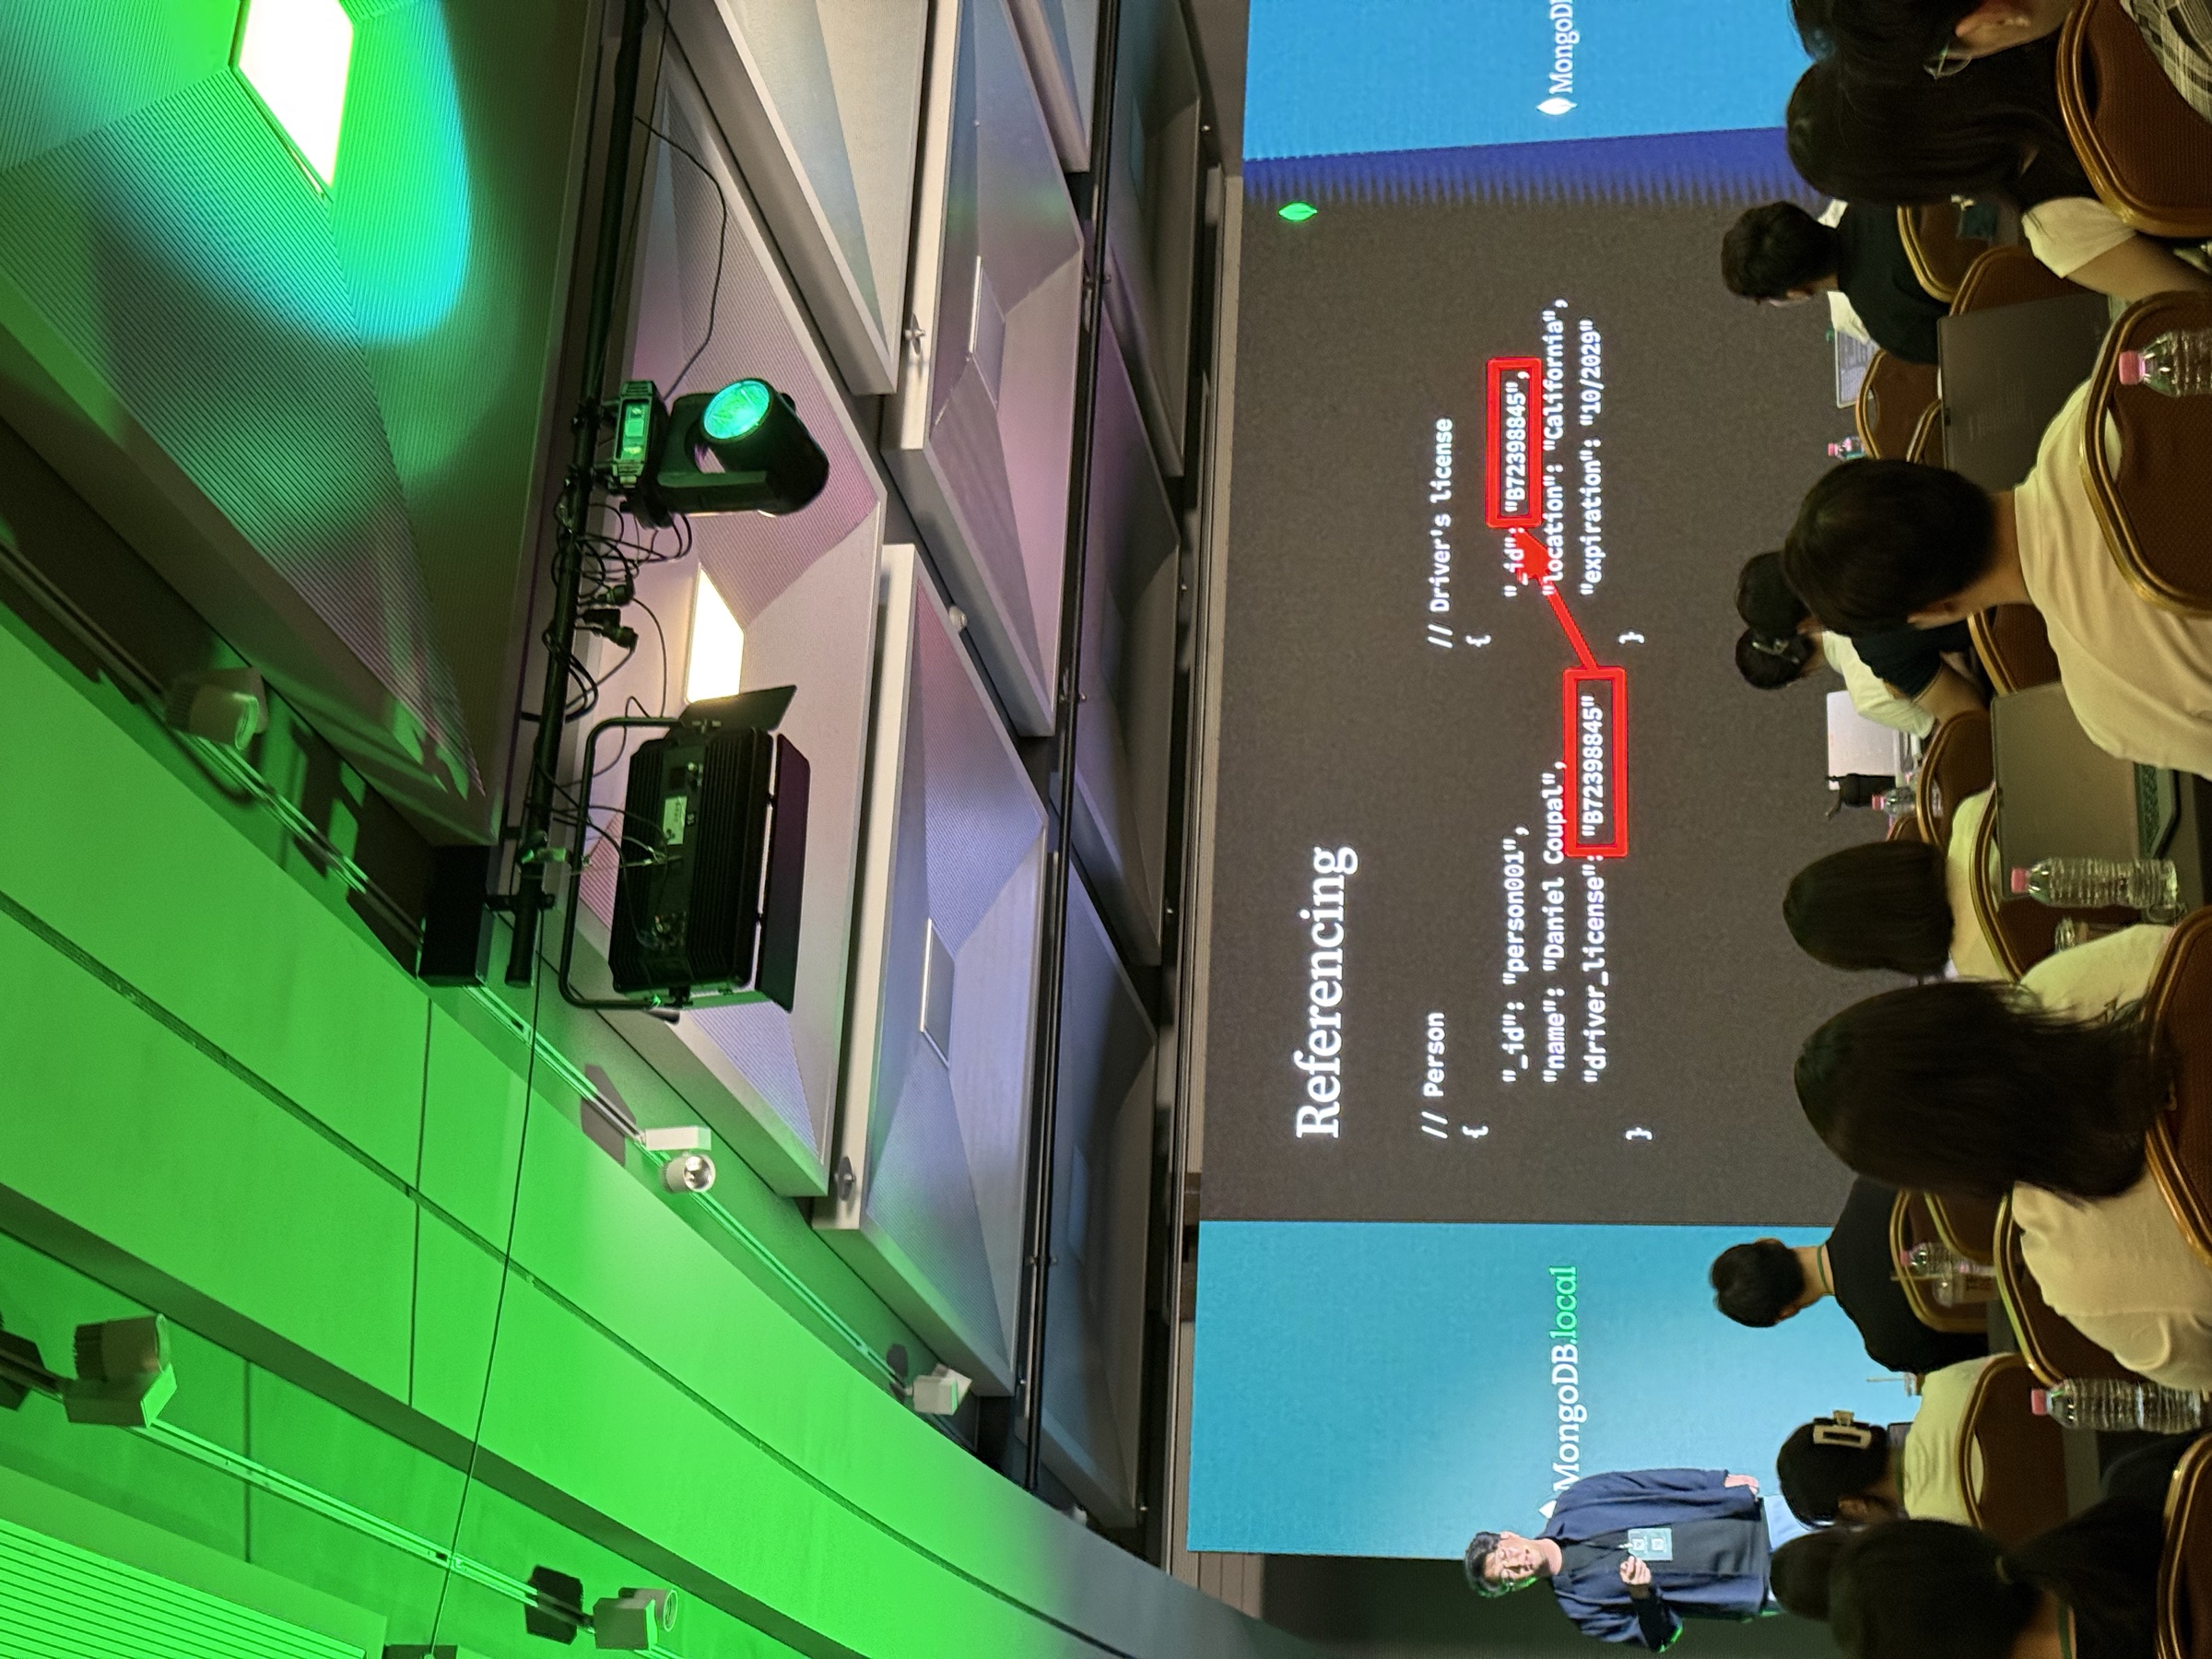
- 카디널리티: 1:Many(일대다) 관계에서 ‘다(Many)’ 쪽의 데이터 양이 매우 많거나, 무제한으로 증가할 가능성이 있는가? (예: 하나의 상품과 수천 개의 상품 리뷰)
- 문서 크기 및 증가: 임베딩 시 문서의 크기가 16MB 제한에 가까워지거나, 특정 하위 데이터가 계속해서 늘어나는가? (예: 사용자와 그의 전체 주문 내역)
- 독립성: 연결된 데이터가 그 자체로 독립적으로 자주 조회되거나 수정되는가? (예: 상품 정보와 공급업체 정보)
- 데이터 중복: 임베딩 시 관리하기 힘든 데이터 중복이 발생하는가?
TypeScript
그외의 패턴(하이브리드 패턴)
필요에 의해 임베딩과 래퍼런싱을 동시에 쓰는 방식이다.
TypeScript
워크로드에 따른 고급 스키마 패턴
워크로드 분석을 통해 기본적인 임베딩, 레퍼런싱, 하이브리드 패턴을 넘어 다음과 같은 고급 패턴들을 적용할 수 있다.
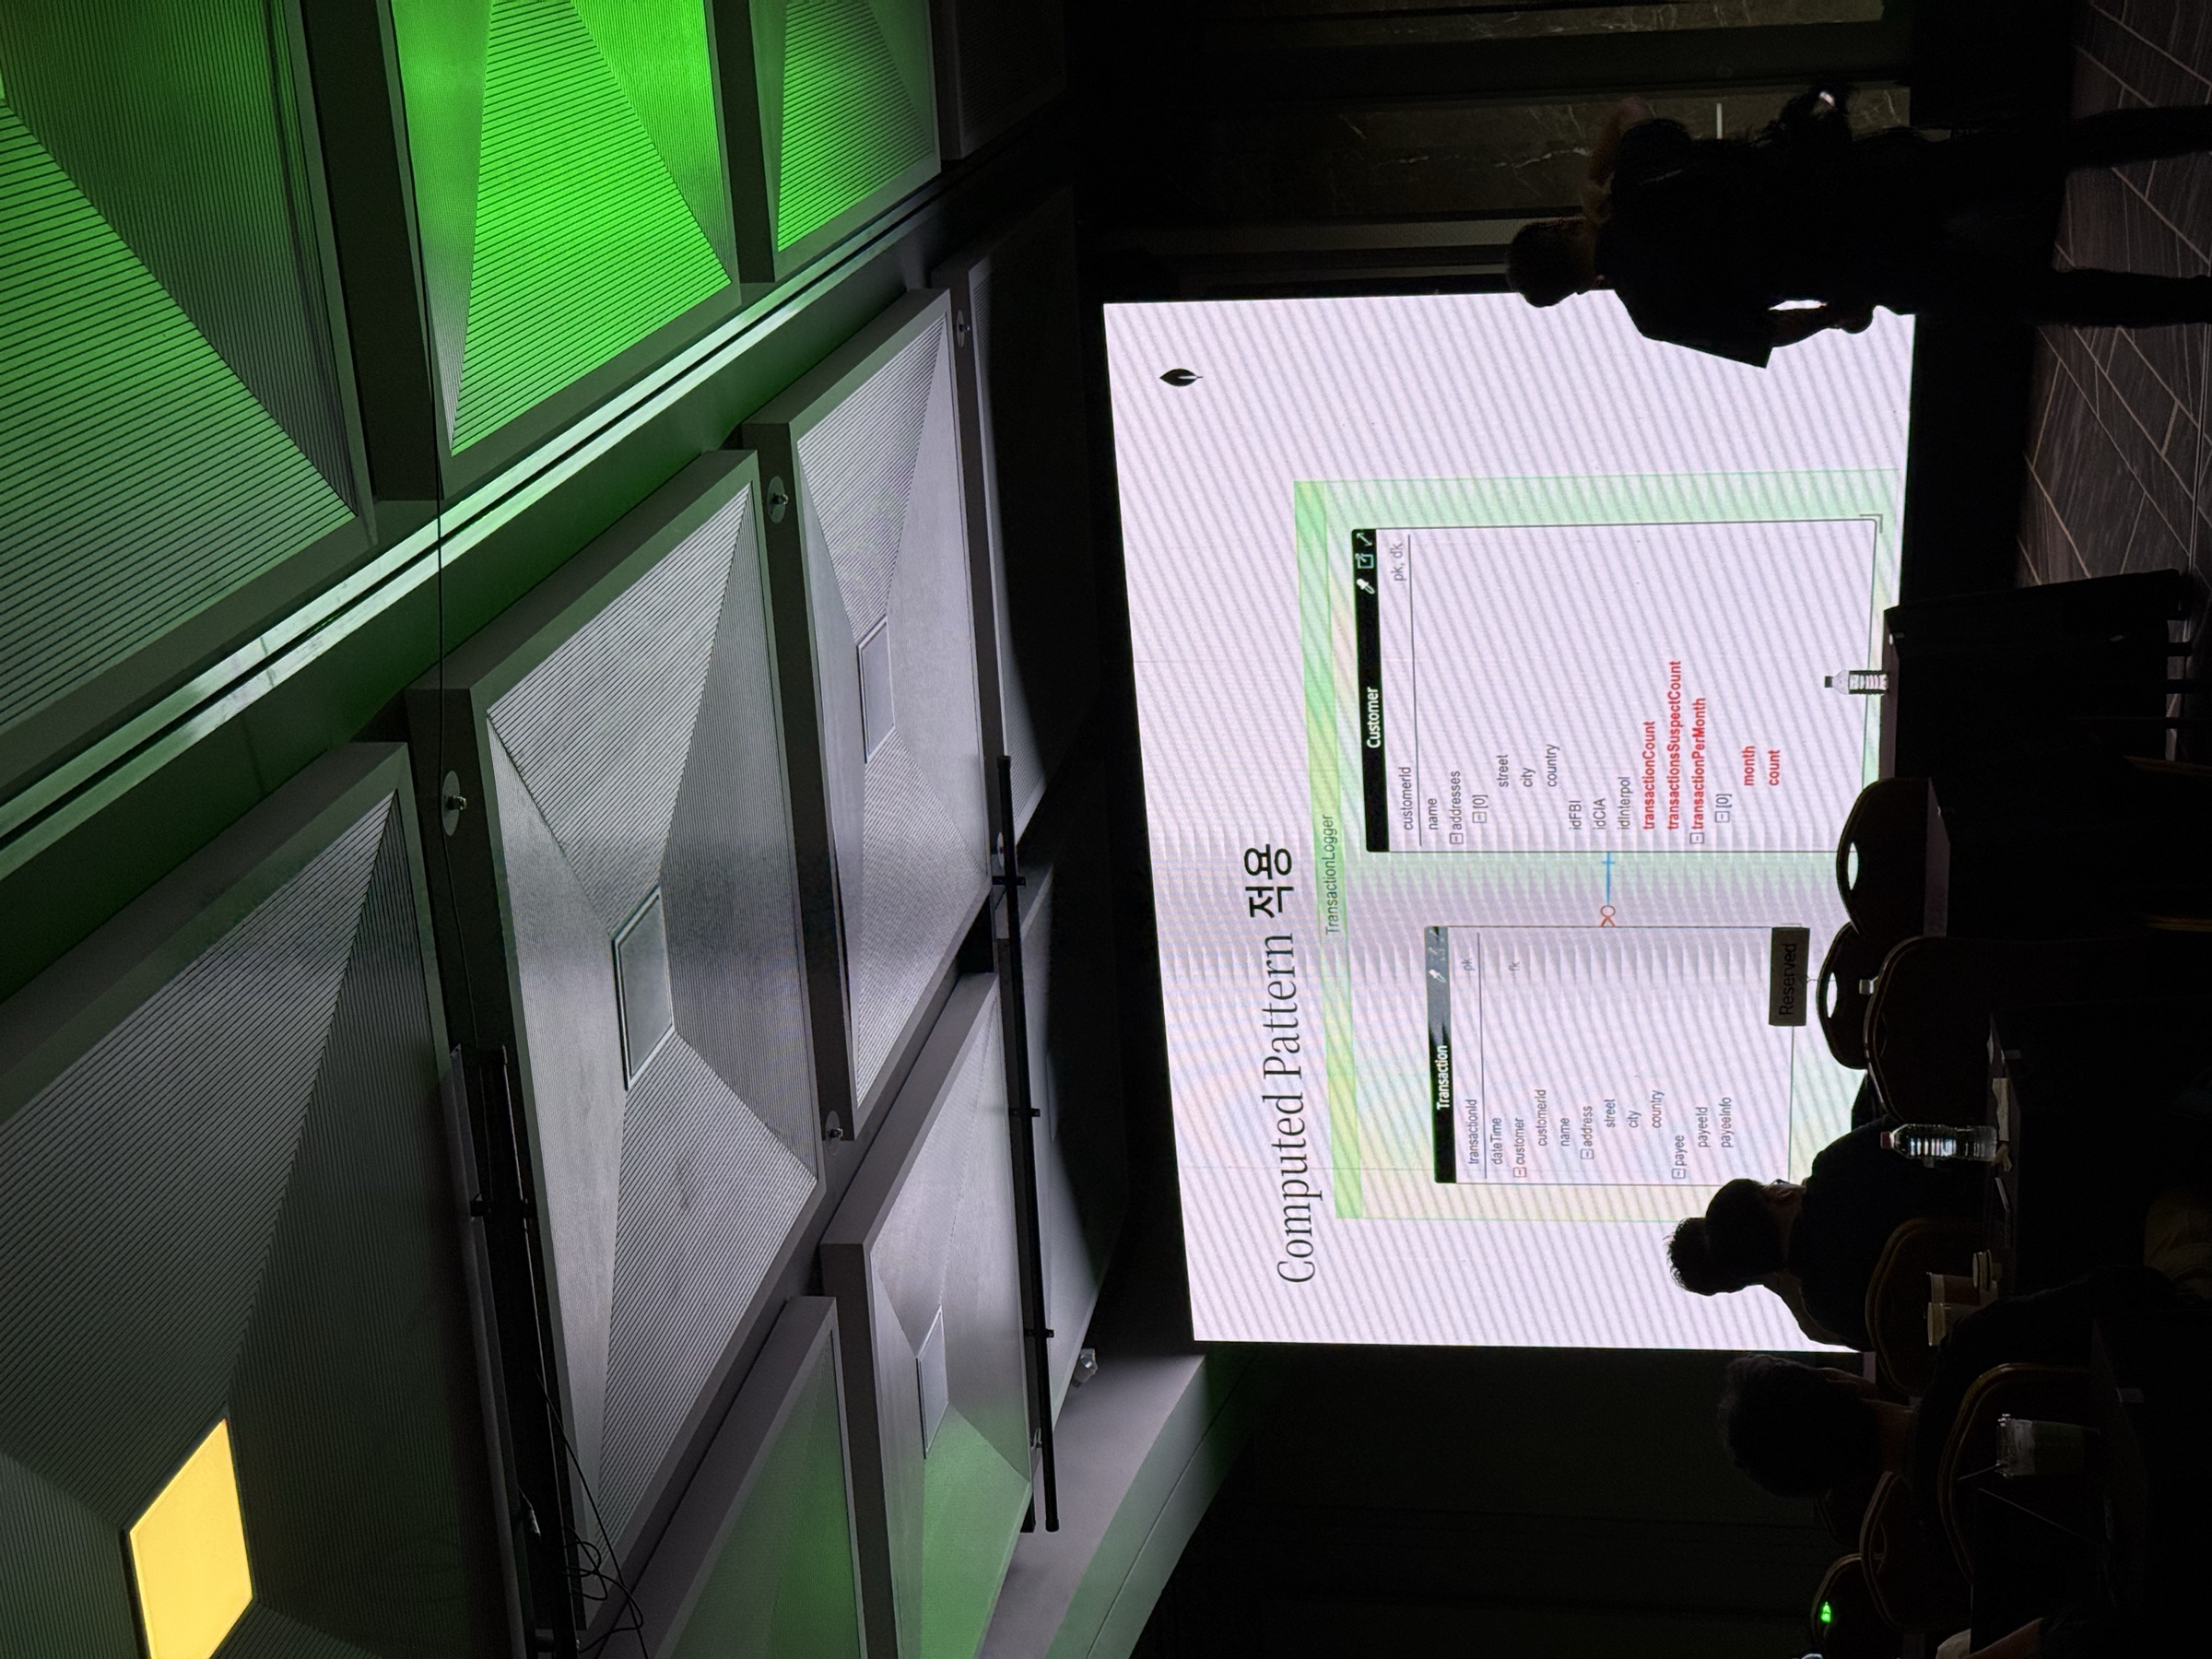
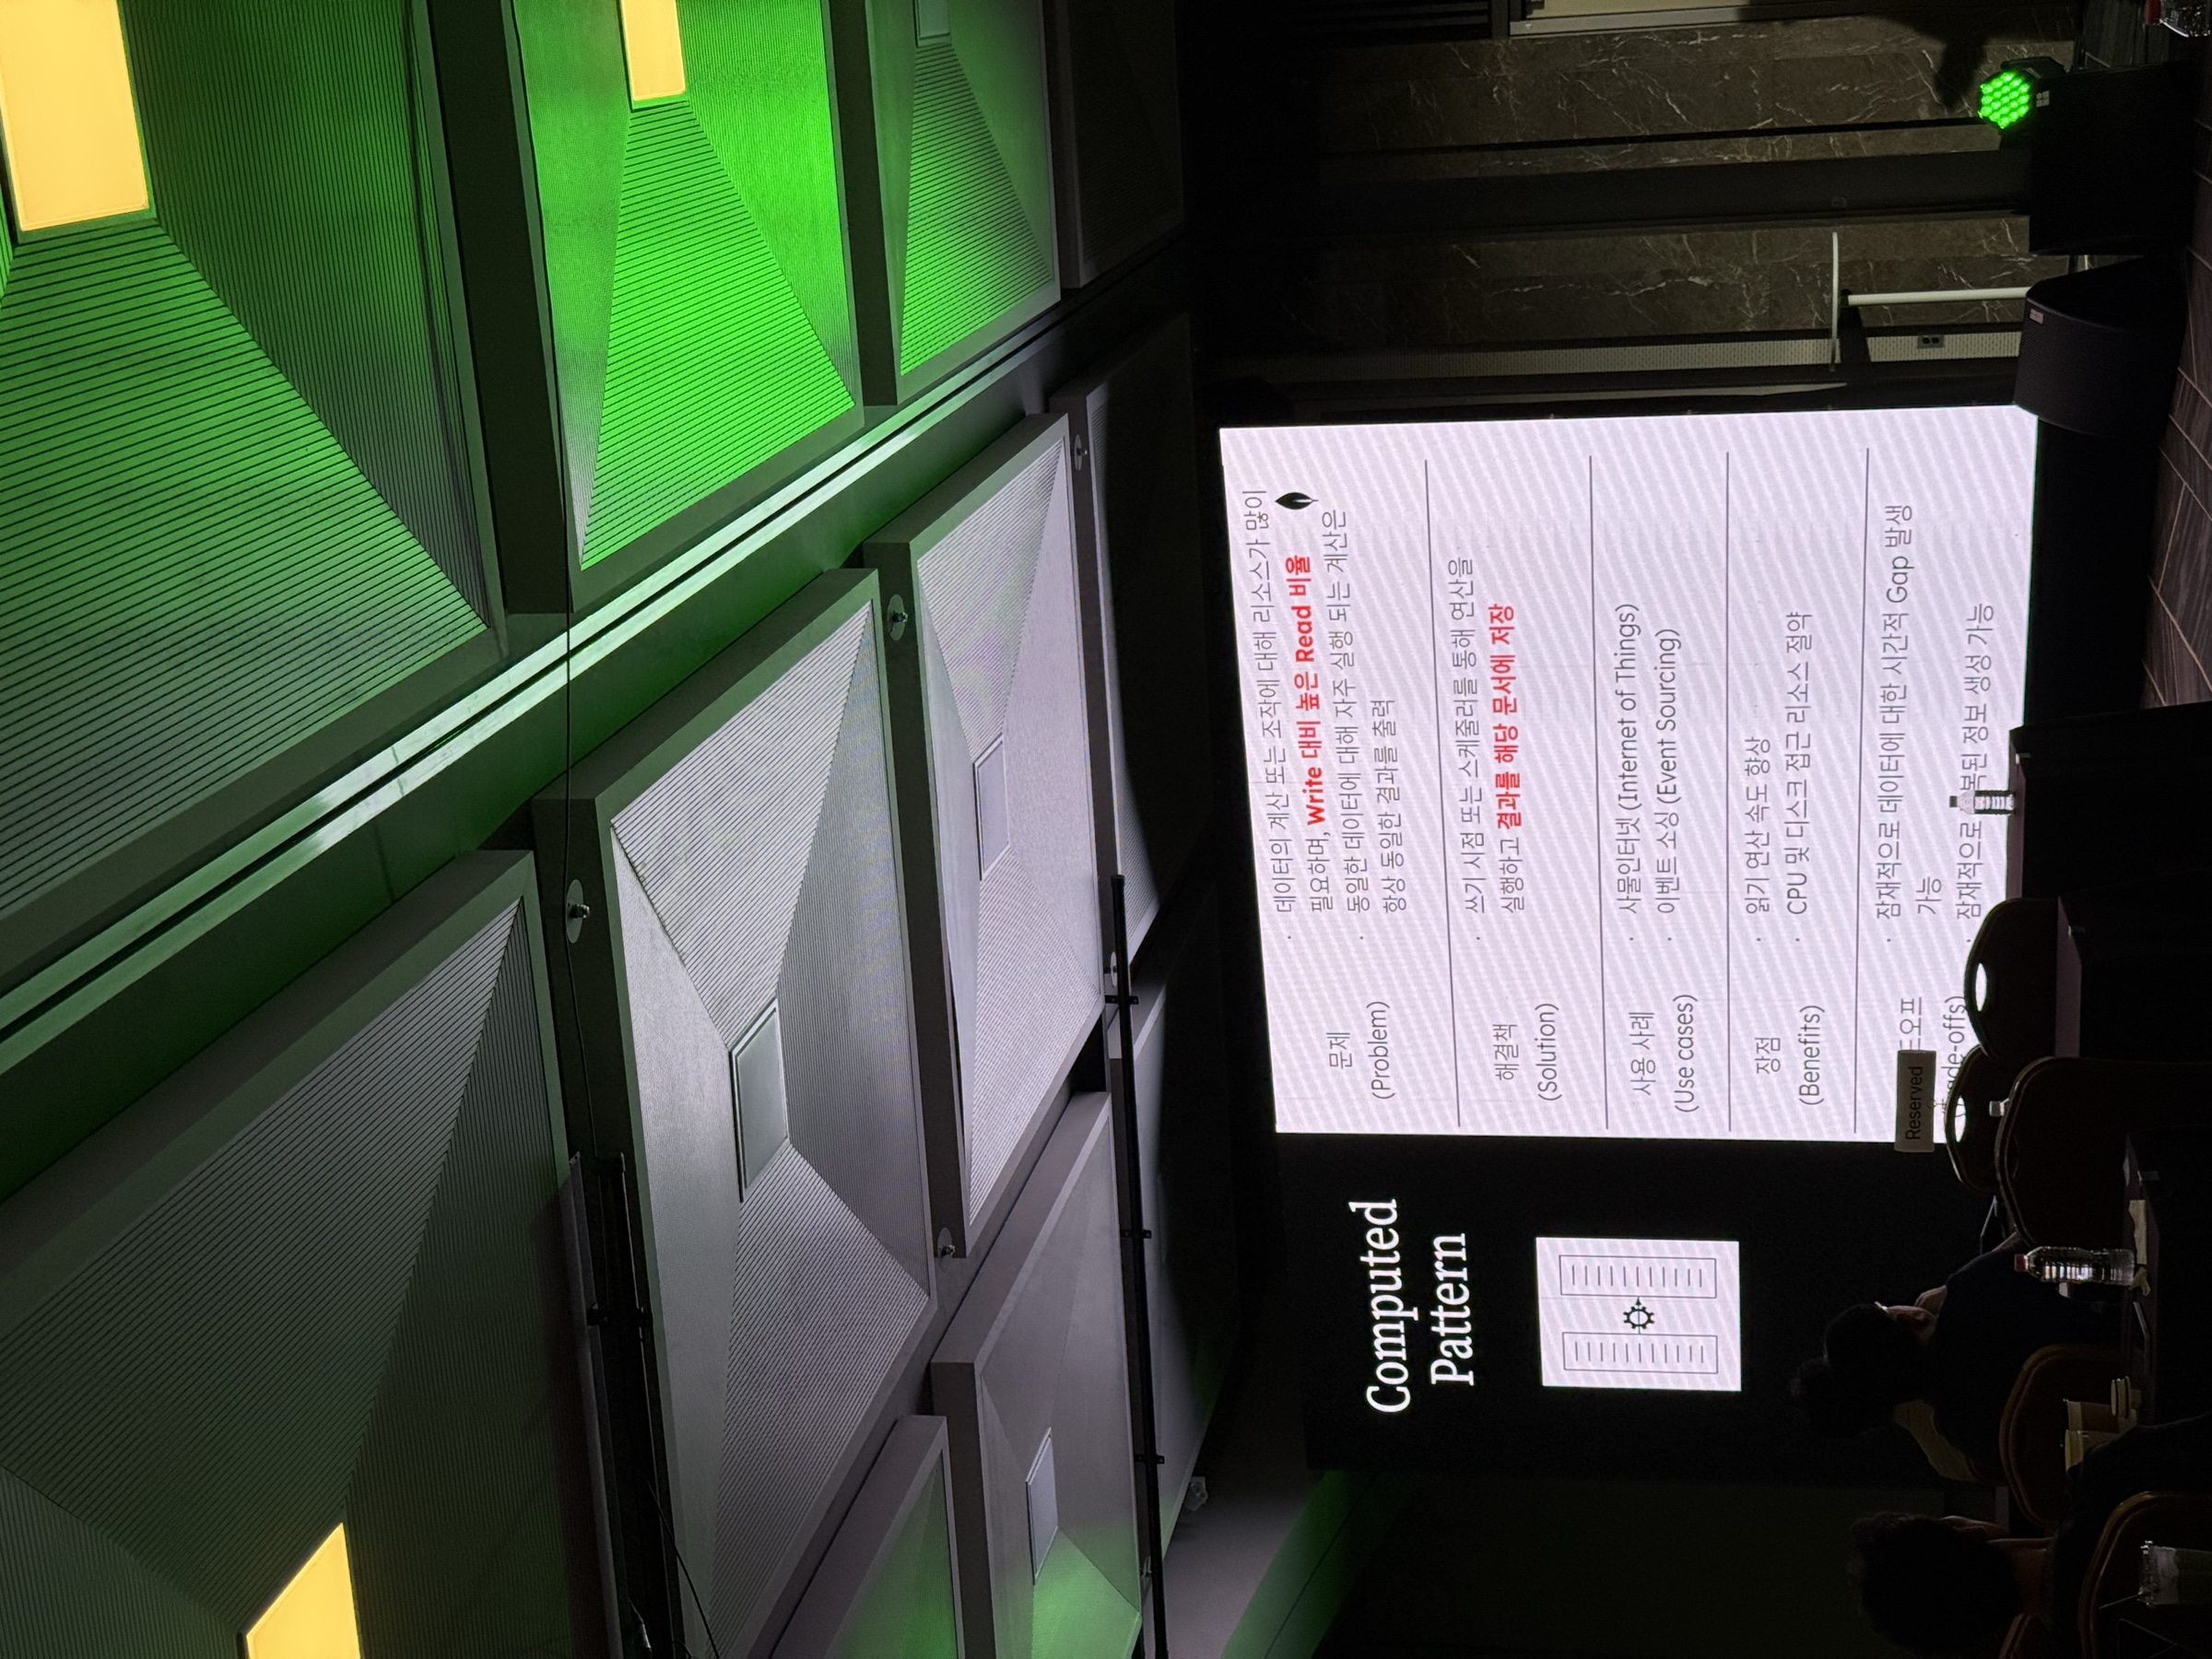
Computed Pattern (계산 패턴)
- 문제 (Problem) 읽기(Read) 작업이 쓰기(Write)에 비해 압도적으로 많고, 읽을 때마다 반복적이고 리소스 소모가 큰 계산이 필요한 경우이다. 예를 들어, 영화 평점 사이트에서 영화의 평균 평점을 매번 조회 시마다 모든 평점을 불러와 계산하는 상황이다.
- 해결책 (Solution) 데이터를 읽을 때 계산하는 것이 아니라, 데이터가 쓰여질 때 미리 연산을 실행하고 그 결과를 문서에 함께 저장한다. 평점이 새로 등록될 때마다 평균 평점을 미리 계산해서 영화 문서에 저장해두는 방식이다.
- 사용 사례: 사물인터넷(IoT) 센서 데이터의 주기적 통계 계산, 이벤트 소싱(Event Sourcing) 기반의 현재 상태 값 계산
- 장점: 읽기 연산 속도가 극적으로 향상되고, 조회 시 CPU 및 디스크 사용량이 절약된다.
- 트레이드오프: 데이터가 업데이트되는 시점과 계산 결과가 반영되는 시점 사이에 시간적 차이가 발생할 수 있으며, 원본 데이터와 계산된 결과 데이터가 중복으로 저장된다.
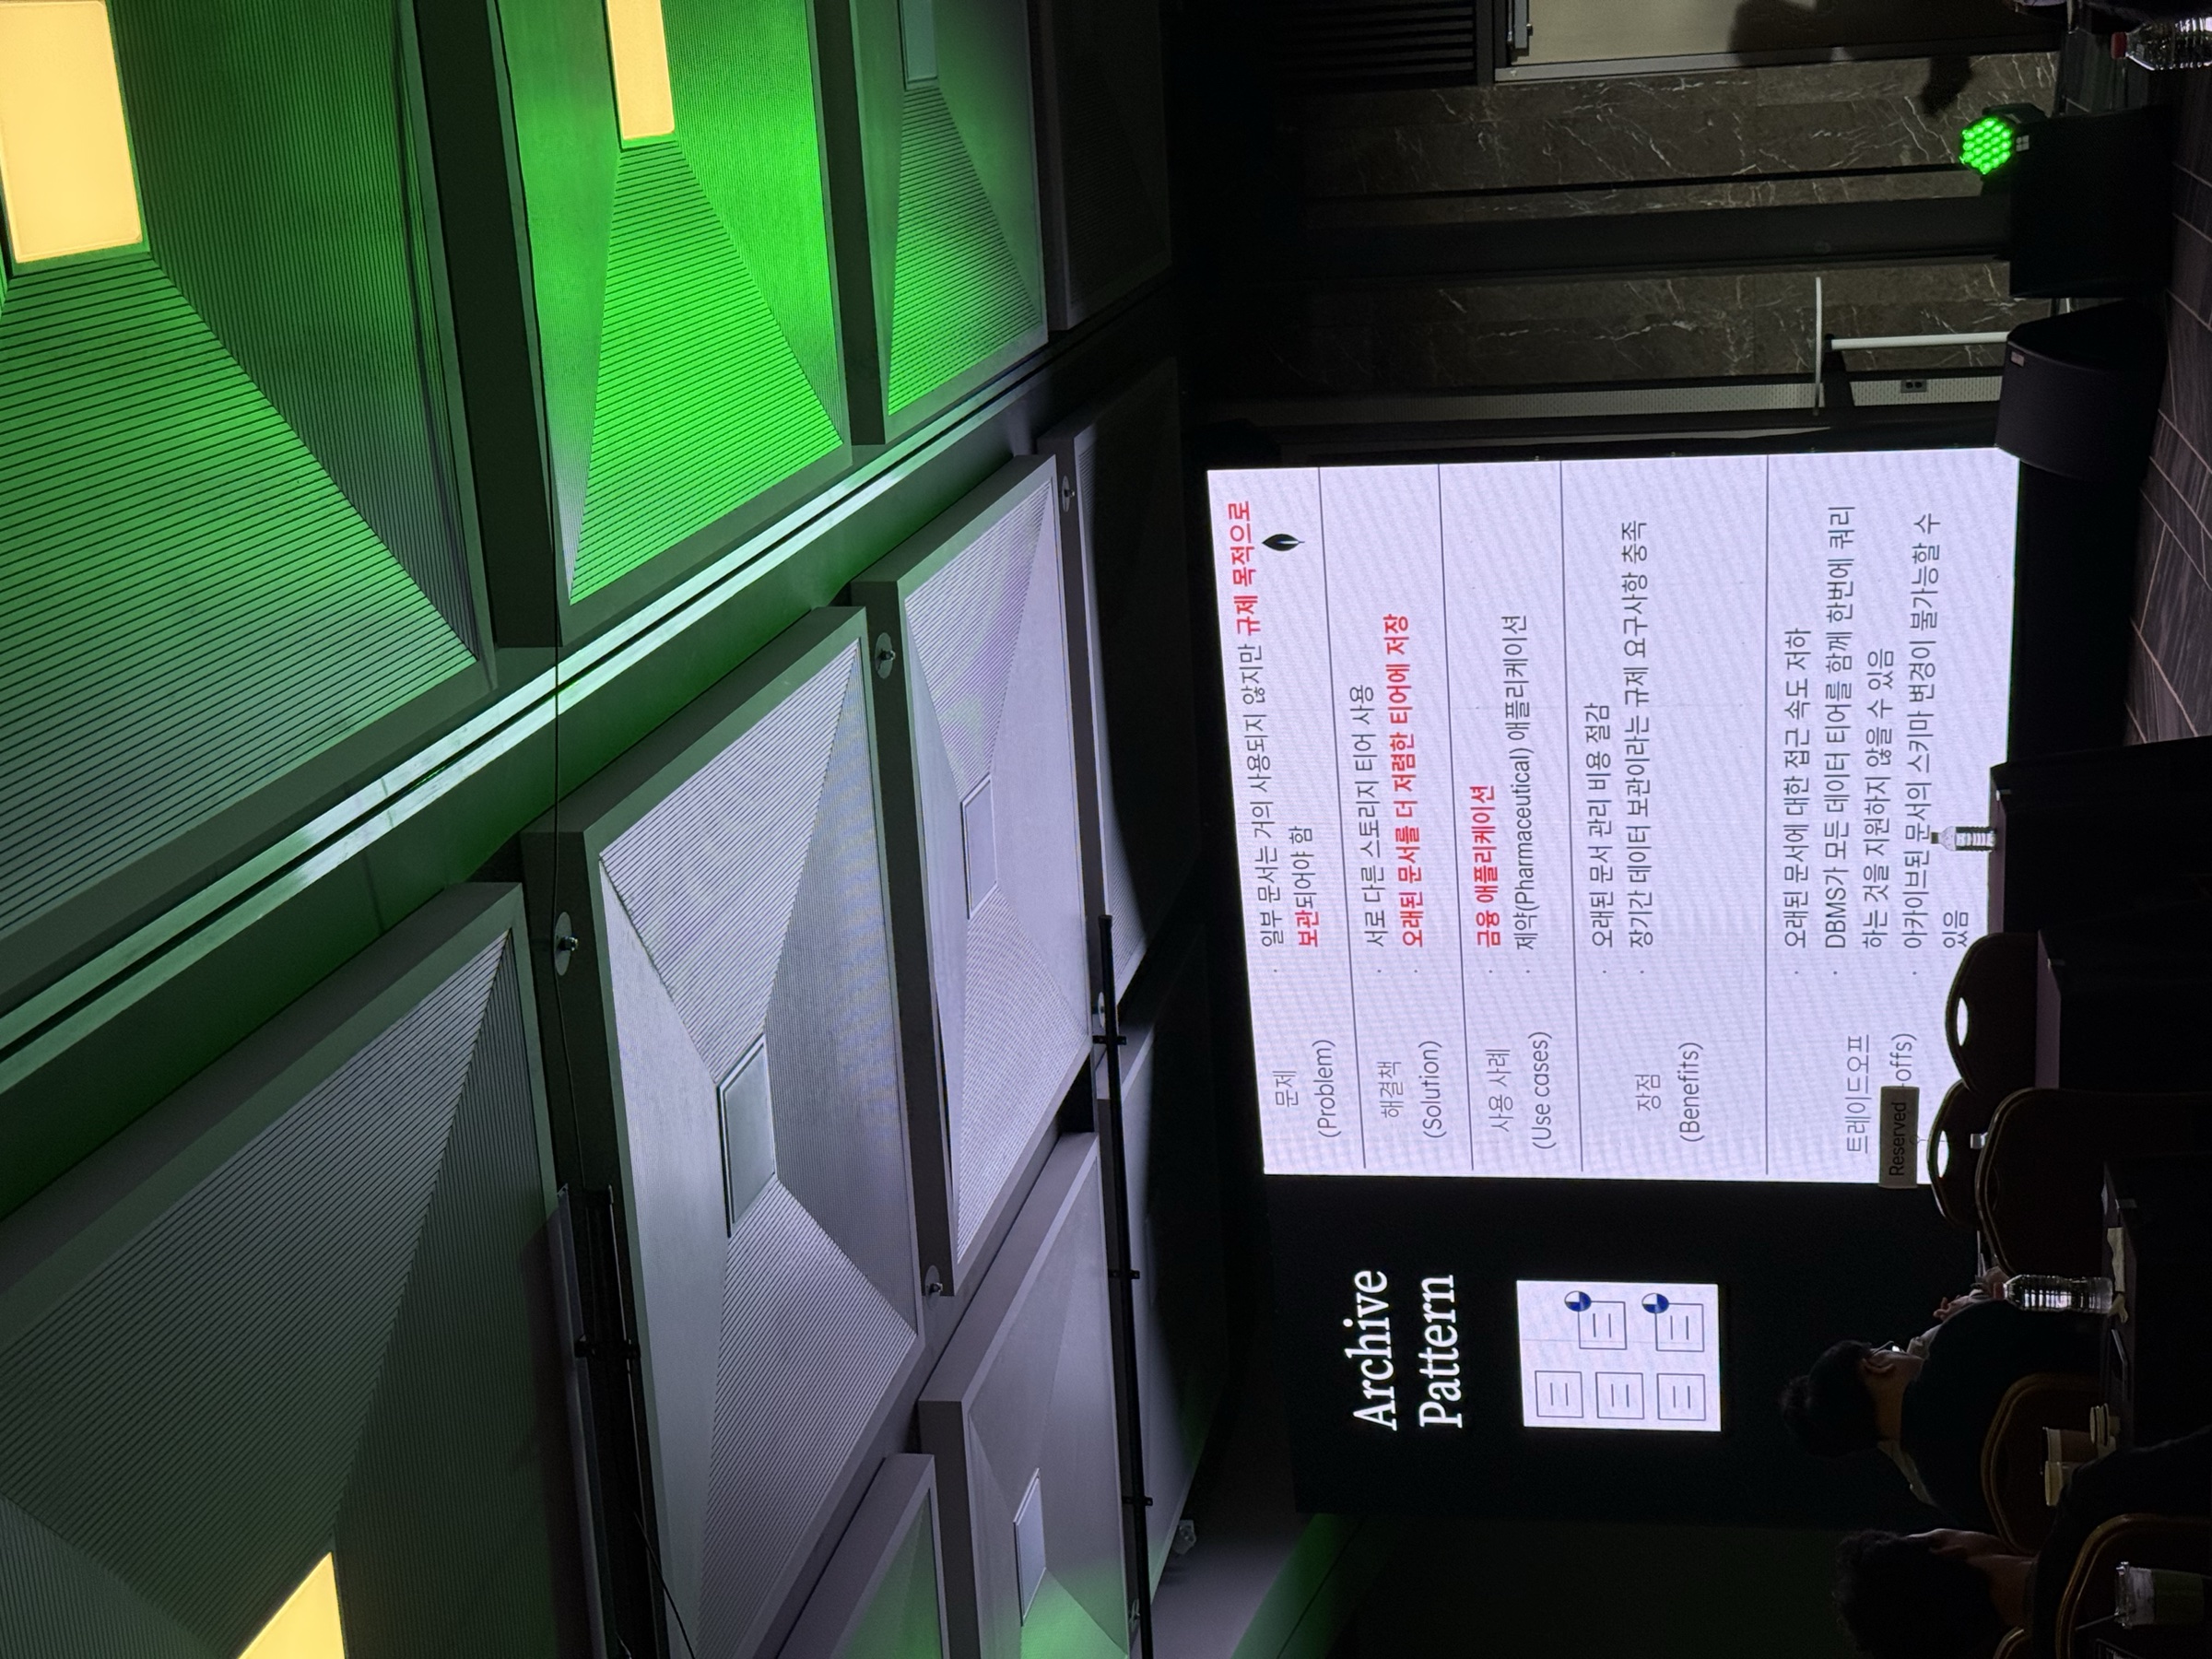
Archive Pattern (아카이브 패턴)
- 문제 (Problem) 대부분의 조회는 최근 데이터에 집중되지만, 규제나 정책상의 이유로 오래된 문서를 수년간 의무적으로 보관해야 하는 경우이다. 이 ’Cold Data’를 자주 사용하는 ’Hot Data’와 동일한 고성용 스토리지에 보관하는 것은 비효율적이다.
- 해결책 (Solution) 데이터의 접근 빈도에 따라 서로 다른 스토리지 티어(Tier)를 사용한다. 오래된 문서를 별도의 컬렉션이나 저렴한 스토리지로 옮겨 관리한다.
- 사용 사례: 장기간 거래 기록 보관이 필수적인 금융 애플리케이션, 연구 데이터 보관이 필요한 제약 애플리케이션
- 장점: 오래된 데이터의 관리 비용을 크게 절감하고, 장기간 데이터 보관이라는 규제 요구사항을 효율적으로 충족한다.
- 트레이드오프: 아카이브된 데이터에 대한 접근 속도가 저하될 수 있으며, 여러 데이터 티어에 걸친 동시 조회가 복잡할 수 있다.
추가 기업 사례
코코네(Cocone): 위기 대응을 통한 리팩토링 사례
코코네는 서비스 성능 저하 문제에 대응하는 과정에서 단순한 하드웨어 증설의 한계를 경험하고, 데이터 모델과 애플리케이션 구조를 근본적으로 개선하여 문제를 해결한 사례이다.
MongoDB의 칭찬만 하는 것이 아니라 장단점과 한계 실패사례를 잘 보여준 케이스인 것 같아 첨부한다.
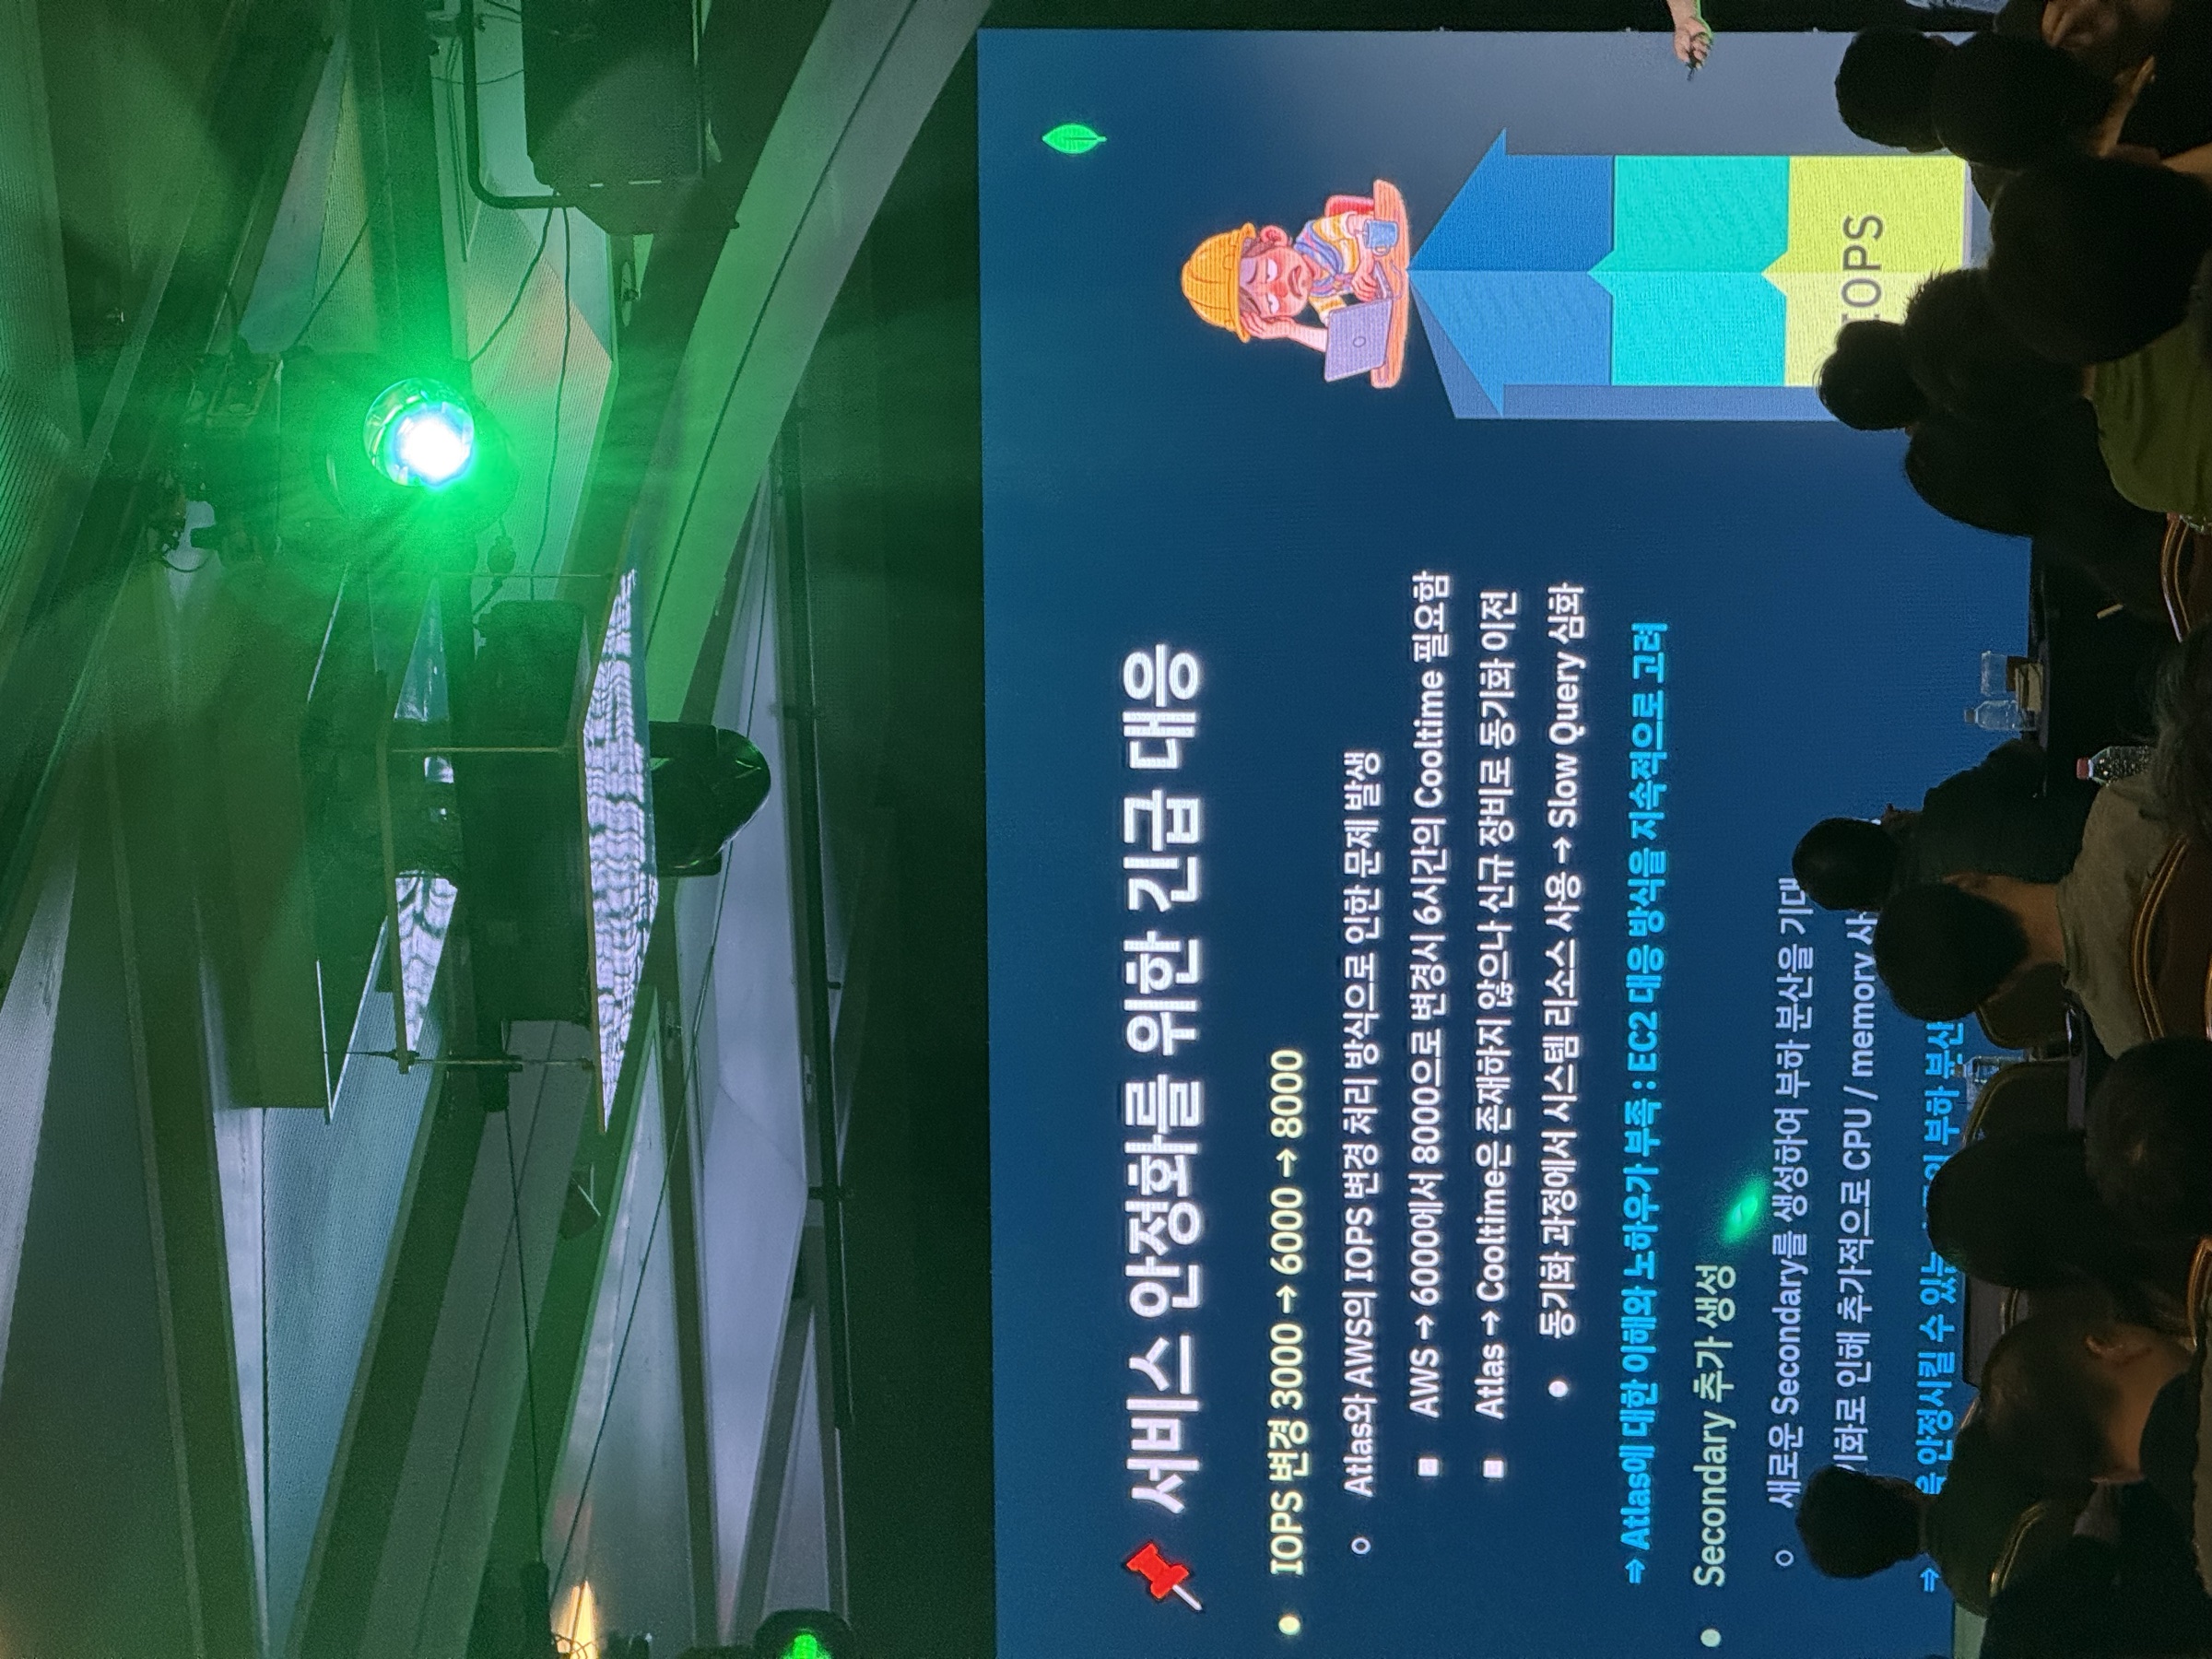
위기: 하드웨어 스케일업의 함정
초기 성능 저하 문제에 대응하기 위해 DB의 사양(IOPS)을 계속 올리는 방식을 택했지만, 이는 또 다른 문제를 발생시켰다.
- Atlas의 동작 방식 미숙: Atlas에서 사양을 높이면, 새로운 장비로 데이터를 동기화하는 과정이 발생한다. 이 동기화 작업 자체가 막대한 시스템 리소스를 사용했고, 이로 인해 이미 발생하던 느린 쿼리(Slow Query) 문제가 오히려 심화되는 악순환이 발생했다.
- 잘못된 부하 분산 시도: 기존 EC2 환경에서의 경험을 바탕으로 부하 분산을 위해 Secondary 노드를 추가했지만, 이는 데이터 동기화 부하만 가중시켜 오히려 전체 시스템의 CPU와 메모리 사용량을 증가시키는 결과를 낳았다.
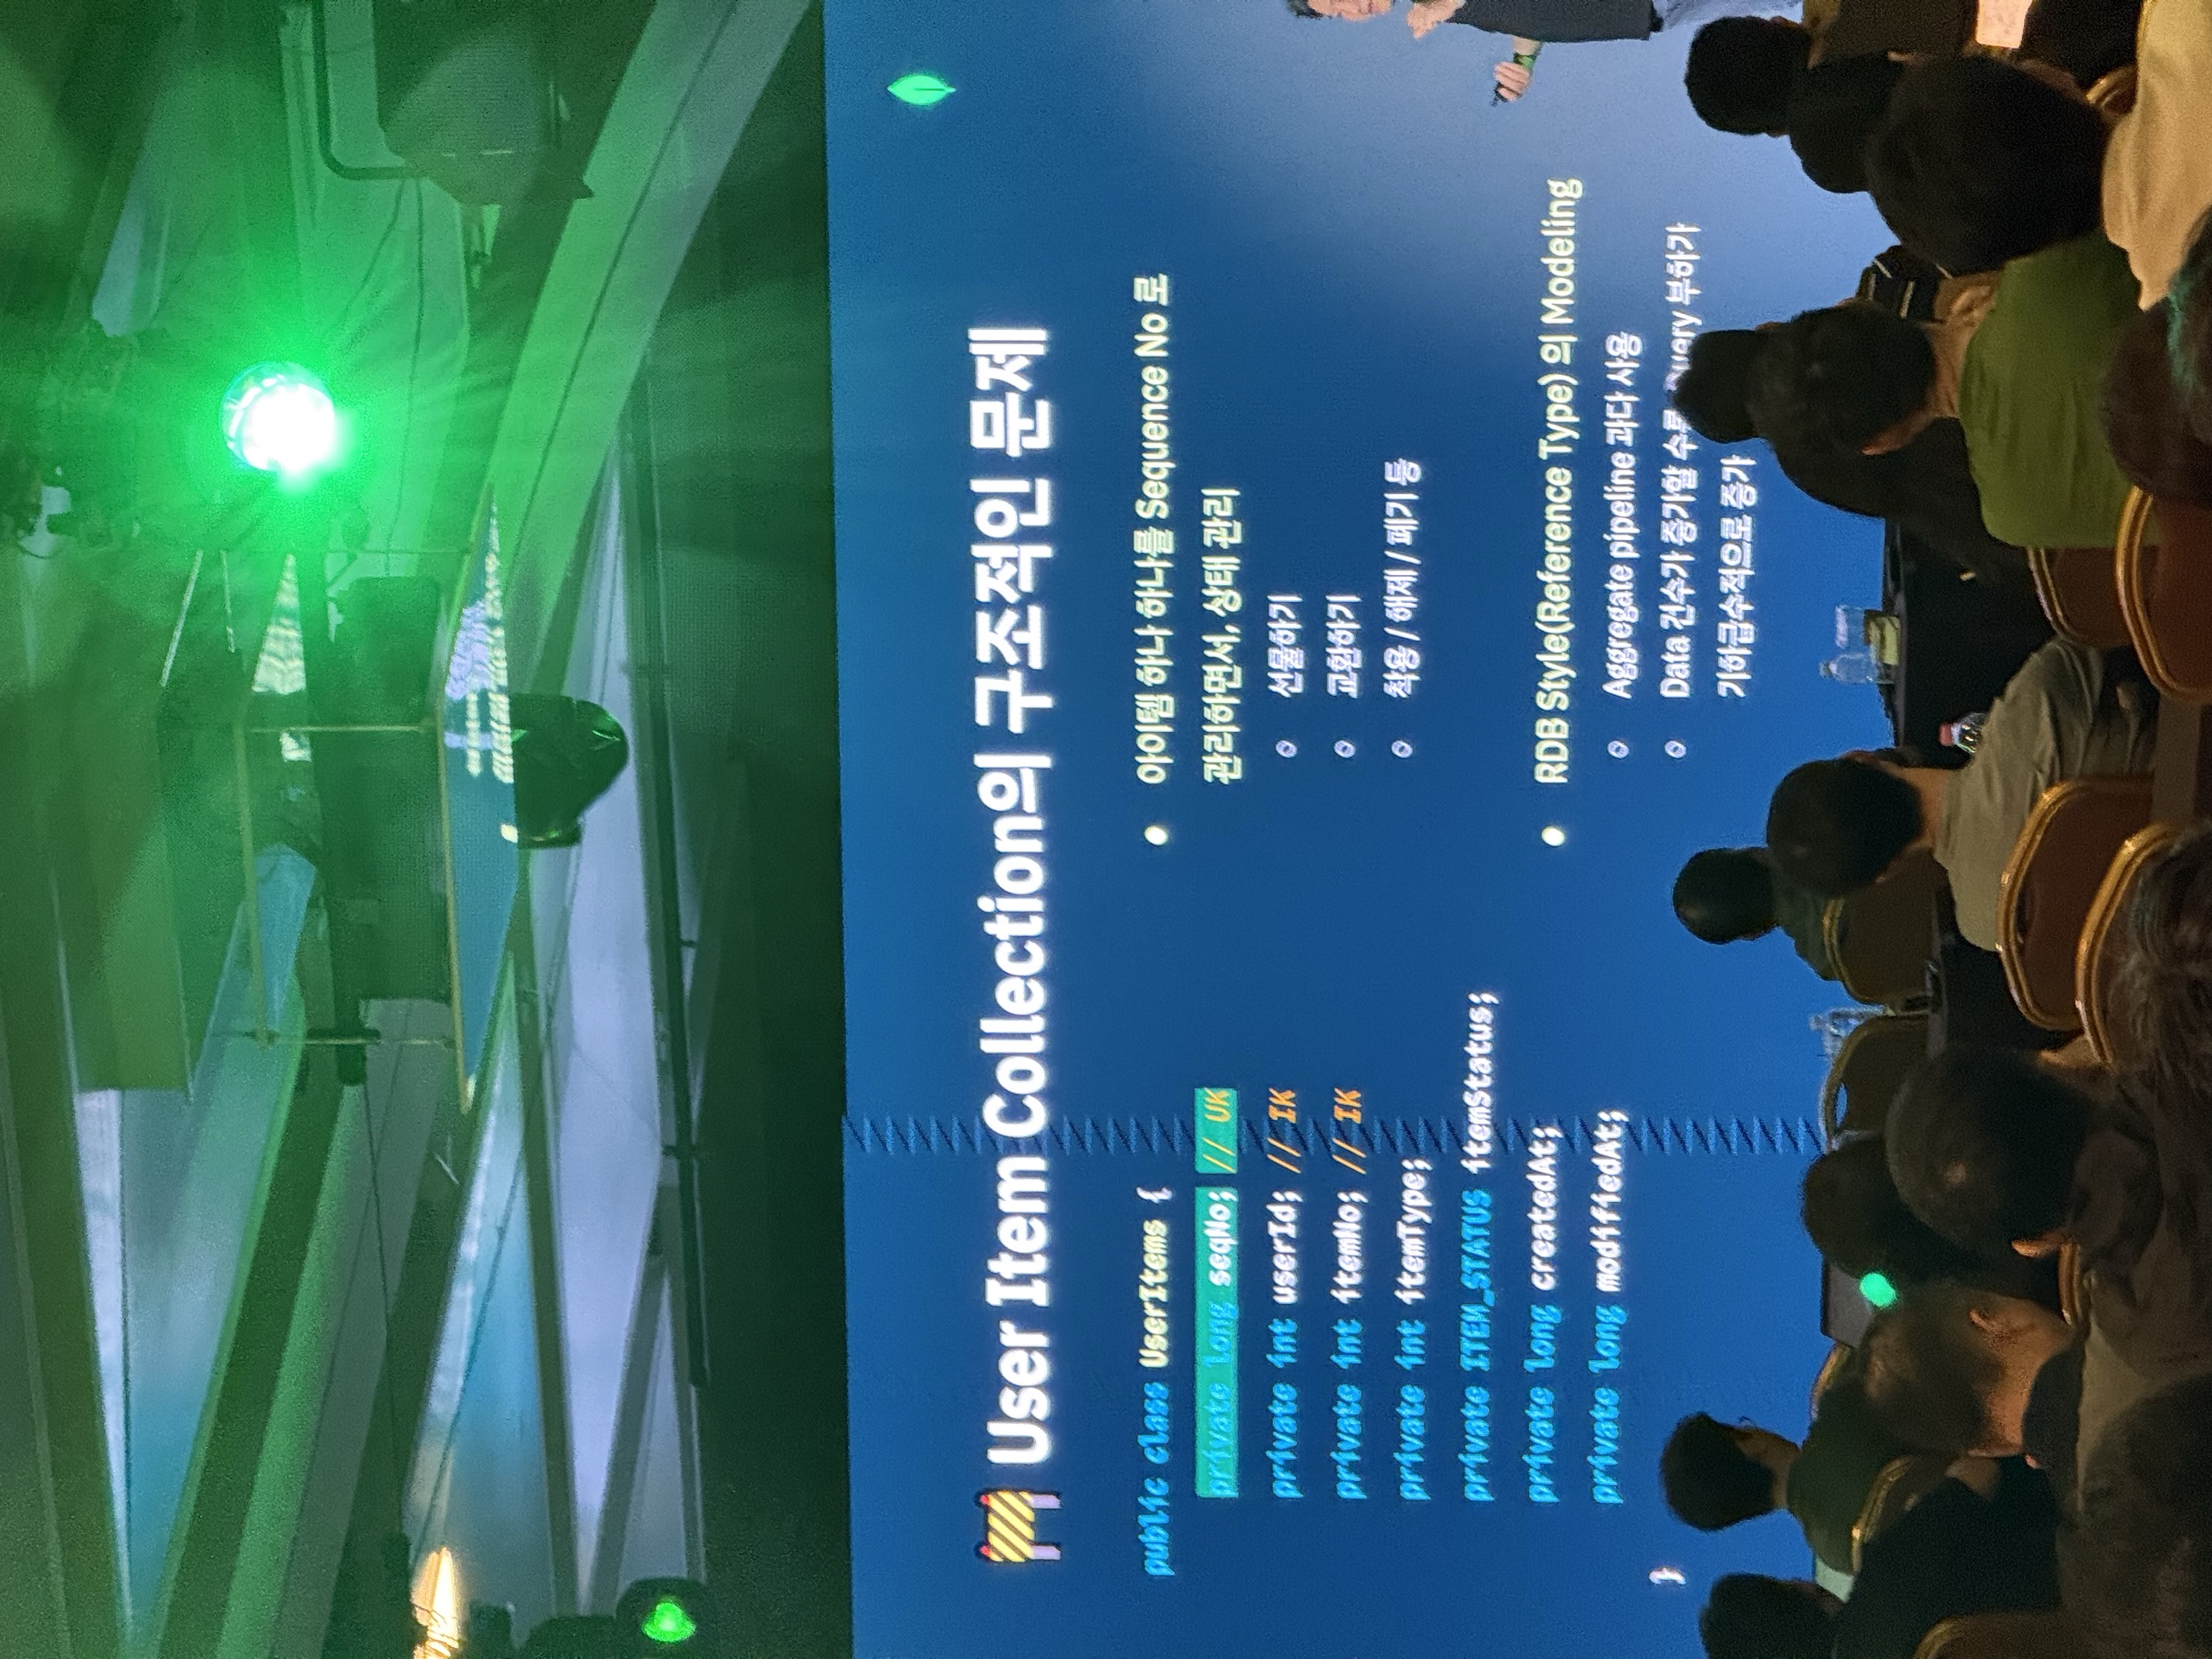
해결책: 데이터 모델과 애플리케이션 리팩토링
근본적인 원인이 하드웨어가 아닌 데이터 모델에 있음을 파악하고 대대적인 리팩토링을 진행했다.
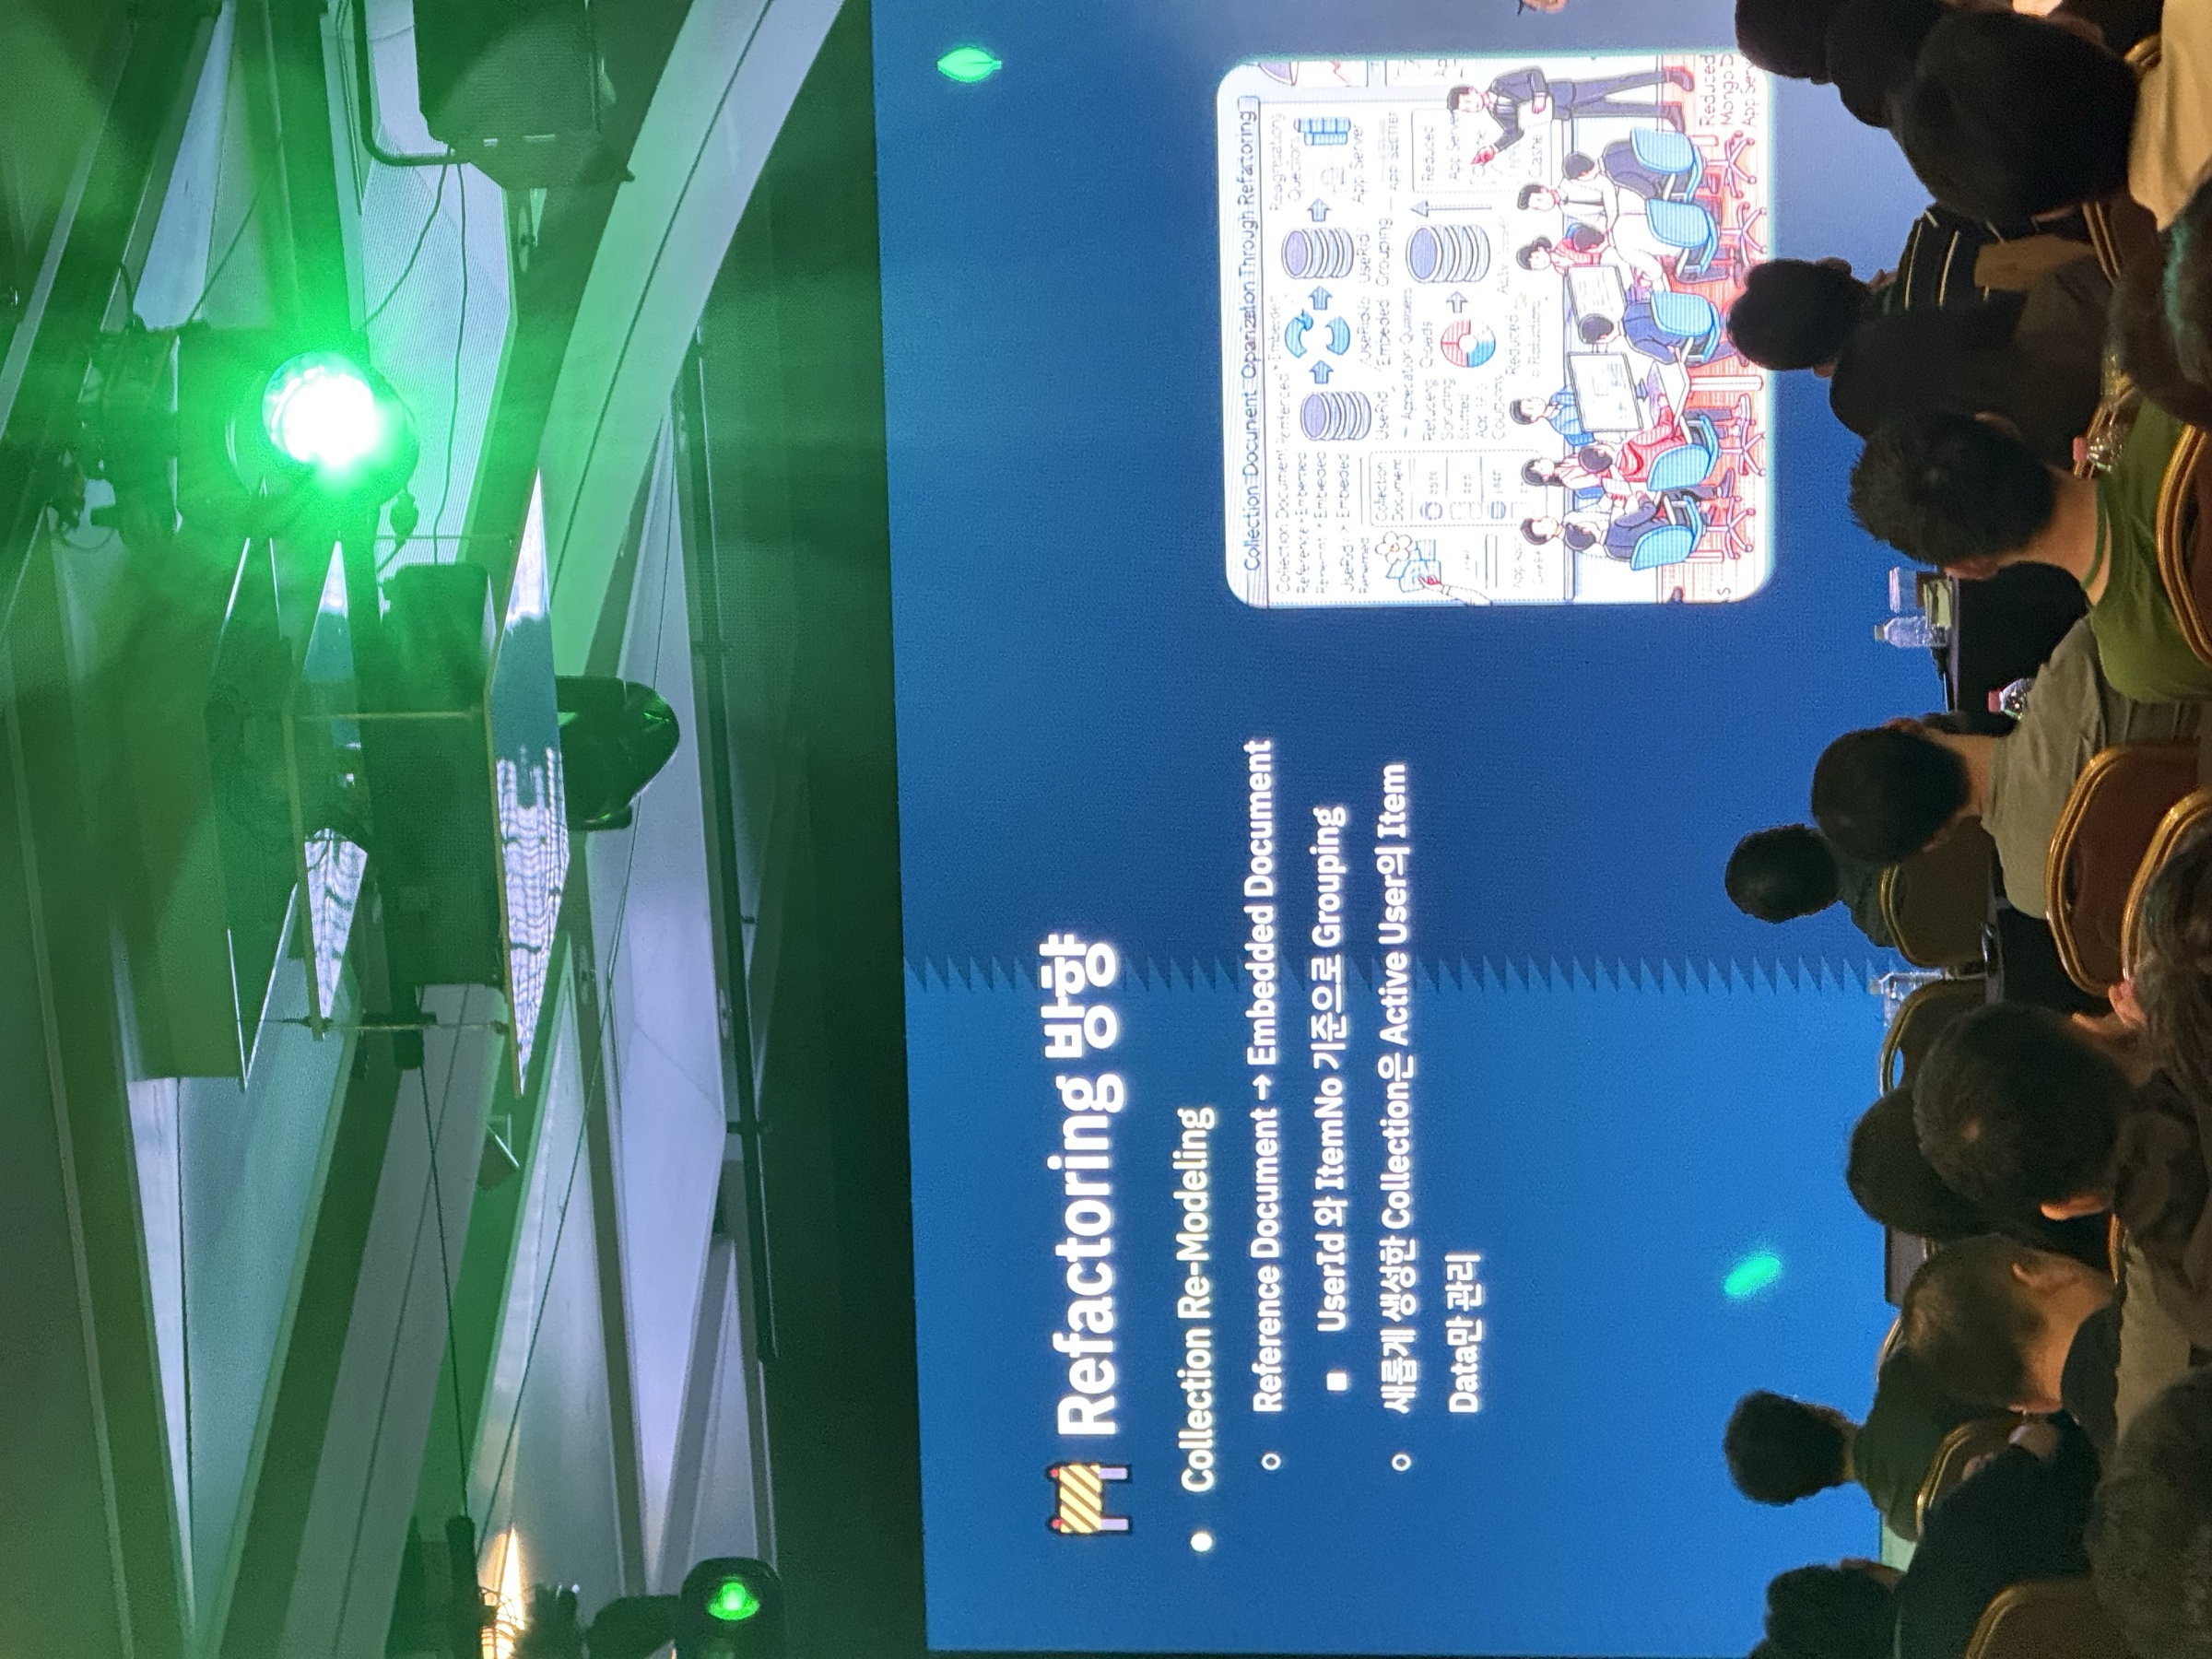
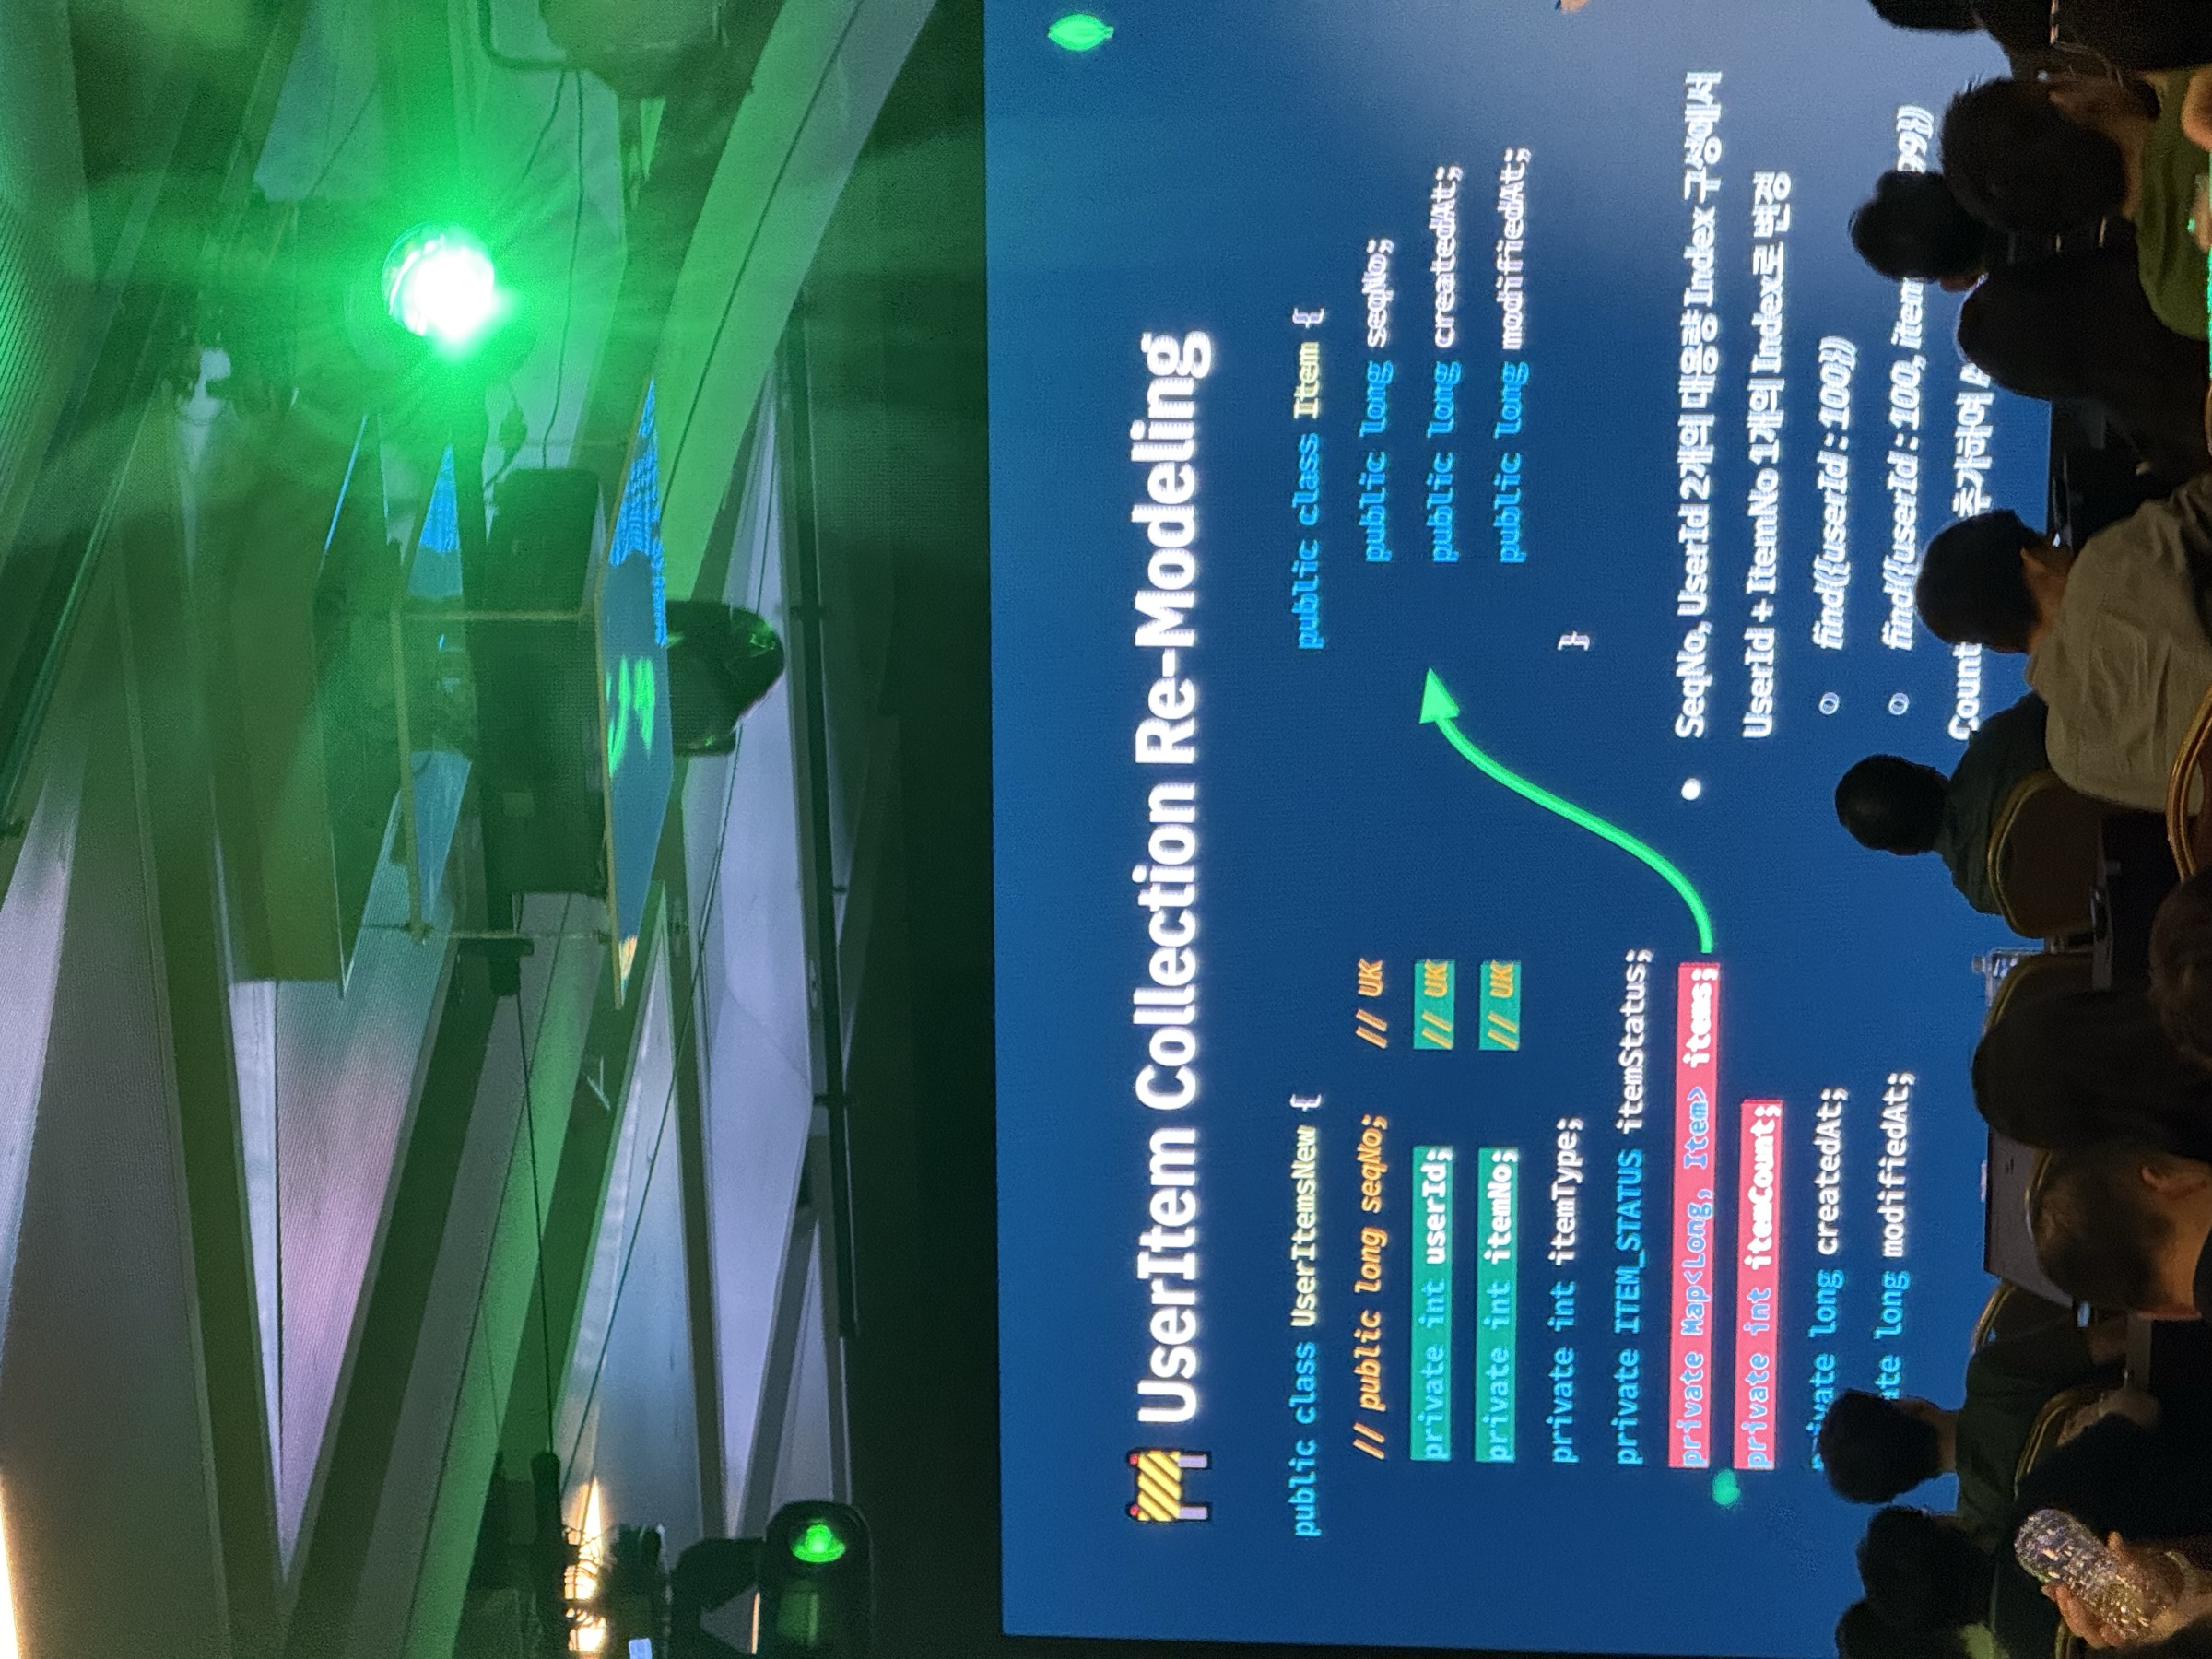
- 스키마 재설계 (Collection Re-Modeling)
- 기존: 관계형 DB 스타일(Reference)로, 사용자 아이템 하나하나를 개별 문서로 관리했다. 이로 인해 전체 데이터는 8억 건에 달했고, 복잡한
Aggregation Pipeline을 과도하게 사용하여 성능 부하가 심했다. - 변경: 임베딩(Embedding) 방식으로 전환하여, 사용자 한 명당 하나의 문서를 갖고 그 안에 아이템 목록을 맵(Map) 형태로 저장했다. 이를 통해 액티브 유저의 데이터만 관리하는 신규 컬렉션은 8억 건에서 4천만 건으로 데이터가 획기적으로 감소했다. 인덱스 또한 기존의 비효율적인 2개에서
UserId기반의 효율적인 단일 인덱스로 변경했다.
- 애플리케이션 리팩토링
- Facade Service 패턴 도입: 신규 서비스와 레거시 서비스를 분리하는 중간 계층을 두어, 점진적이고 안정적인 데이터 전환이 가능하도록 아키텍처를 개선했다.
- 쿼리 최적화: 리소스 소모가 큰
Aggregation쿼리를, 인덱스와 프로젝션(Projection, 필요한 필드만 조회)을 활용하는 효율적인find쿼리로 대부분 전환했다. - 캐시 활용 증대: 애플리케이션 레벨의 캐시 사용을 늘려 DB 조회(Read) 횟수 자체를 줄였다.
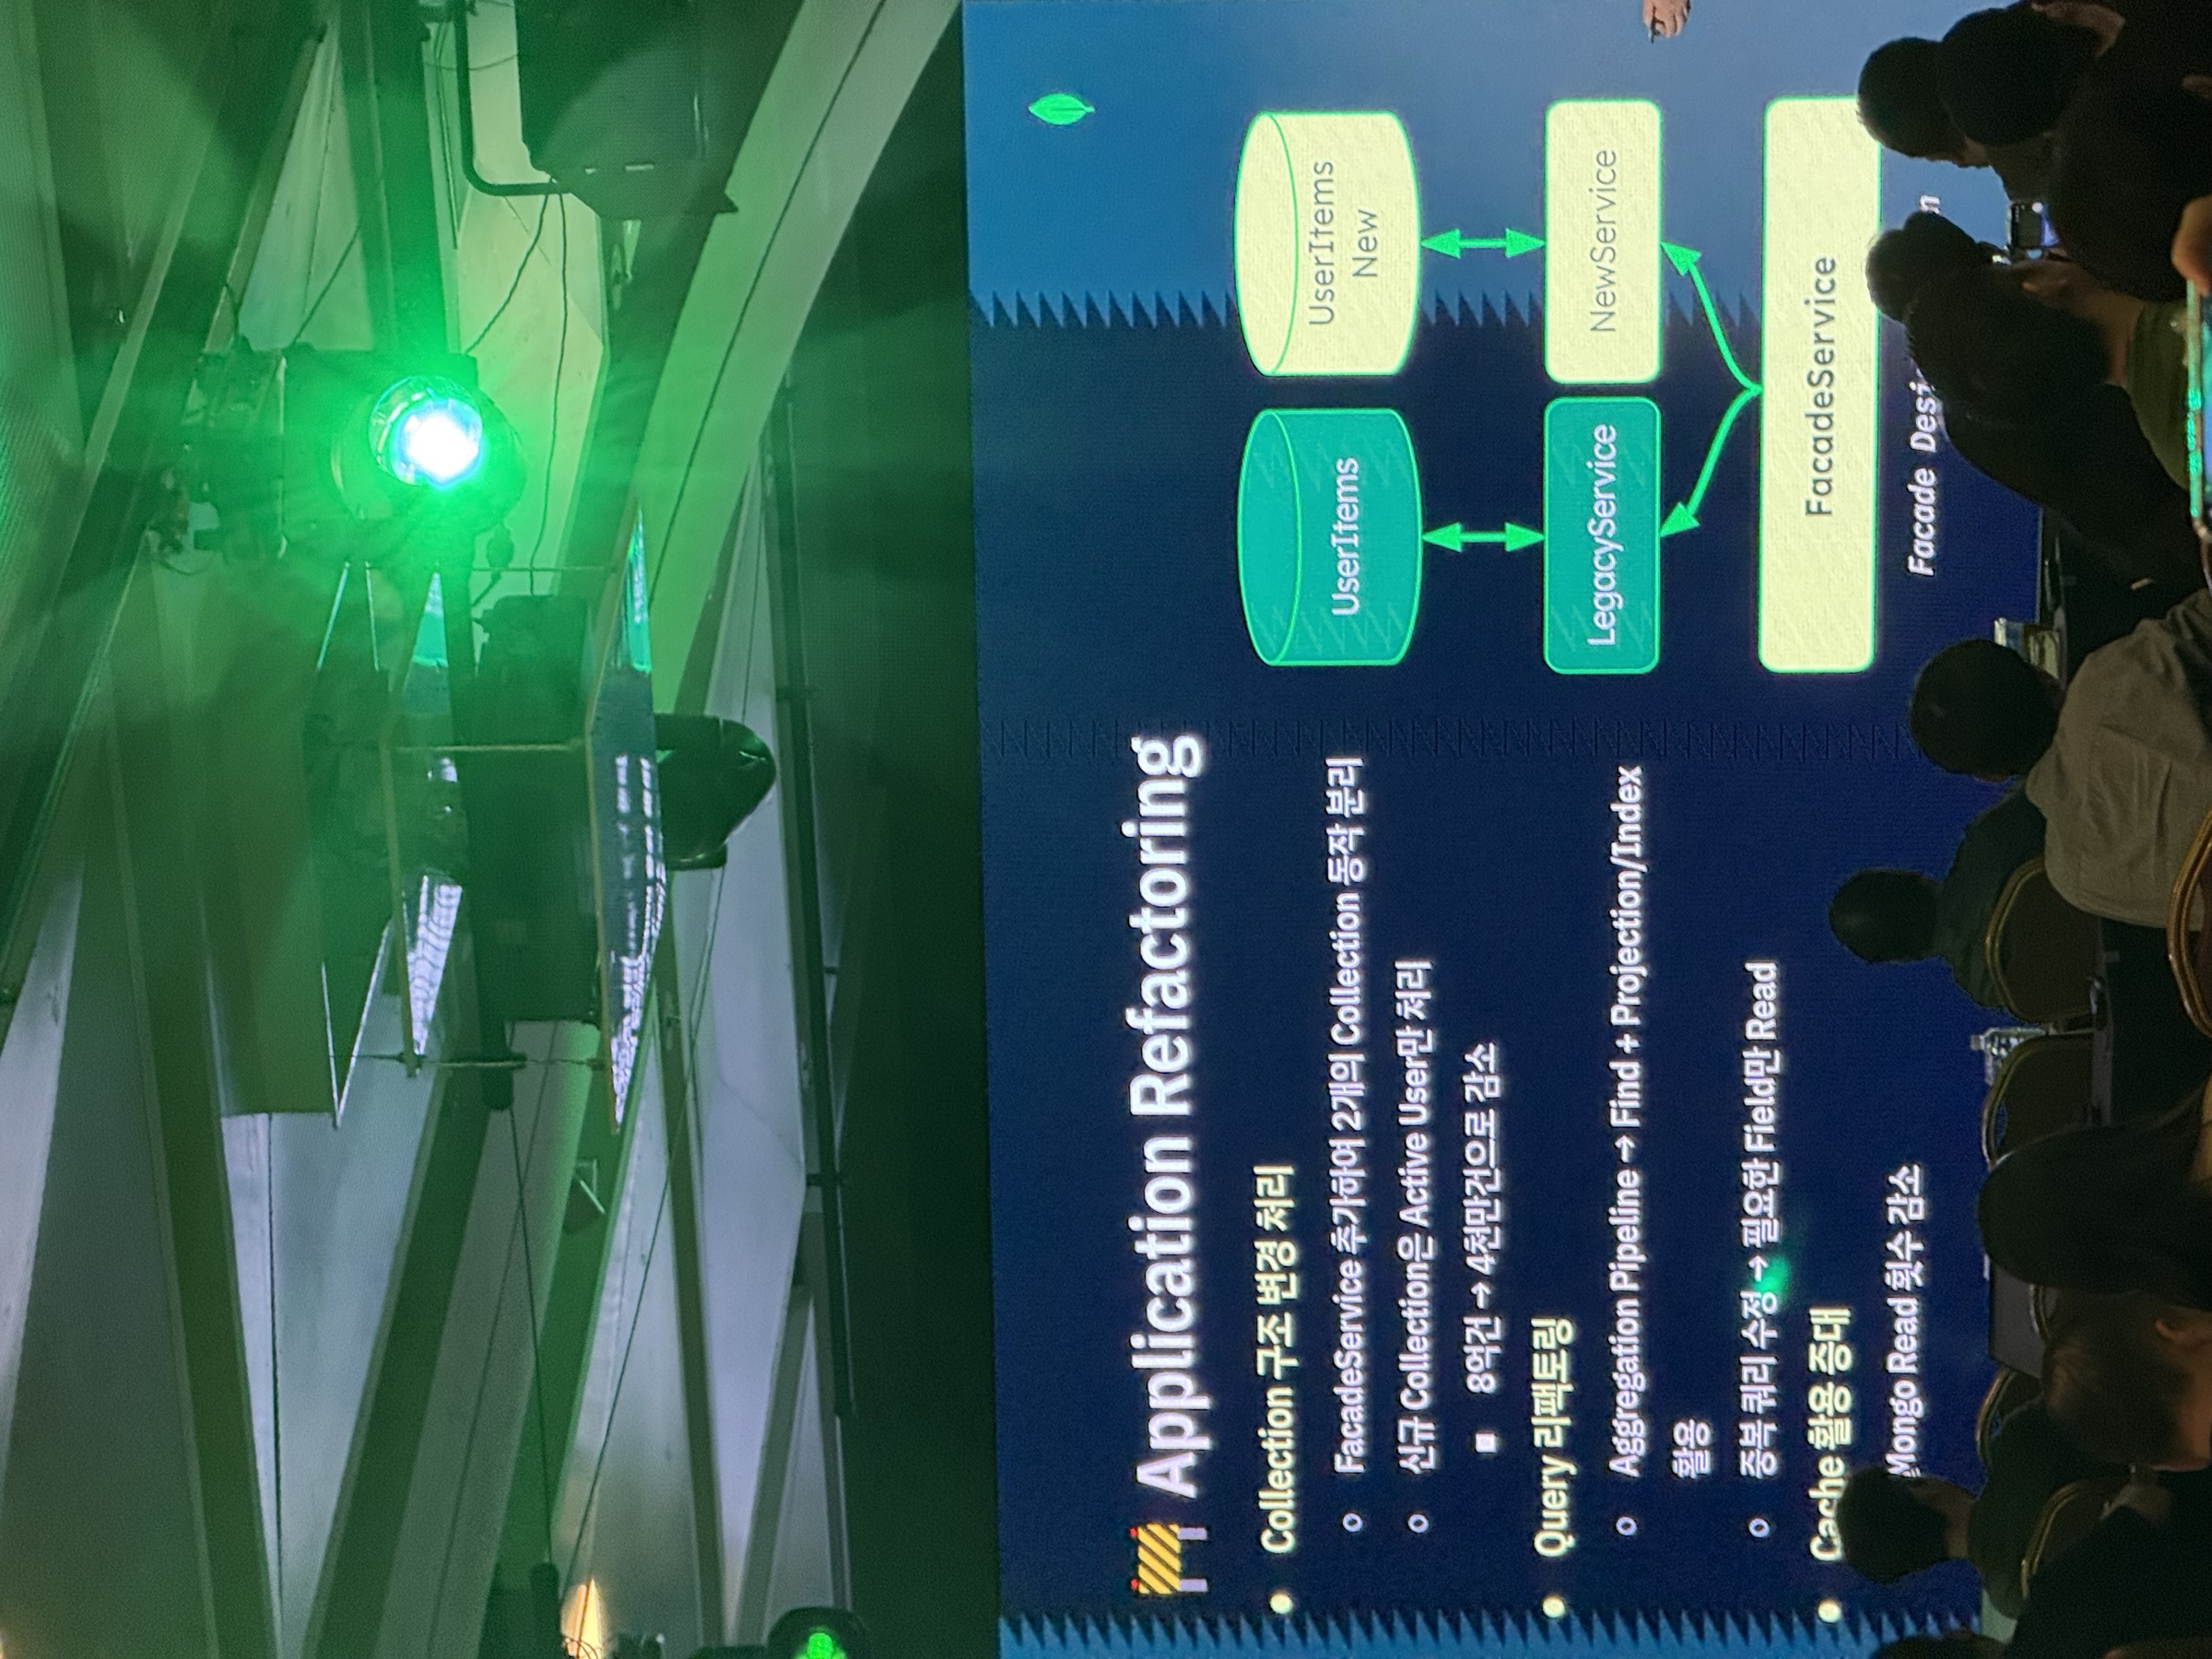
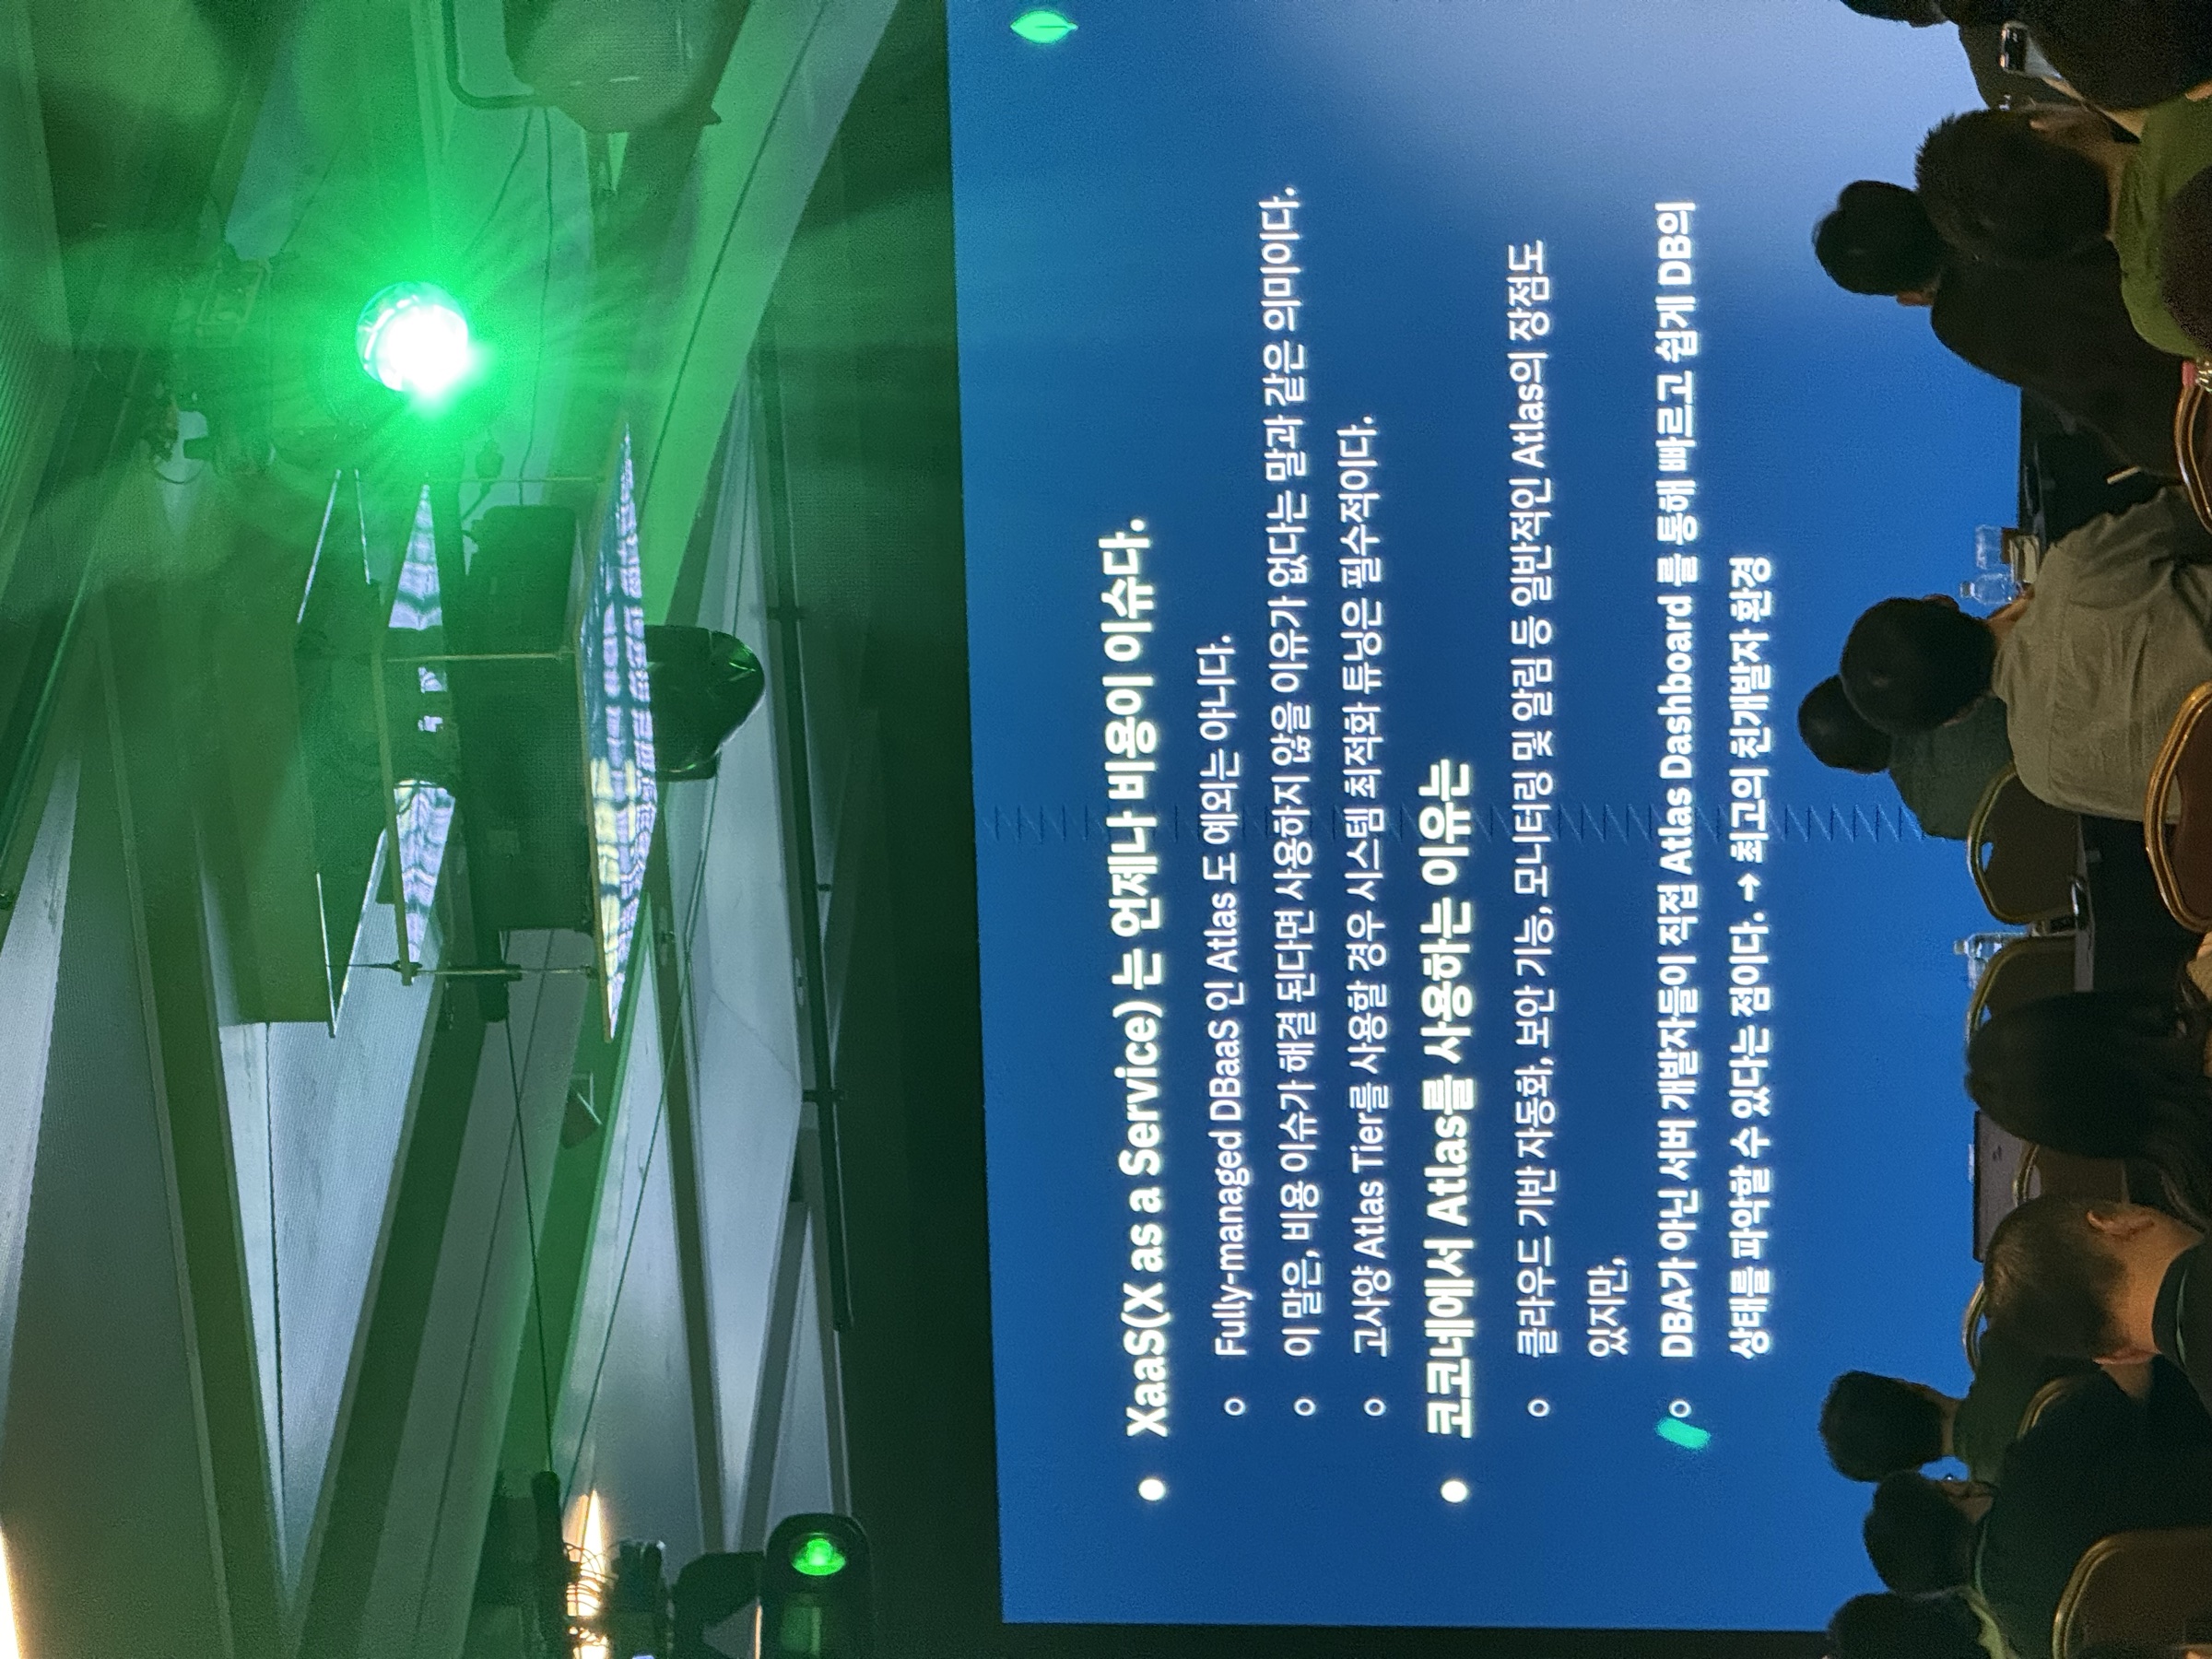
코코네 CTO의 Atlas 마이그레이션 조언
- 비용과 최적화: Atlas와 같은 Fully-managed DBaaS는 항상 비용 이슈가 따르며, 고사양 Tier를 비용 효율적으로 사용하기 위해서는 시스템 최적화 튜닝이 필수적이다.
- 개발자 친화적 환경: Atlas의 가장 큰 장점 중 하나는 DBA가 아닌 서버 개발자도 대시보드를 통해 DB 상태를 쉽고 빠르게 파악할 수 있다는 점이다.
- 애플리케이션이 핵심이다: DB 성능 개선은 버전업이나 스케일업만으로는 명확한 한계가 있다. 비즈니스 로직을 담고 있는 애플리케이션이 함께 개선되지 않으면 지속 가능한 서비스를 만들기 어렵다.
- 내부 전문가를 믿어라: 컨설턴트의 조언은 서비스의 내부 구조를 모르기 때문에 한계가 있다. 서비스를 가장 잘 아는 것은 담당 개발자이다.
캐시워크(CashWalk): 실무에서 활용하는 Atlas 고급 기능
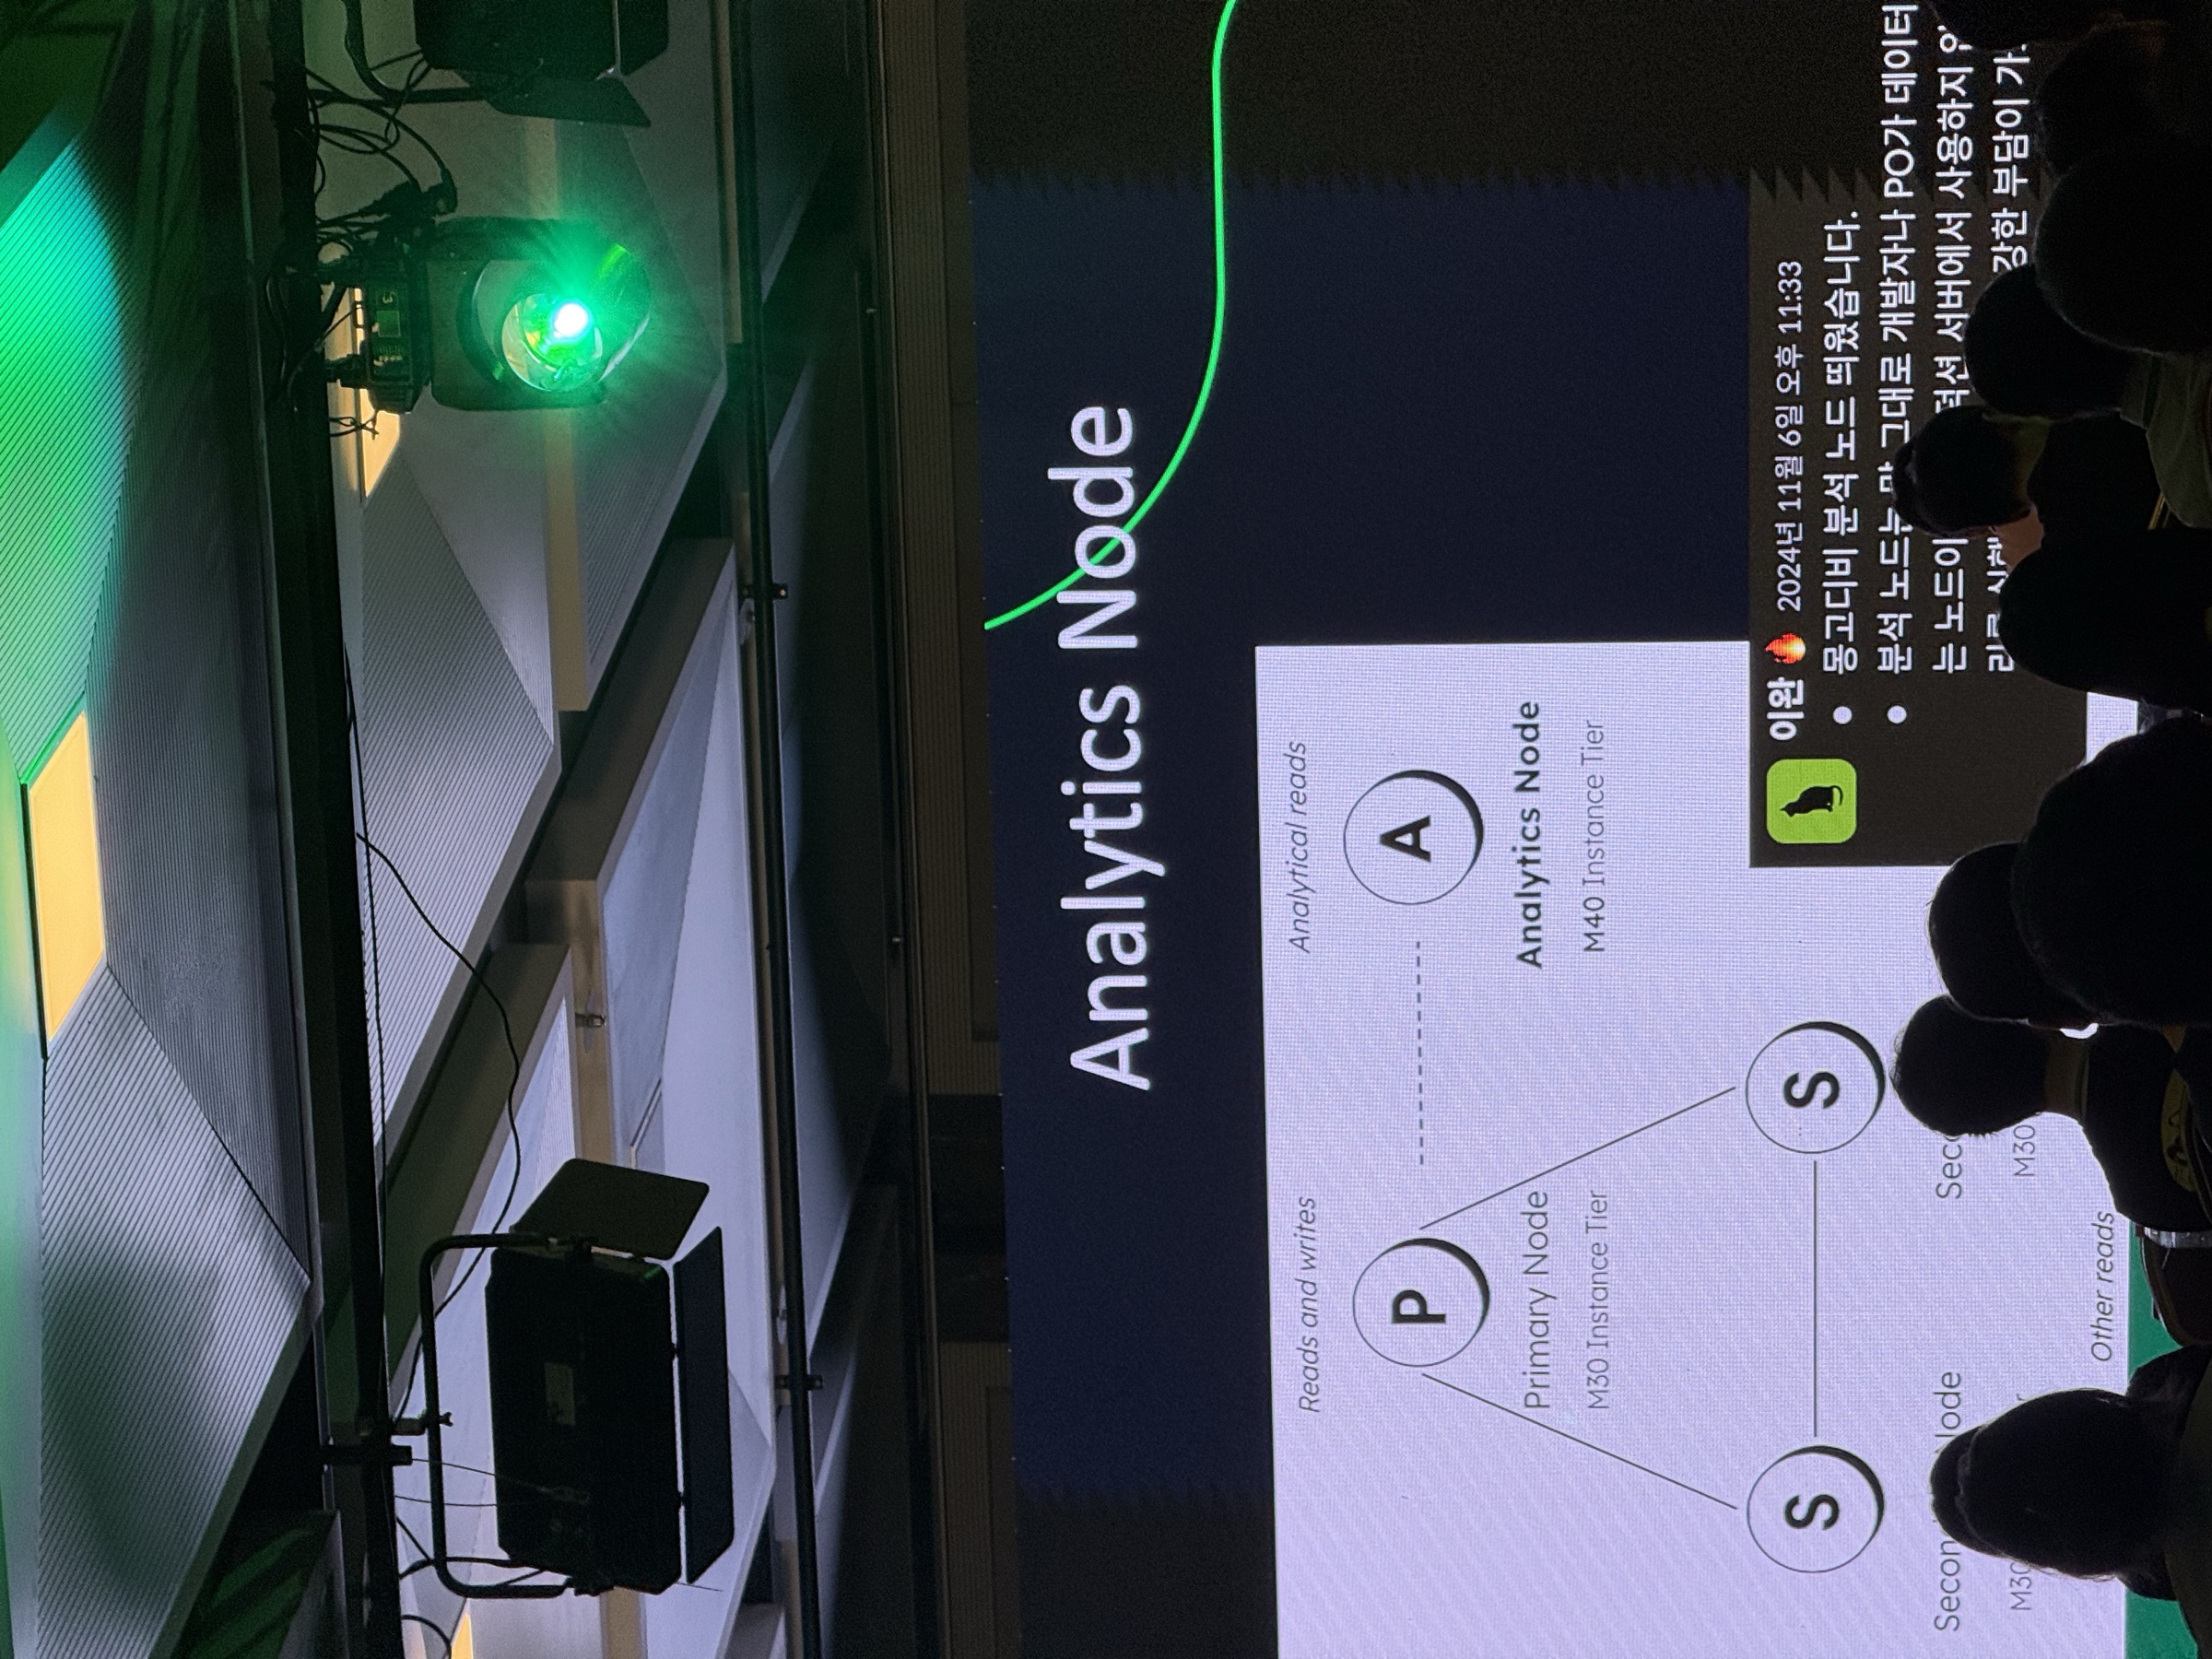
캐시워크는 MongoDB Atlas의 다양한 고급 기능을 적극적으로 활용하여 서비스 효율을 높이고 있다. 실무에서 유용하게 사용될 수 있는 주요 기능들을 소개해주셨다.
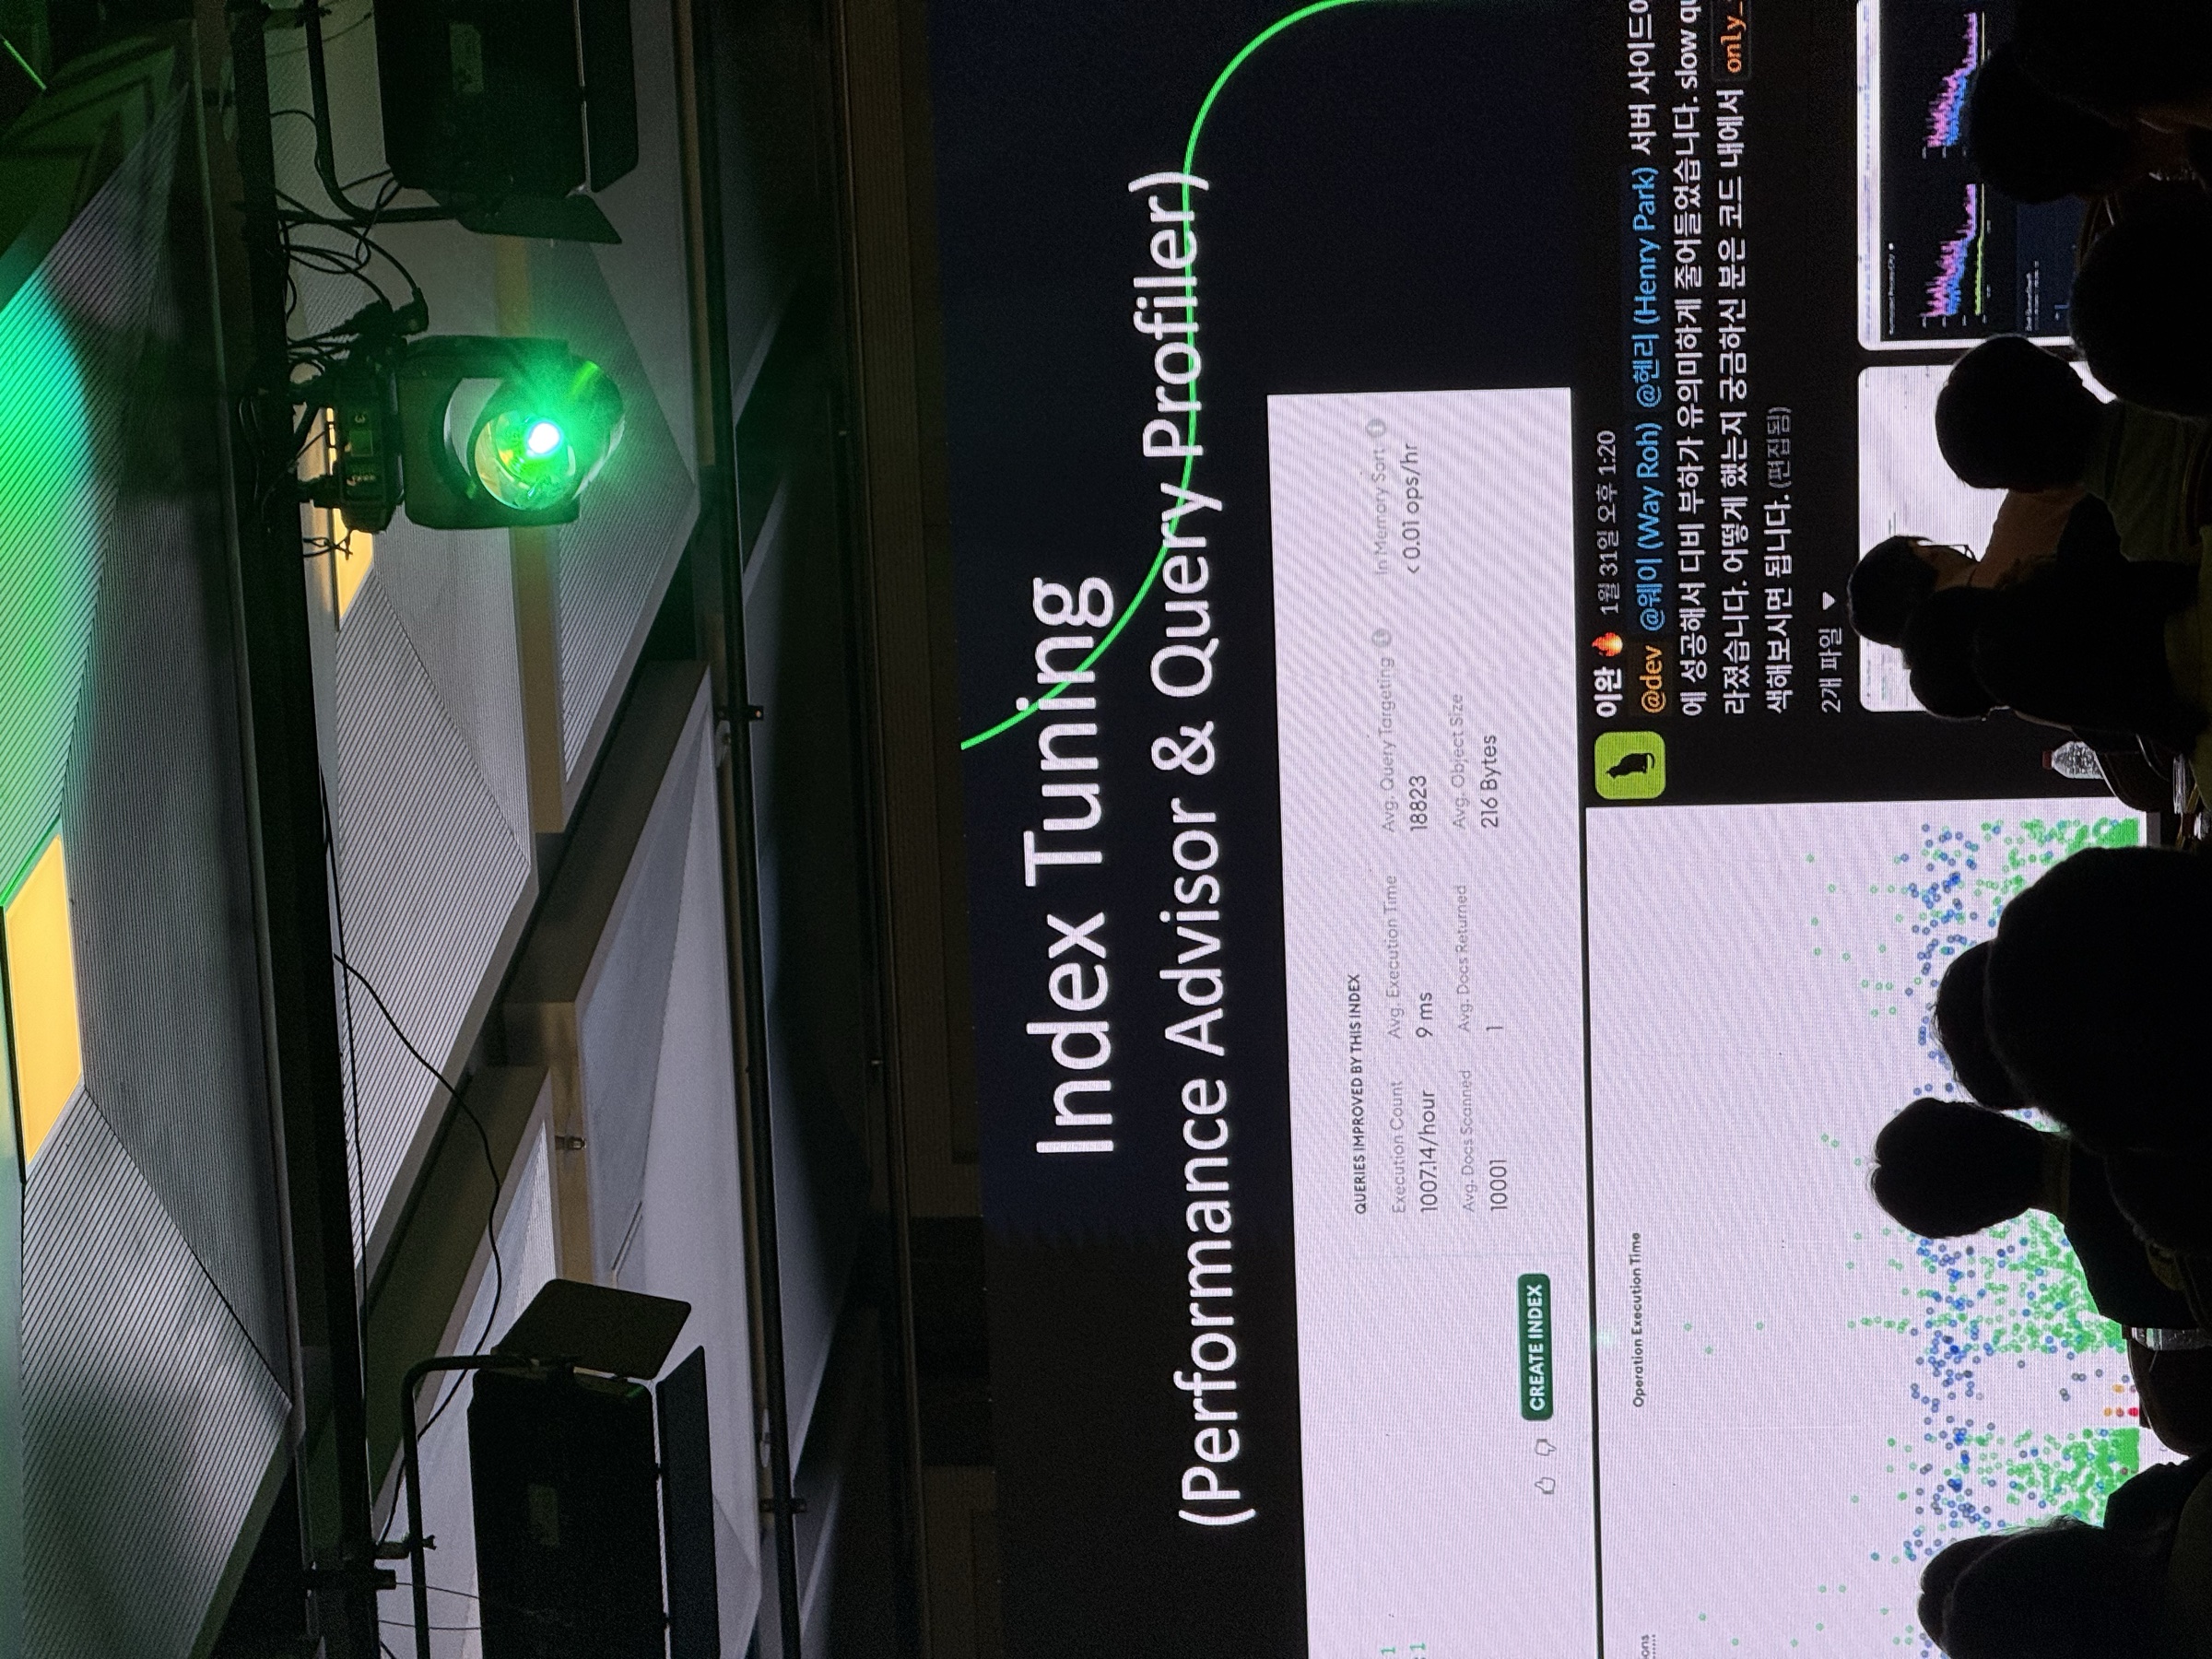
-
분석 노드 (Analytics Node) 서비스에 직접적인 영향을 주는 운영 DB와 분리된, 읽기 전용 분석용 노드이다. 이 노드를 사용하면 무거운 통계 및 분석 쿼리를 실행해도 실제 서비스의 성능 저하 없이 안전하게 데이터를 분석할 수 있다.
-
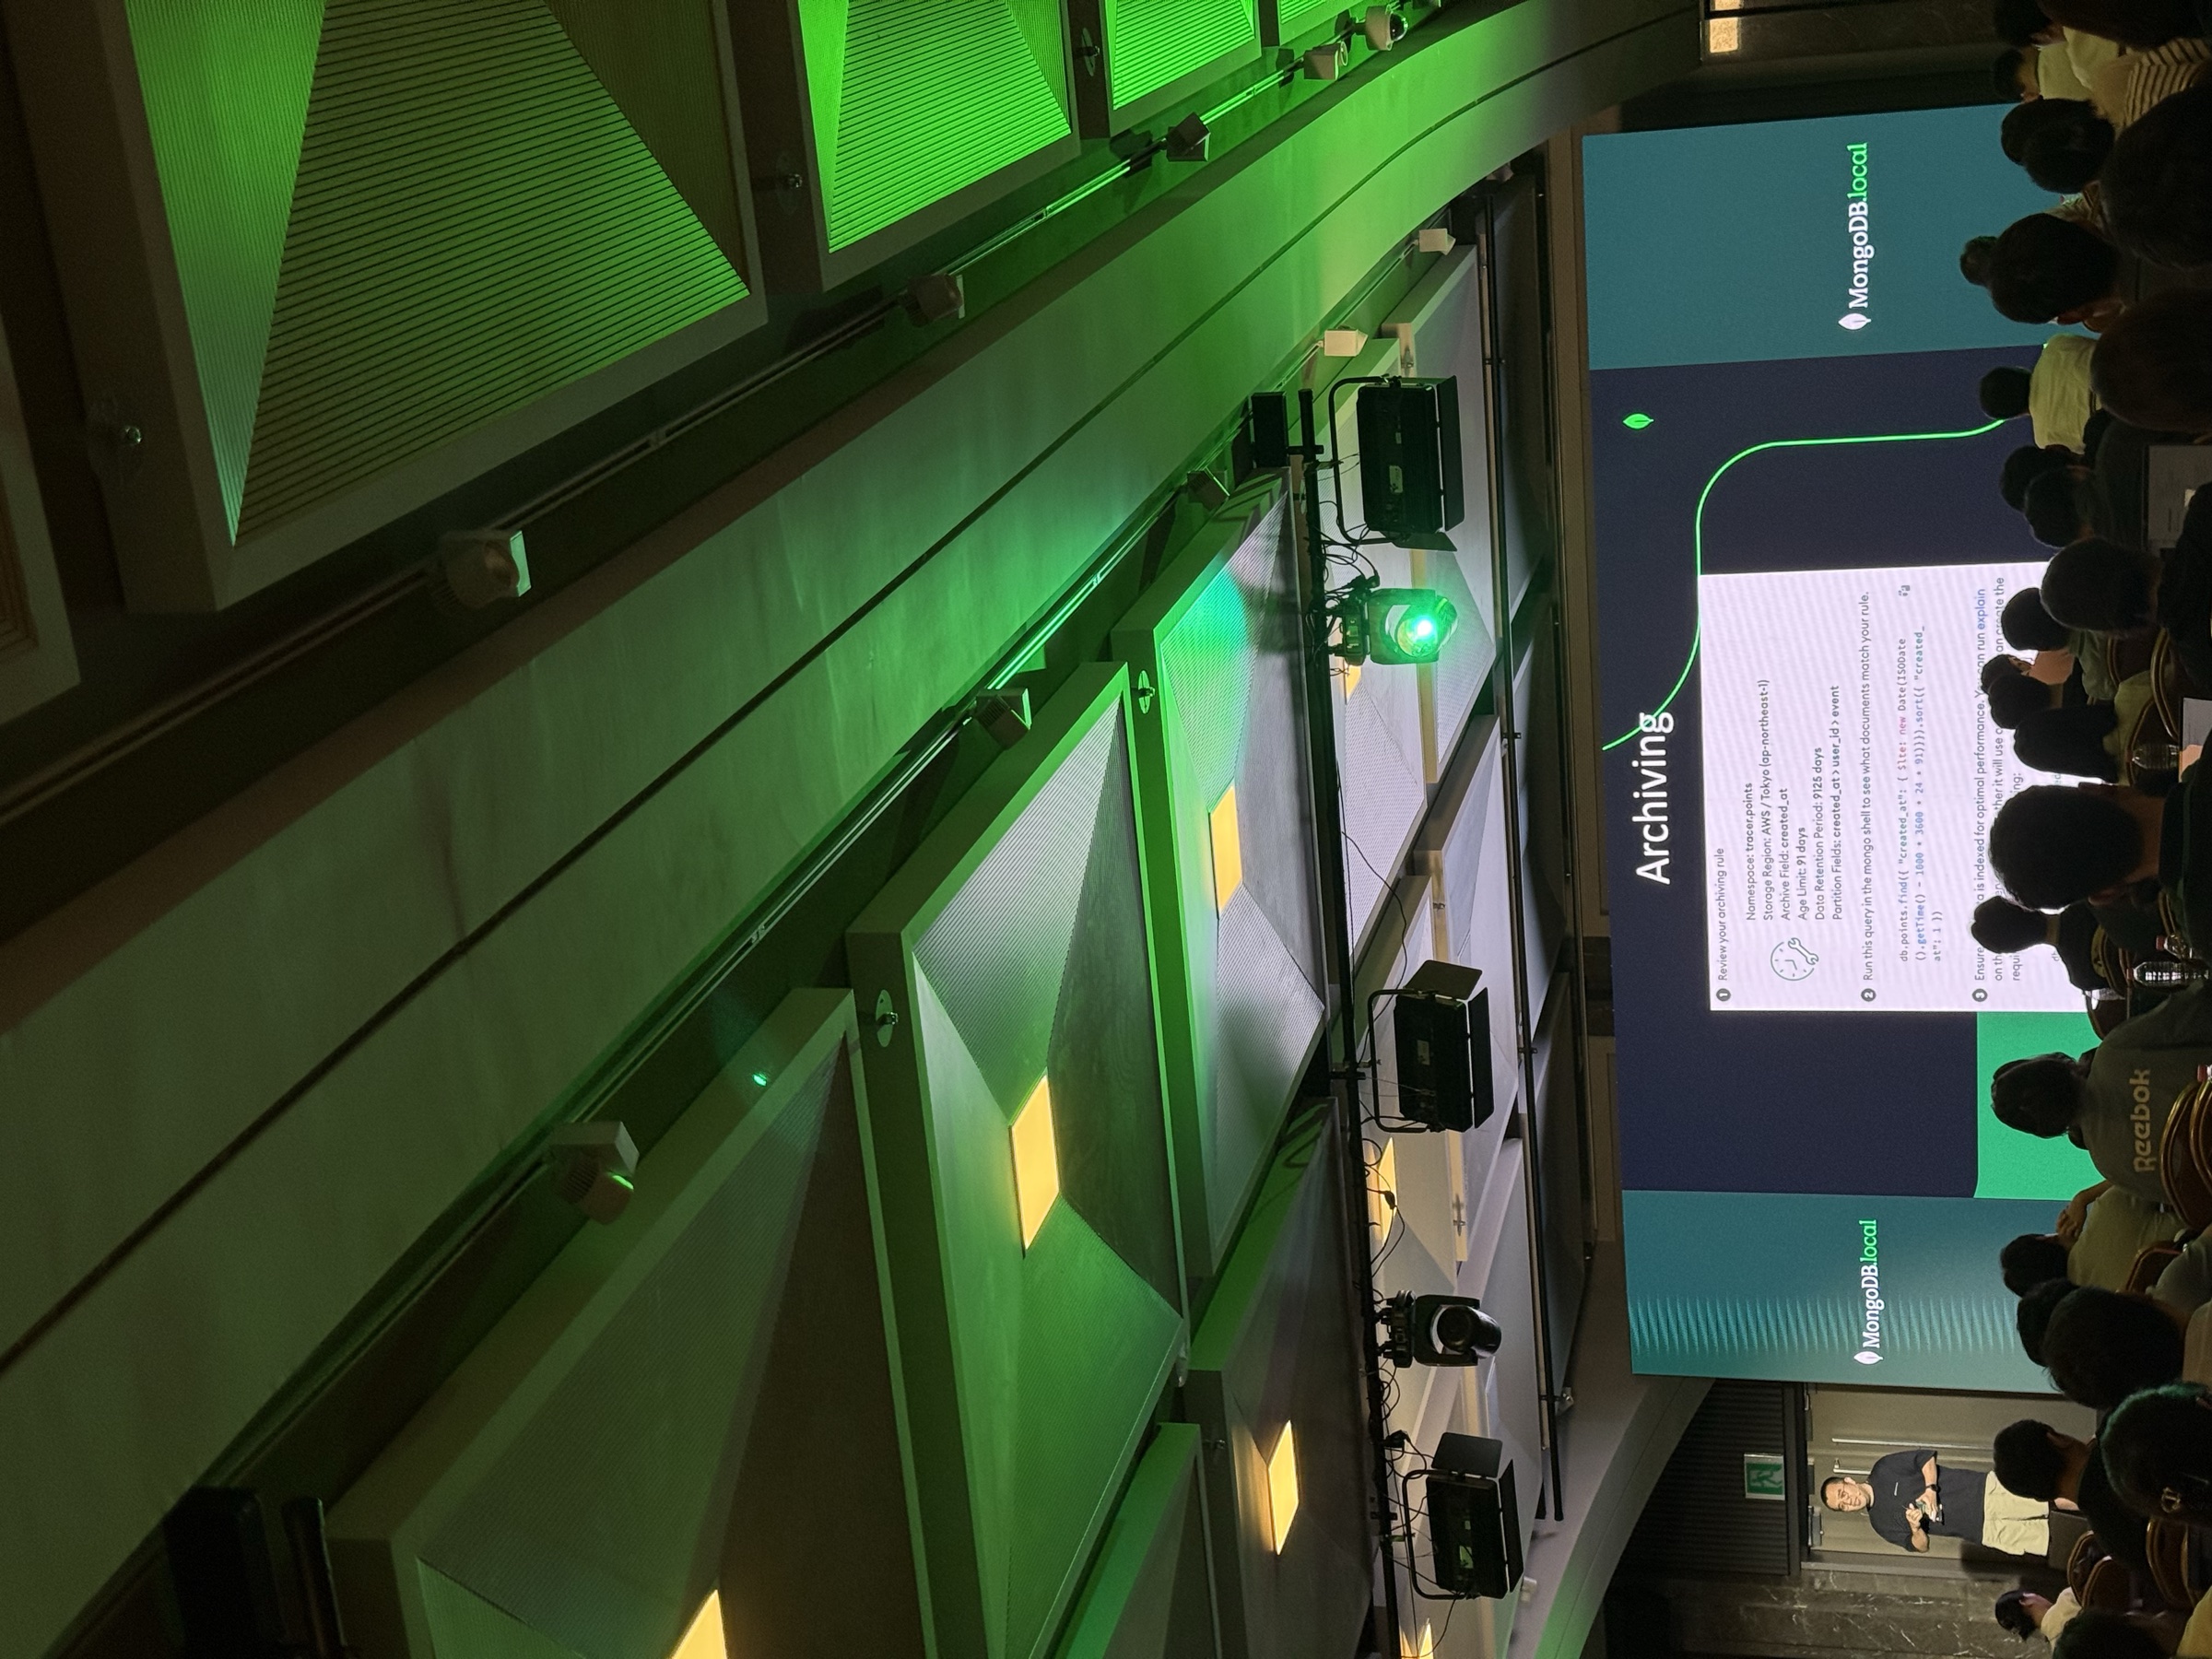
온라인 아카이빙 (Online Archiving) 오래되었거나 접근 빈도가 낮은 데이터를 저렴한 클라우드 스토리지(S3 등)로 자동으로 옮겨주는 기능이다. 이를 통해 DB 운영 비용을 절감하면서도, 아카이브된 데이터를 필요시 계속 조회할 수 있다.
-
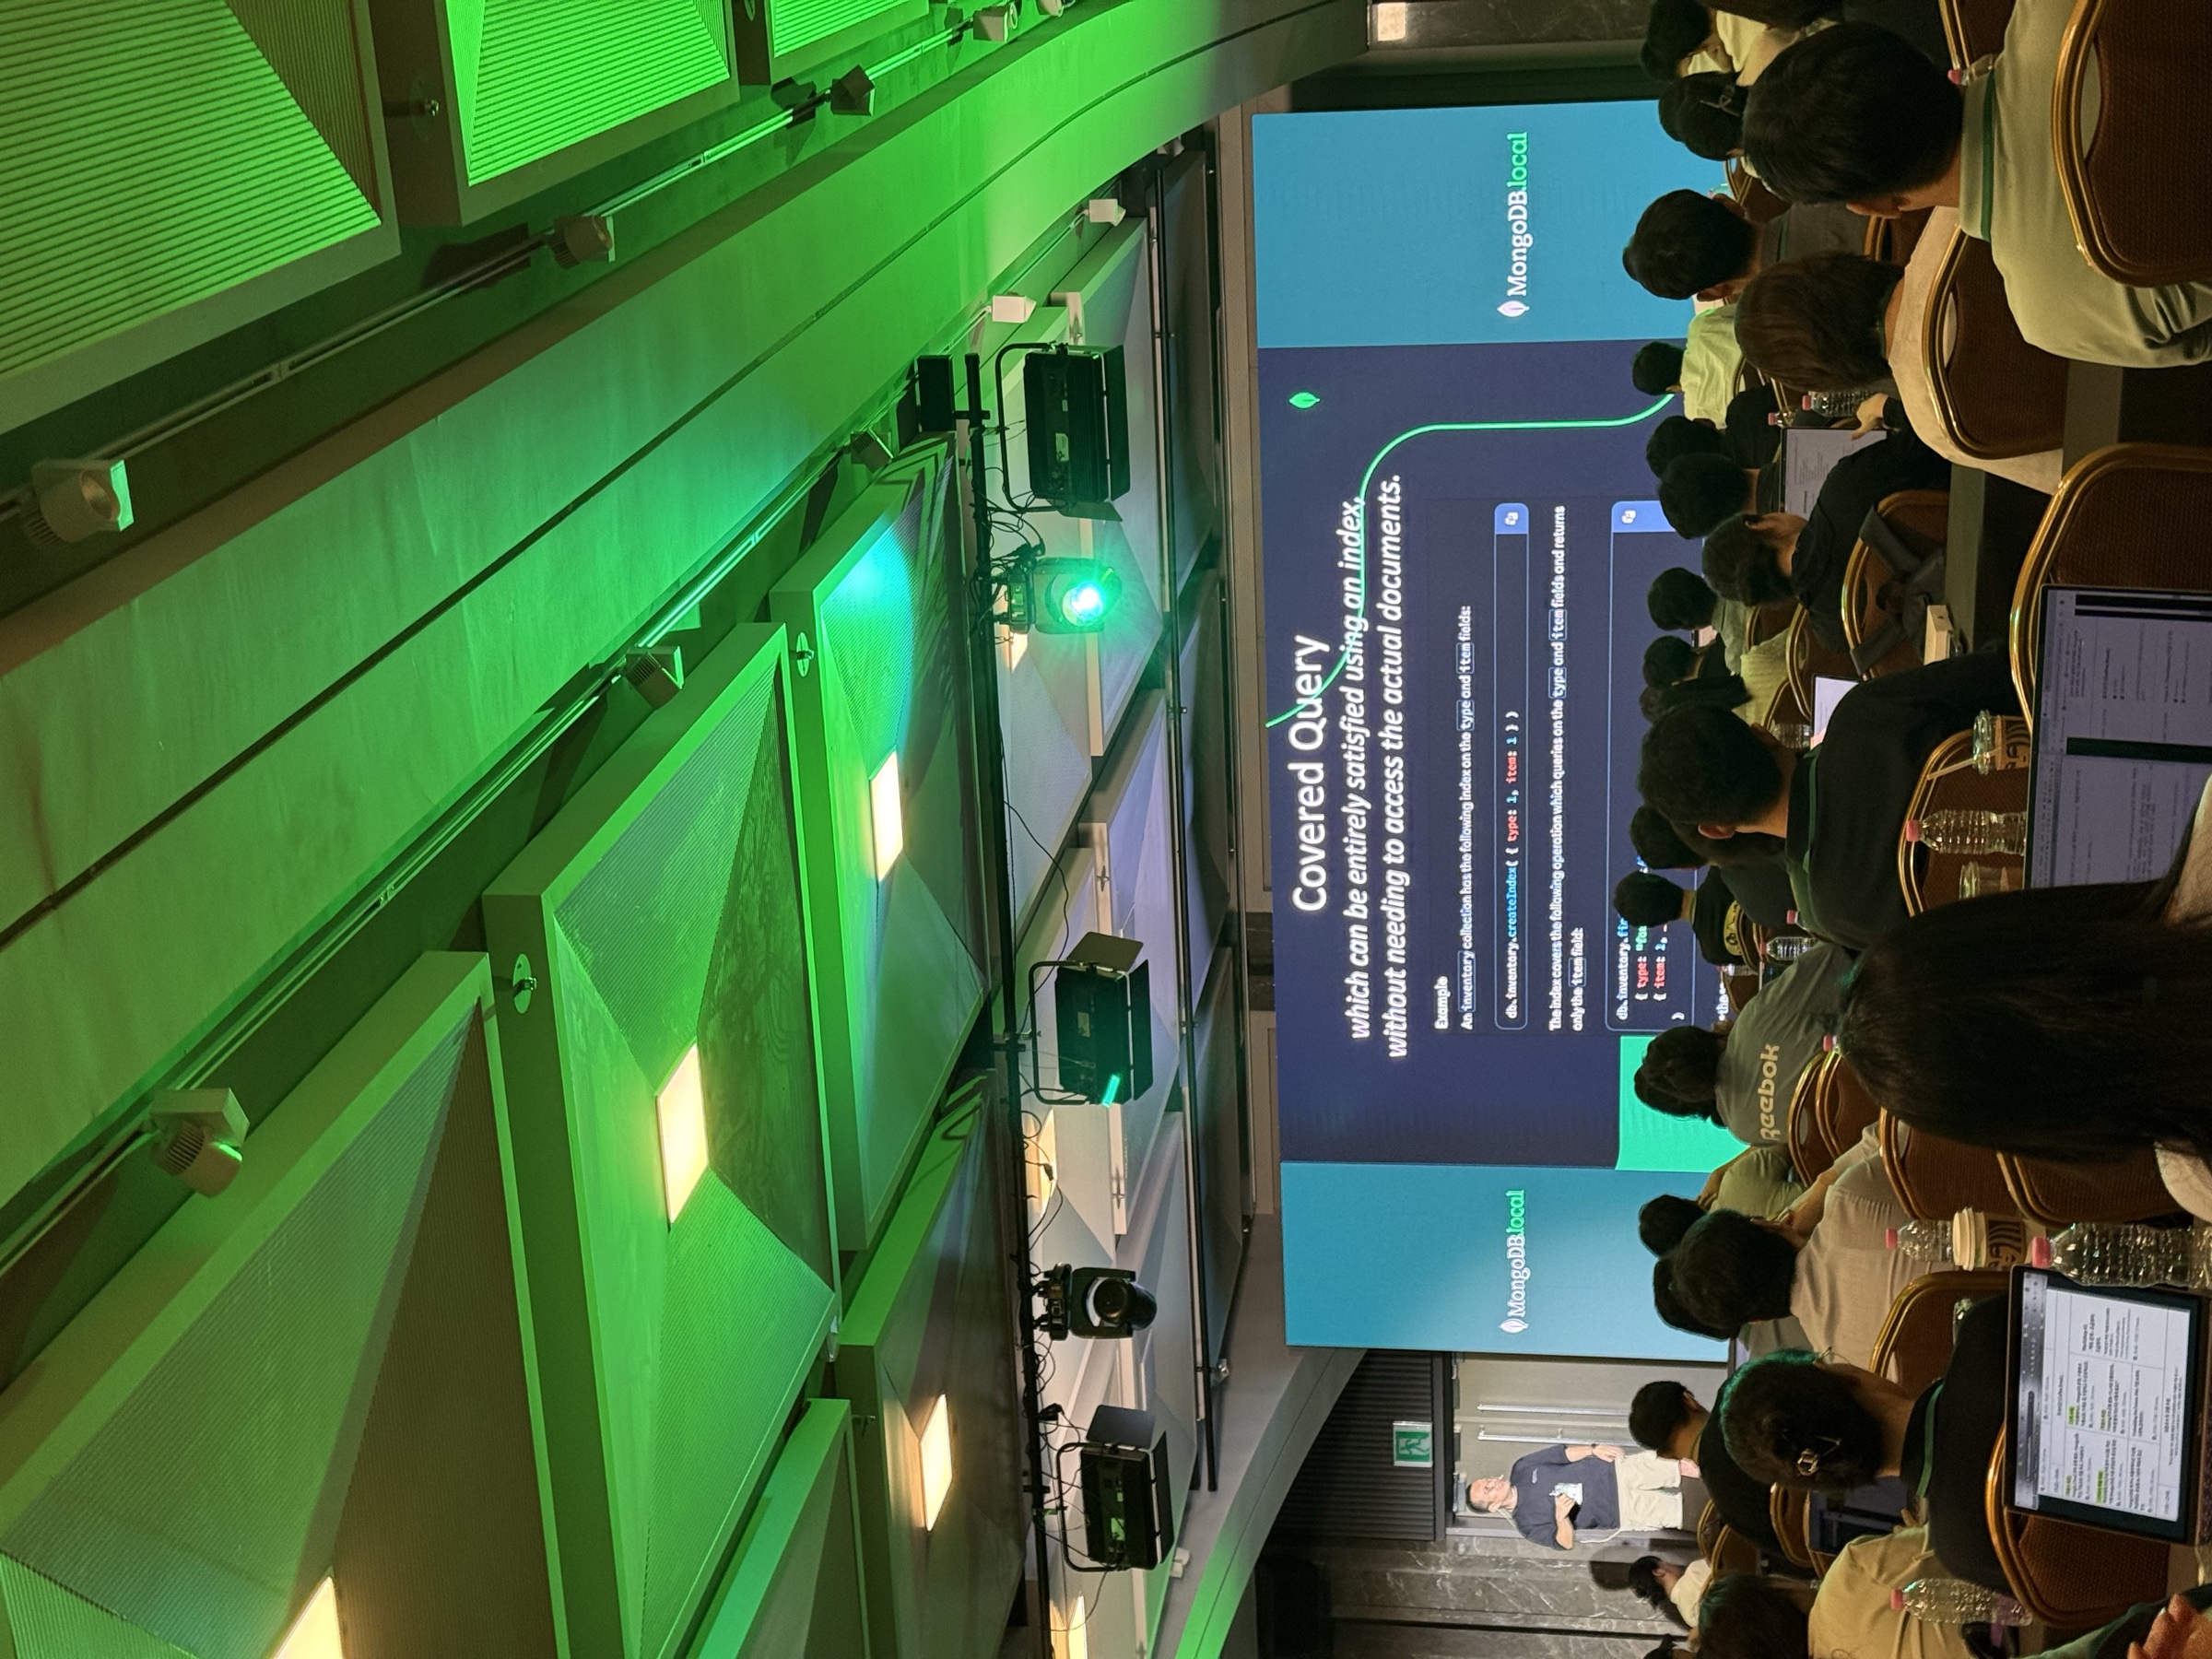
커버드 쿼리 (Covered Query) 쿼리에 필요한 모든 필드가 인덱스에 포함되어 있을 경우, 실제 문서에 접근하지 않고 인덱스만으로 결과를 반환하는 매우 빠른 쿼리 방식이다. 디스크 I/O를 최소화하여 읽기 성능을 극대화할 수 있다.
-
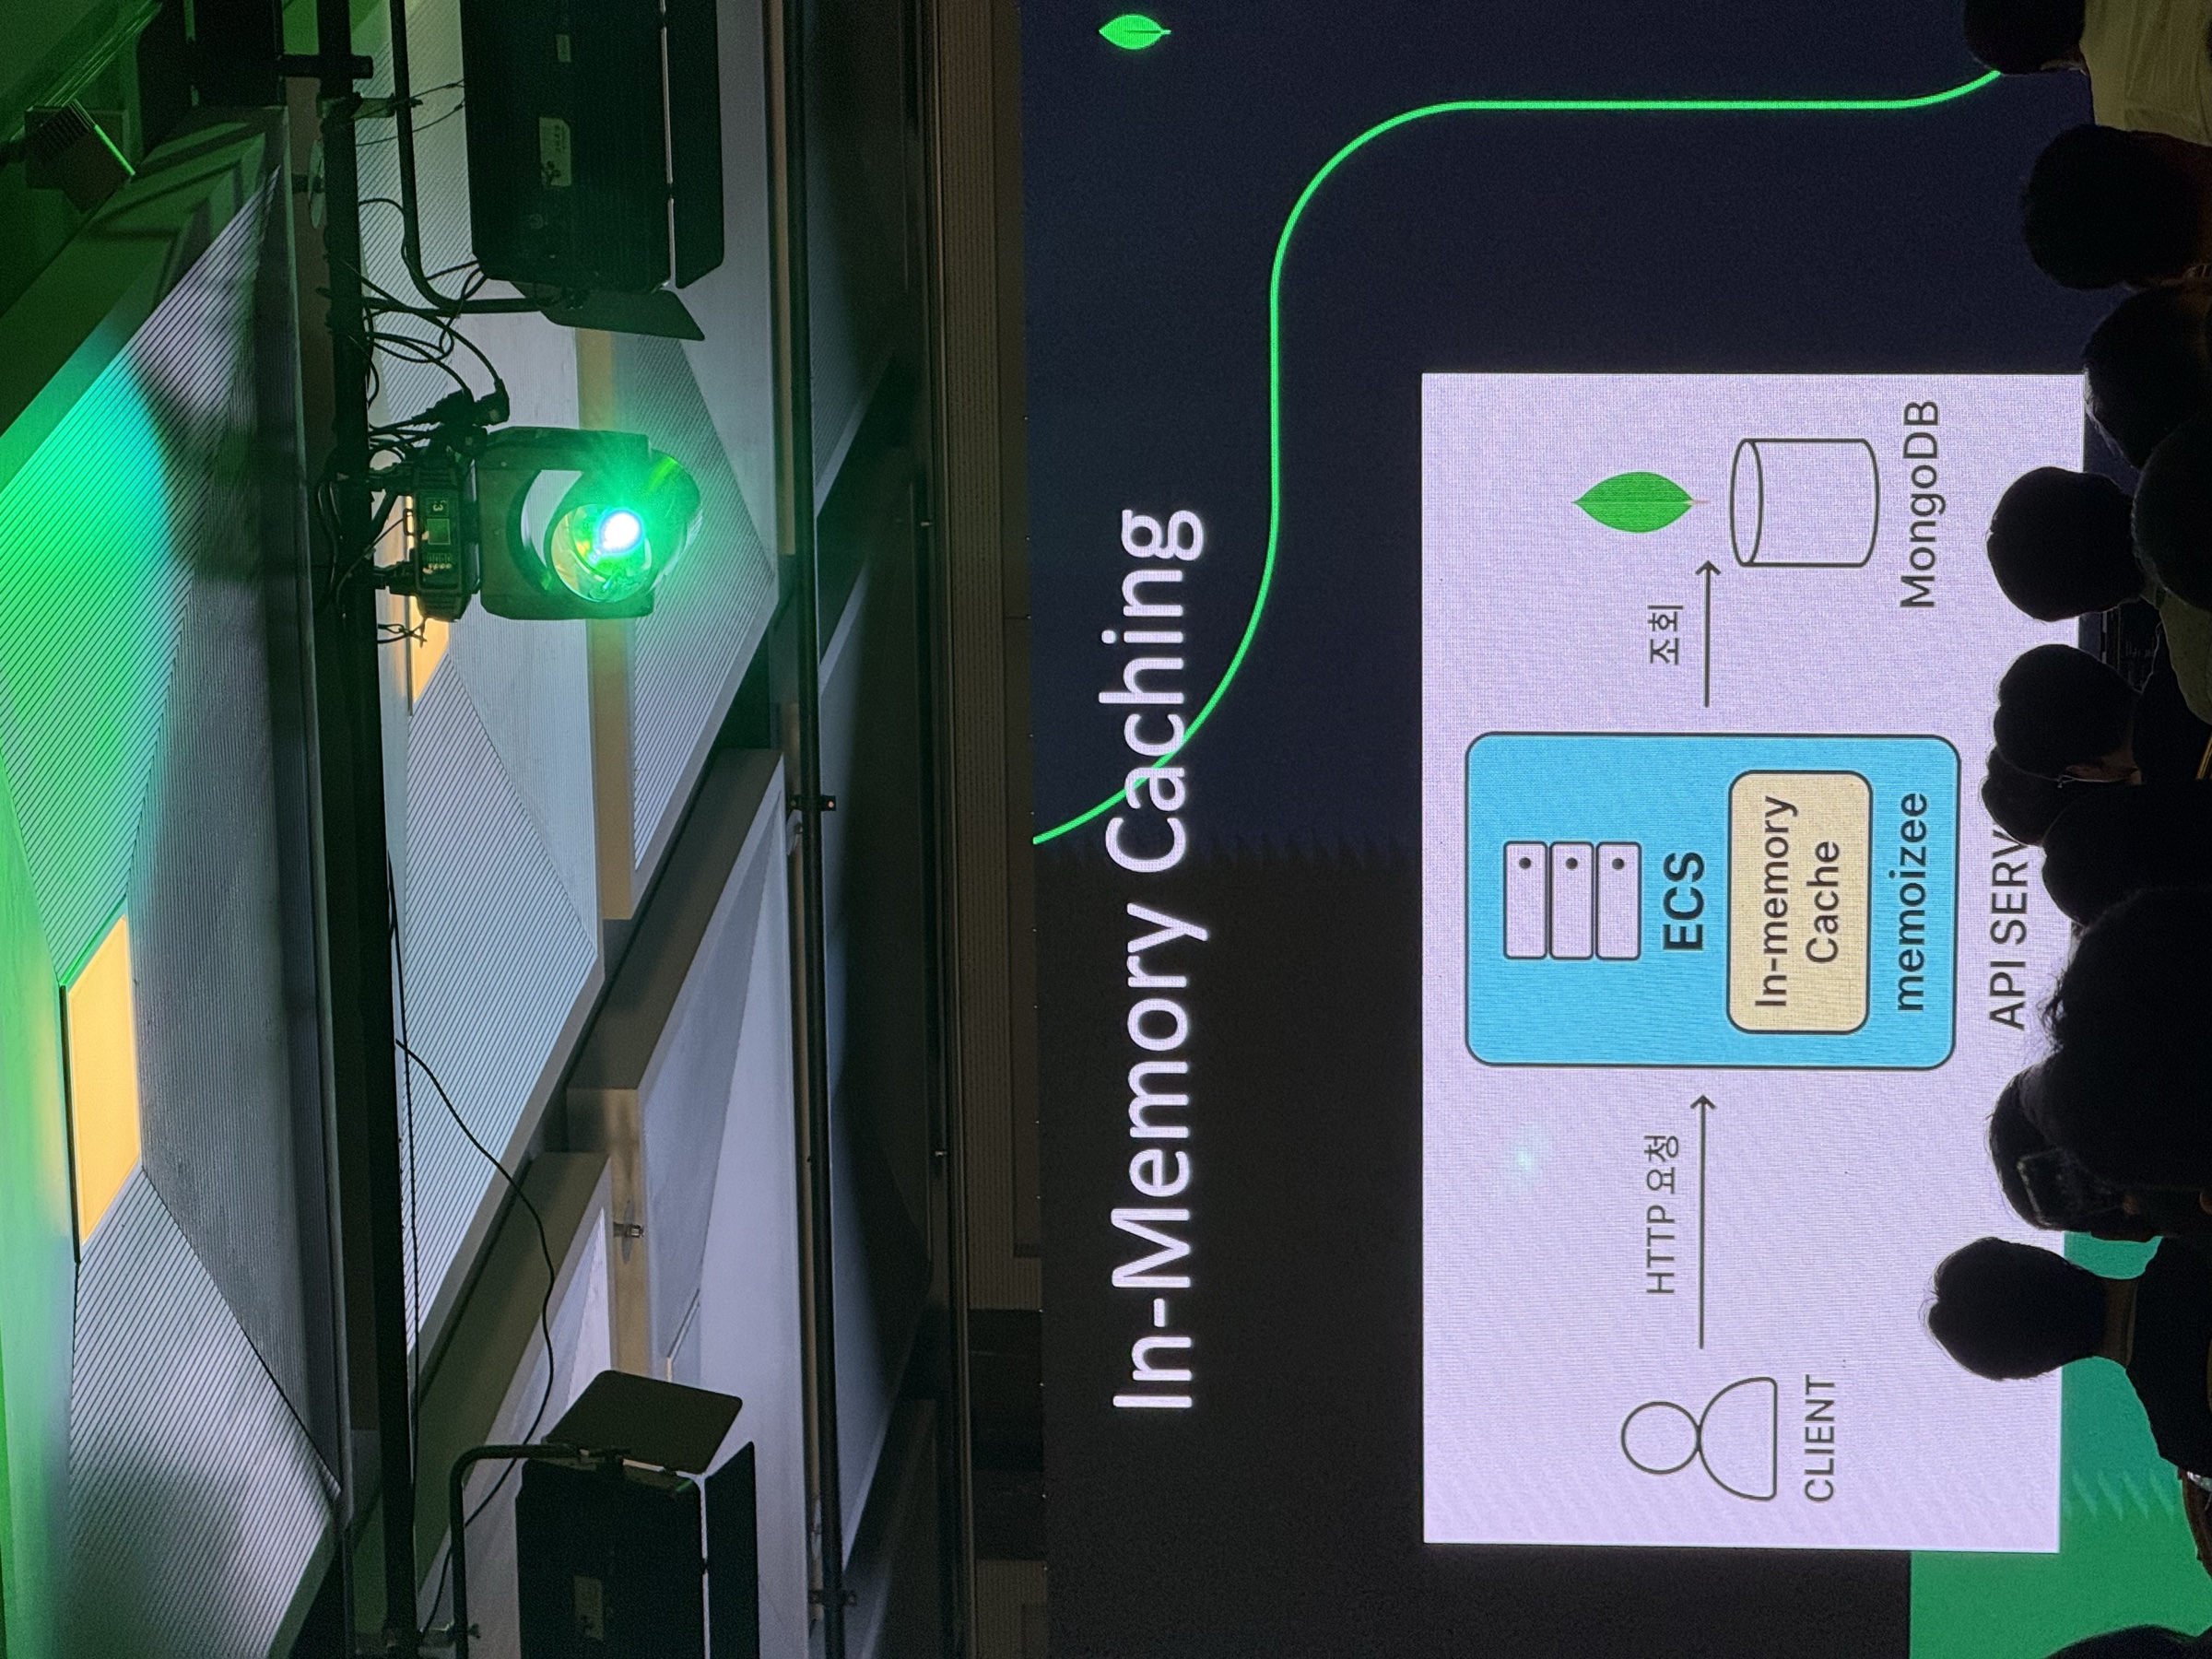
인메모리 캐싱 (In-Memory Caching) 자주 변경되지 않는 설정값이나(즉, 많지는 않지만 가끔 상수형태를 띄는 경우가 있다.)공통 코드 데이터 등은 DB에 매번 요청하는 대신, Node.js 라이브러리 등을 활용해 애플리케이션 메모리에 캐싱하여 DB 부하를 줄인다.
- 벡터 검색 (Vector Search) 이미지나 텍스트를 벡터(Vector)로 변환하여 의미 기반의 유사도 검색을 가능하게 하는 AI 기능이다. 캐시워크에서는 이를 활용하여 이미지 벡터화를 통한 검색 등에 활용하고 있다.